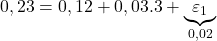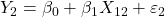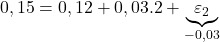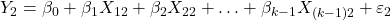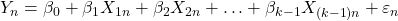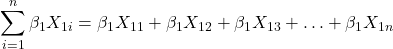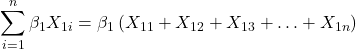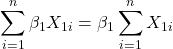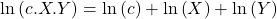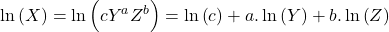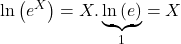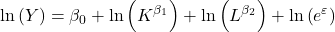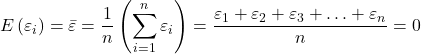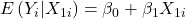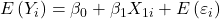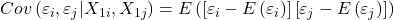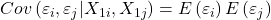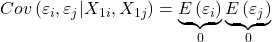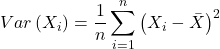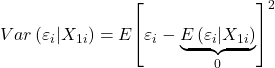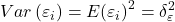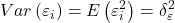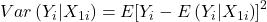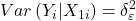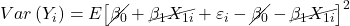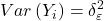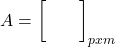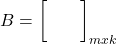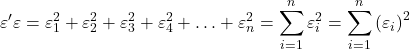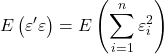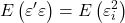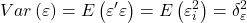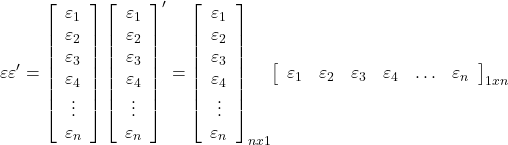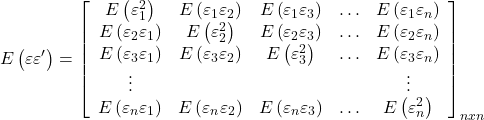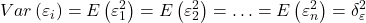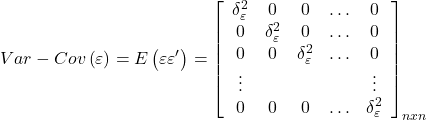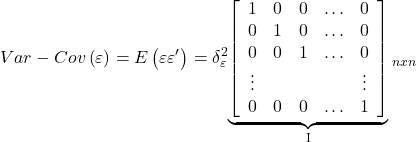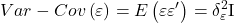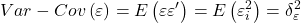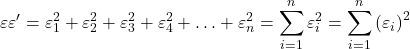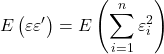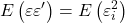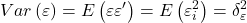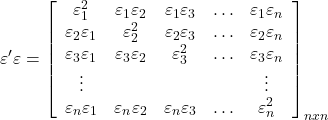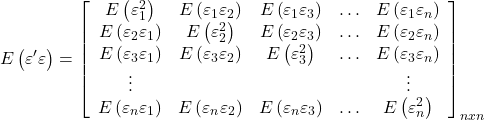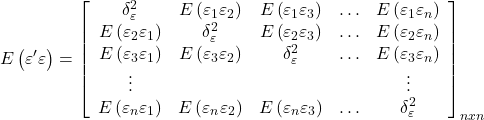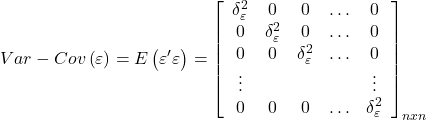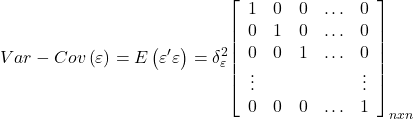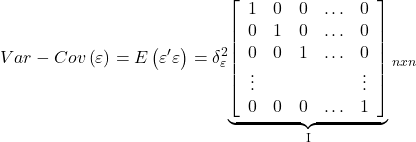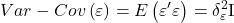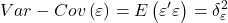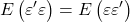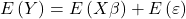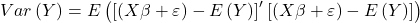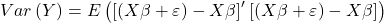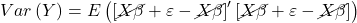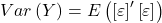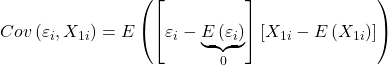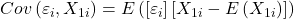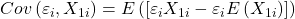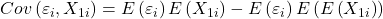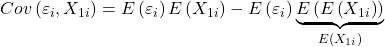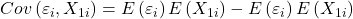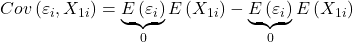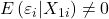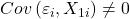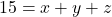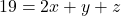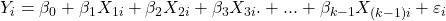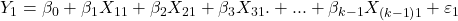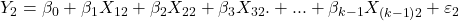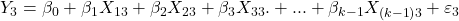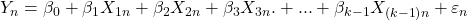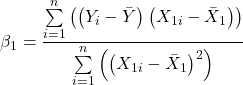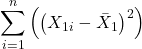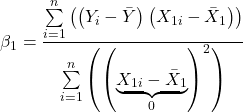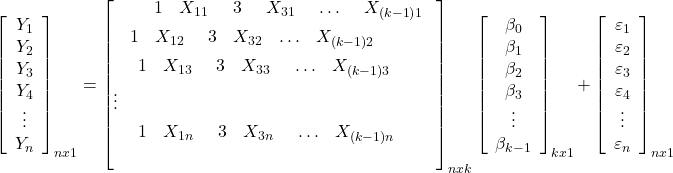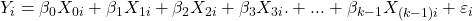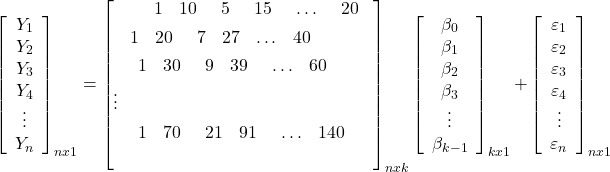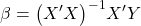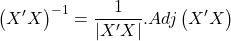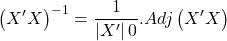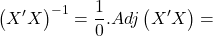
Ekonometrik modeller ağırlıklı olarak regresyon analizine dayanır. Regresyon analizi ise esas olarak en küçük kareler (EKK) yönteminden yararlanılarak elde edilen çıktıların yorumlanması sürecini temsil eder. Ekonometride ve/veya veri biliminde yoğun olarak kullanılan en küçük kareler (ordinary least squares, OLS) yönteminde temel amaç, hata terimlerinin kareleri toplamının minimize edilmesi yoluyla parametreleri tahmin etmektedir. Söz gelimi Y enflasyonu ve
döviz kurunu temsil etmek üzere, döviz kurunda yaşanan değişimlerin enflasyon üzerindeki etkisinin sayısal olarak ölçülmesi amaçlandığında, belirli bir dönem aralığında enflasyon ve döviz kurunun gözlem değerleri elde edilerek aşağıdaki gibi spesifik bir model kurulur.
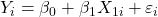
![]()
Yukarıdaki modelde Y enflasyonu (bağımlı/içsel/açıklanan değişkeni),
döviz kurunu (bağımsız/dışsal/açıklayıcı değişkeni) temsil eder. Döviz kuru sıfır iken enflasyonun beklenen değerini temsil eden
(beta sıfır) parametresi sabit terimi, döviz kuru sıfırın dışında bir değer aldığında döviz kurunun enflasyona olan etkisini temsil eden
(beta bir) parametresi döviz kurunun katsayısını ve
(epsilon) ifadesi ise hata terimini temsil etmektedir.
Deterministik kısım olarak adlandırılan Y ve
değerlerinden hareketle, stokastik kısım olarak adlandırılan modelin parametrelerini temsil eden
ve hata terimini temsil eden
değerleri en küçük kareler yöntemi (EKK) ile elde edilir.
ve
değerleri, Y ve
değerlerinin aksine gözlemlenen değerler olmayıp, gözlemlenen değerlerden yola çıkılarak olasılıksal olarak elde edilen istatistiksel değerler olduğundan stokastik ifadelerdir.
Yukarıdaki modelde yer alan (t ile de ifade edilebilen) “i” ifadeleri açıklanan ve açıklayıcı değişkenlerin gözlem sırasını temsil eder. Söz gelimi gözlem sayısı 30 ise, “i” ifadeleri, 1, 2, 3, …, 30 sıra no.lu gözlemleri ifade eder. Gözlem sıralarını temsil eden “i” ifadeleri sadece deterministik kısmı temsil eden açıklanan ve açıklayıcı değişkenler ile stokastik kısımda bulunan
hata terimi ifadelerinde yer alır; Stokastik kısımları temsil eden
parametreleri ve
(epsilon) hata terimi, gözlem değerlerinden hareketle elde edilen istatistiksel değerlerdir.
parametrelerinin 1’den 30’a (n’e) kadar değerleri değişmez. Söz gelimi birinci gözlemde
=0,12,
=0,03 vb. ise ikinci, üçüncü ve otuzuncu (n.inci) gözlemde de değerleri aynıdır. Ancak
hata teriminin birinci, ikinci ve otuzuncu (n.inci) değerleri birbirinden farklı olabilir. Söz gelimi enflasyonu temsil eden Y ifadesinin birinci gözlem değeri 0,23, ikinci gözlem değeri ise 0,15; döviz kurunu temsil eden
ifadesinin birinci gözlem değeri 3, ikinci gözlem değeri ise 2 iken
hata teriminin birinci ve ikinci (hesaplanan) değeri aşağıda gösterilmiştir.
![]()
![]()
![]()
![]()
Yukarıdaki denklemlerden de kolaylıkla anlaşılacağı gibi
ve
parametrelerinin değeri gözlem sırasına göre değişmediği ve her gözlem değerinin birbirinden farklı Y ve
değerleri olduğundan,
hata terimlerinin birden otuza kadar denklemin eşitliğini sağlayan pozitif ve negatif değerleri vardır.
Yukarıdaki modelde birer adet açıklanan ve açıklayıcı değişken, iki parametre ve bir adet de hata terimi vardır. Yukarıdaki modelin k-1 adet açıklayıcı değişken olacak şekilde genişletilmiş formuna da genel doğrusal model denir.
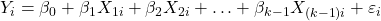
![]()
Yukarıdaki genel doğrusal modelin sabit terimi olduğu için k-1 adet açıklayıcı değişkeni ve sabit terim ile birlikte k adet parametresi vardır. Modeli tahmin etmek için kullanılan açıklanan ve açıklayıcı değişkenlerin gözlem sayısı “n” ve gözlem sırası “i” olmak üzere, “n” adet de (hesaplanan)
hata terimi olacaktır.
Gözlem Sırası | Gözlem Sırasına Göre Genel Doğrusal Model |
i=1 |
|
i=2 |
|
i=3 |
|
|
|
i=n |
|
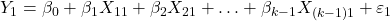
Spesifik bir modelde veya genel doğrusal modelde EKK yönteminin uygulanabilmesi ve sonuçların istatistiki olarak anlamlı olarak yorumlanabilmesi için modelin temel bazı varsayımları sağlaması gerekir.
1. Varsayım:
Modelin parametreleri birer sabit, parametreleri ve hata terimleri ise doğrusal veya doğrusal olarak ifade edilebilir olmalıdır. Bu varsayım regresyon analizinde yararlanılan en küçük kareler yöntemi için son derece kritik bir öneme sahip varsayımlardan biridir.
Modelin parametrelerinin birer sabit olması, genel doğrusal modelden yararlanılarak açıklanabilir.
![]()
“k” modelde bulunan parametre sayısını, “i” gözlem sırasını ve “n” gözlem sayısını temsil etmek üzere, yukarıdaki modele toplam sembolü ilave edilir.
![]()
Yukarıdaki denklemde
,
,
,
gibi alt indisinde gözlem sırasını temsil eden “i” ifadesi olanlar birer sabit değildir. Alt indisinde “i” ifadesi bulunanların, gözlem sayısını temsil eden “n” ifadesine kadar birbirinden farklı değerleri vardır. Alt indisinde “i” ifadesi bulunmayan
,
,
gibi parametrelerin, gözlem sayısını temsil eden “n” ifadesine kadar sadece birer sabit değeri vardır. Örneğin yukarıdaki modelde
parametresinin bulunduğu toplam sembolünün açılımı aşağıdaki gibi olacaktır.
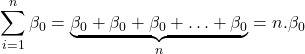
![]()
Farklı bir örnek olarak, yukarıdaki modelde
parametresi ile
değişkeninin bir arada bulunduğu toplam sembolünün açılımı aşağıdaki gibi olacaktır.
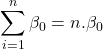
![]()
![]()
![]()
Modelin hata teriminin doğrusal olması ise modelin hata terimine göre kısmi türevinin 1’e eşit olmasını ifade eder.
![]()
![]()
ve
ifadeleri birer matrisi temsil etmek üzere, yukarıdaki ilişki matris formunda aşağıdaki gibi ifade edilebilir.
![]()
Modelin parametrelerinin doğrusal olması ise modelin parametrelerine göre kısmi türevlerinin 1’e eşit veya açıklayıcı değişkenlerinin bir fonksiyonu olmasını ifade eder.
![]()
![]()
![]()
![]()
![]()
![]()
“j” parametre sırasını ve k-1 parametre sayısını temsil etmek üzere, yukarıdaki ilişkiler daha genel olarak aşağıdaki gibi ifade edilebilir.
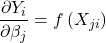
, ![]()
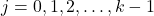
,
ve
ifadeleri birer matrisi temsil etmek üzere, yukarıdaki ilişki matris formunda aşağıdaki gibi ifade edilebilir.
![]()
Eğer aşağıdaki gibi parametreler ve hata terimi açısından doğrusal olmayan (Cobb-Douglass tipi) bir model varsa, EKK yöntemi ile parametre tahmin edicilerini elde etmek için modelin parametreler ve hata terimi açısından doğrusal olarak ifade edilebilir bir forma dönüştürülmesi gerekir.
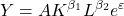
![]()
Parametreler ve hata terimi açısından doğrusal olmayan yukarıdaki modelde A ifadesi sabit terimi, K ve L açıklayıcı/bağımsız değişkenleri, Y açıklanan/bağımlı değişkeni,
ve
sabit olan parametreleri ve
ise hata terimini temsil etmektedir.
Modeli parametreler ve hata terimi açısından doğrusal yapabilmek için modelin her iki tarafının da doğal logaritması (ln) alınır.
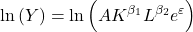
![]()
Not 1.1: a, b ve c birer sabit, X, Y ve Z birer değişken ve e ise eular sabiti olmak üzere doğal logaritma (ln) için aşağıdaki işlem süreçleri tanımlıdır.
|
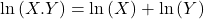
1.1 no.lu nota göre ln ifadesi aşağıdaki gibi parantez içine dağıtılır.
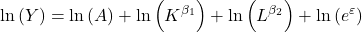
![]()
ifadesinin
gibi bir sabite eşit olduğu kabul edilir.
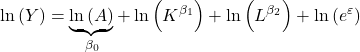
![]()
1.1 no.lu nota göre ln(e) ifadesi 1’e eşittir.
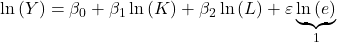
![]()
![]()
Böylece parametreler ve hata terimi açısından doğrusal olmayan bir model, yukarıdaki işlem süreçleri ile doğrusal bir forma dönüştürülmüş olur.
2. Varsayım:
Y açıklanan değişkeni ile
,
gibi açıklayıcı değişkenlerin gözlemlenebilen deterministik değerleri olmalıdır. Y açıklanan değişkeni ile
,
gibi açıklayıcı değişkenlerin deterministik değerleri,
ve
gibi stokastik (olasılıksal) değerlere sahip parametrelerin tahmin edilmesinde kullanılmaktadır.
“j” parametre sırasını ve k-1 parametre sayısını temsil etmek üzere
açıklanan/bağımlı değişkeni,
,
gibi açıklayıcı/bağımsız değişkenlerin bir fonksiyonu olarak tanımlanabilir.
![]()
, ![]()
3. Varsayım:
Hata terimlerinin beklenen değeri/aritmetik ortalaması sıfır olmalıdır. Diğer bir ifadeyle hata terimlerinin
,
gibi açıklayıcı değişkenlere göre koşullu beklenen değeri sıfır olmalıdır. “E” ifadesi beklenen değer operatörünü,
ifadesi hata terimlerinin aritmetik ortalamasını temsil etmek üzere (hata teriminin beklenen değeri ile ortalaması birbirine eşit olup) aşağıdaki varsayımlar geçerli olmalıdır.
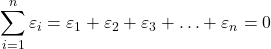
![]()

Hata terimlerinin beklenen değerinin/aritmetik ortalamasının sıfır olması, hata terimlerinin
,
gibi açıklayıcı değişkenlere göre koşullu beklenen değeri çerçevesinde analizi aşağıda sunulmuştur.
![]()
(
’nun beklenen değeri olup
değişkeni belirli bir değer aldığında hata teriminin ortalaması sıfırdır.)
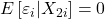
(
’nun beklenen değeri olup
değişkeni belirli bir değer aldığında hata teriminin ortalaması sıfırdır.)
![]()
(
’nun beklenen değeri olup
değişkeni belirli bir değer aldığında hata teriminin ortalaması sıfırdır.)
Aşağıdaki gibi basit bir spesifik model olsun.
(3.1)
Yukarıdaki modelin
ifadesine göre koşullu beklenen değeri aşağıdaki gibi olur.
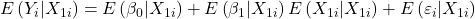
![]()
ve
birer sabit ve bir sabitin beklenen değeri de yine kendisine eşit olduğundan
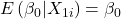
ve
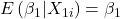
olur.
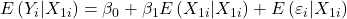
![]()
ifadesinin kendisine göre koşullu beklenen değeri yine kendisine eşit olduğundan
olur.
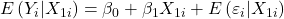
![]()
ifadesinin
ifadesine göre beklenen değeri sıfır, yani
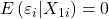
olmalıdır.
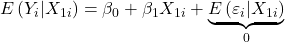
![]()
(3.2)
ifadesi,
değişkeninin
değişkenine göre koşullu beklenen değerini, diğer bir ifadeyle
değişkeni belirli bir değer almışken
değişkeninin alacağı ortalama değeri temsil eder.
Yukarıda koşullu beklenen değer operatörü ile ifade edilen süreç, aşağıdaki gibi doğrudan beklenen değer operatörüyle de temsil edilebilir.
![]()
“E” beklenen değer operatörü ilave edilir.
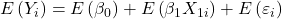
![]()
ve
birer sabit ve bir sabitin beklenen değeri de yine kendisine eşittir.
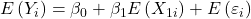
![]()
ifadesinin (kendisine göre koşullu) beklenen değeri yine kendisine eşittir.
Not 3.1: Bu noktada |
![]()
ifadesinin beklenen değeri sıfıra eşittir.
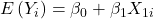
(3.3)
3.2 ve 3.3 no.lu denklemlerin her ikisi de aynı ilişkiyi temsil etmektedir.
4. Varsayım:
Hata terimlerinin ardışık değerleriyle herhangi bir sistematik ilişkisi yoktur; diğer bir ifadeyle kovaryansı sıfır olmalıdır.
ya da ![]()
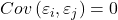
İspat:
![]()
![]()
![]()
![]()
Hata teriminin beklenen değeri sıfıra eşit olduğundan denklemde yerine yazılır.
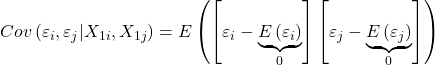
![Rendered by QuickLaTeX.com \displaystyle Cov\left( {{\varepsilon _i},{\varepsilon _j}|{X_{1i}},{X_{1j}}} \right) = E\left( {\left[ {{\varepsilon _i} - \underbrace {E\left( {{\varepsilon _i}} \right)}_0} \right]\left[ {{\varepsilon _j} - \underbrace {E\left( {{\varepsilon _j}} \right)}_0} \right]} \right)](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-02a8e13889c8e50d61a735dfe02a6d2d_l3.png)
![]()
i ve j değerleri birbirine eşit olmadığı için beklenen değer operatörü parantez içine dağıtılır.
![]()
Hata teriminin beklenen değeri sıfıra eşit olduğundan denklemde yerine yazılır.
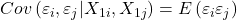
![]()
![]()
Yukarıdaki süreç koşullu beklenen değer operatörü yerine, doğrudan beklenen değer operatörü ile belirtilmek istenirse, eşitliğin solunda yer alan
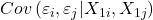
ifadesi yerine, doğrudan
ifadesinin kullanılması yeterli olacaktır.
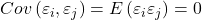
(4.1)
Eğer hata terimlerinin ardışık değerleri birbirinden bağımsız değilse, diğer bir ifadeyle
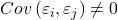
ise “içsel bağıntı (otokorelasyon) sorununun” varlığına işaret eder.
Hata terimlerinin kovaryansının matris formunda ifade edilmesi 5. Varsayım konusunda ele alınacaktır.
5. Varsayım:
Hata teriminin varyansı sabit olmalıdır.
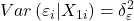
ya da ![]()
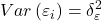
Not 5.1: X bir değişken olmak üzere, X değişkeninin varyansı, kendi beklenen değerinden farklarının karesinin beklenen değerine eşittir.
X değişkeninin varyansı, kendi ortalamasından farklarının karesinin (kitle için) gözlem sayısına (örneklem için n-1’e) bölümü olarak da tanımlanabilir.
|
Hata teriminin varyansının sabit olması aşağıdaki gibi gösterilebilir.
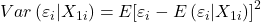
![]()
![Rendered by QuickLaTeX.com \displaystyle Var\left( {{\varepsilon _i}|{X_{1i}}} \right) = E{\left[ {{\varepsilon _i} - \underbrace {E\left( {{\varepsilon _i}|{X_{1i}}} \right)}_0} \right]^2}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-85579aeb8b6dcb0f2f0292c67bdf6dfe_l3.png)
![]()
![]()
Yukarıdaki süreç koşullu beklenen değer operatörü yerine, doğrudan beklenen değer operatörü ile aşağıdaki gibi ifade edilebilir.
![]()
![Rendered by QuickLaTeX.com \displaystyle Var\left( {{\varepsilon _i}} \right) = E{\left[ {{\varepsilon _i} - \underbrace {E\left( {{\varepsilon _i}} \right)}_0} \right]^2}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-5a09e0ca3952f609344e9643b665d1d3_l3.png)
![]()
![]()
ifadesi hata teriminin sabit olan varyansını temsil etmektedir. Hata teriminin varyansı
yerine
veya
ile temsil edilirse, hata teriminin varyansının sabit olmadığı, değişen varyans sorunu olduğu anlamına gelir.
White-Noise (beyaz gürültü veya problemsiz hata) açıklanan değişken Y’nin varyansı ile hata teriminin varyansının birbirine eşit olmasını ifade eder. Söz konusu eşitlik koşullu beklenen değer operatörü yardımıyla aşağıda gösterilmiştir.
![]()
![]()
3.1 ve 3.2 no.lu denklemler yukarıdaki denklemde yerine yazılır.
![Rendered by QuickLaTeX.com \displaystyle Var\left( {{Y_i}|{X_{1i}}} \right) = E{\left[ {\underbrace {{\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}}_{{Y_i}} - \underbrace {\left( {{\beta _0} + {\beta _1}{X_{1i}}} \right)}_{E\left( {{Y_i}|{X_{1i}}} \right)}} \right]^2}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-92c5d7e14a06bef205a5dcf107179a58_l3.png)
![]()
![]()
ifadesi hata teriminin varyansına ve o da
olduğundan denklemde yerine yazılır.
![]()
Açıklanan değişken Y’nin varyansı ile hata teriminin varyansının eşit olmasını temsil eden White-Noise (beyaz gürültü veya problemsiz hata), doğrudan beklenen değer operatörü kullanılarak aşağıda gösterilmiştir.
![]()
3.1 ve 3.3 no.lu denklemler yukarıdaki denklemde yerine yazılır.
![Rendered by QuickLaTeX.com \displaystyle Var\left( {{Y_i}} \right) = E{\left[ {\underbrace {{\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}}_{{Y_i}} - \underbrace {\left( {{\beta _0} + {\beta _1}{X_{1i}}} \right)}_{E\left( {{Y_i}} \right)}} \right]^2}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-d34f9df59315936539d44205c10db8e6_l3.png)
![]()
![]()
ifadesi hata teriminin varyansına ve o da
olduğundan denklemde yerine yazılır.
![]()
,
,
ve
ifadeleri birer matris olmak üzere,
matrisinin nx1 boyutlarında bir sütun vektörü olduğu varsayımında denklem sistemi ve hata teriminin varyansının matris formatında elde edilmesi aşağıda gösterilmiştir.
![Rendered by QuickLaTeX.com \displaystyle \mathop {\left[ {\begin{array}{*{20}{c}} {{Y_1}} \\ {{Y_2}} \\ {{Y_3}} \\ {{Y_4}} \\ \vdots \\ {{Y_n}} \end{array}} \right]}\nolimits_{nx1} = \mathop {\left[ \begin{gathered} \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{11}}} \end{array}}&{{X_{21}}} \end{array}}&{{X_{31}}} \end{array}}& \ldots \end{array}}&{{X_{\left( {k - 1} \right)1}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{12}}} \end{array}}&{{X_{22}}}&{{X_{32}}}& \ldots &{{X_{\left( {k - 1} \right)2}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{13}}} \end{array}}&{{X_{23}}}&{{X_{33}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)3}}} \end{array} \hfill \\ \vdots \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{1n}}} \end{array}}&{{X_{2n}}}&{{X_{3n}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)n}}} \end{array} \hfill \\ \end{gathered} \right]}\nolimits_{nxk} \mathop {\left[ {\begin{array}{*{20}{c}} {{\beta _0}} \\ {{\beta _1}} \\ {{\beta _2}} \\ {{\beta _3}} \\ \vdots \\ {{\beta _{k - 1}}} \end{array}} \right]}\nolimits_{kx1} + \mathop {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]}\nolimits_{nx1}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-8c0710bdb5fe4a25cabd6d633c7d3613_l3.png)
Not 5.2: Bir matrisin transpozunu (devriğini) almak, o matrisin satırlarının sütun, sütunlarının da satır biçiminde ifade edilmesi anlamına gelir. A ve B birer matris olmak üzere, A ve B matrislerinde AB biçiminde çarpma işlemi yapmak için soldaki ifadenin (A’nın) sütun sayısı sağdaki ifadenin (B’nin) satır sayısına eşit olmalıdır. Yeni matrisin boyutu da birinci matrisin (A’nın) satır sayısı ile ikinci matrisin (B’nin) sütun sayısına eşit olacaktır.
|
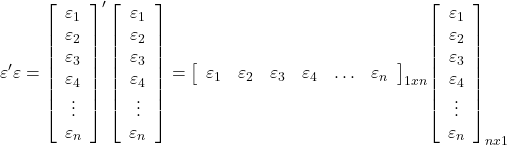
matrisinin nx1 boyutlarında bir sütun vektörü olduğu varsayımı altında,
matrisinin soldan kendi transpozu ile çarpılması sonucu,
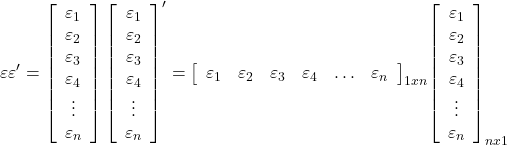
ifadesi 1×1 boyutlu bir skaler (yani c gibi sayısal bir) değeri olan hata terimlerinin kareleri toplamını verecektir.
![Rendered by QuickLaTeX.com \displaystyle \varepsilon '\varepsilon = {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]^\prime }\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right] = {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}}&{{\varepsilon _2}}&{{\varepsilon _3}}&{{\varepsilon _4}}& \ldots &{{\varepsilon _n}} \end{array}} \right]_{1xn}}{\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]_{nx1}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-22beb36c93f9356cdb750073a406d151_l3.png)
![]()
Yukarıdaki ifadeye beklenen değer operatörü ilave edilirse hata teriminin varyansı elde edilir.

ifadesi beklenen değer operatörü ile toplam sembolü kullanılmadan da ifade edilebilir.
![]()
![]()
matrisinin nx1 boyutlarında bir sütun vektörü olduğu varsayımı altında,
matrisinin sağdan kendi transpozu ile çarpılması sonucu,
ifadesi nxn boyutlu bir kare matris olan varyans-kovaryans matrisini verecektir.
![Rendered by QuickLaTeX.com \displaystyle \varepsilon \varepsilon ' = \left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]{\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]^\prime } = {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]_{nx1}}{\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}}&{{\varepsilon _2}}&{{\varepsilon _3}}&{{\varepsilon _4}}& \ldots &{{\varepsilon _n}} \end{array}} \right]_{1xn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-369d5eae22b4fee8c8bbbc2eb7f0c93c_l3.png)
![Rendered by QuickLaTeX.com \displaystyle \varepsilon \varepsilon ' = {\left[ {\begin{array}{*{20}{c}} {\varepsilon _1^2}&{{\varepsilon _1}{\varepsilon _2}}&{{\varepsilon _1}{\varepsilon _3}}& \ldots &{{\varepsilon _1}{\varepsilon _n}} \\ {{\varepsilon _2}{\varepsilon _1}}&{\varepsilon _2^2}&{{\varepsilon _2}{\varepsilon _3}}& \ldots &{{\varepsilon _2}{\varepsilon _n}} \\ {{\varepsilon _3}{\varepsilon _1}}&{{\varepsilon _3}{\varepsilon _2}}&{\varepsilon _3^2}& \ldots &{{\varepsilon _3}{\varepsilon _n}} \\ \vdots &{}&{}&{}& \vdots \\ {{\varepsilon _n}{\varepsilon _1}}&{{\varepsilon _n}{\varepsilon _2}}&{{\varepsilon _n}{\varepsilon _3}}& \ldots &{\varepsilon _n^2} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-a443098bfdae1a6207fa714987fe9f59_l3.png)
Yukarıdaki matrisin içinde yer alan
,
,
, …,
ifadeleri matrisin asal köşegenini temsil eder. Matrise beklenen değer operatörü ilave edilerek matrisin içine dağıtılır.
![Rendered by QuickLaTeX.com \displaystyle E\left( {\varepsilon \varepsilon '} \right) = {\left[ {\begin{array}{*{20}{c}} {E\left( {\varepsilon _1^2} \right)}&{E\left( {{\varepsilon _1}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _1}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _1}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _2}{\varepsilon _1}} \right)}&{E\left( {\varepsilon _2^2} \right)}&{E\left( {{\varepsilon _2}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _2}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _3}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _3}{\varepsilon _2}} \right)}&{E\left( {\varepsilon _3^2} \right)}& \ldots &{E\left( {{\varepsilon _3}{\varepsilon _n}} \right)} \\ \vdots &{}&{}&{}& \vdots \\ {E\left( {{\varepsilon _n}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _3}} \right)}& \ldots &{E\left( {\varepsilon _n^2} \right)} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-79ec2e8b01b3c072e86c91c5aeefa5f3_l3.png)
ve hata teriminin varyansı sabit olduğundan
olur ve matrisin asal köşegeninde yerlerine yazılır.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon \varepsilon '} \right) = {\left[ {\begin{array}{*{20}{c}} {\delta _\varepsilon ^2}&{E\left( {{\varepsilon _1}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _1}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _1}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _2}{\varepsilon _1}} \right)}&{\delta _\varepsilon ^2}&{E\left( {{\varepsilon _2}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _2}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _3}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _3}{\varepsilon _2}} \right)}&{\delta _\varepsilon ^2}& \ldots &{E\left( {{\varepsilon _3}{\varepsilon _n}} \right)} \\ \vdots &{}&{}&{}& \vdots \\ {E\left( {{\varepsilon _n}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _3}} \right)}& \ldots &{\delta _\varepsilon ^2} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-cee7f339c9ee117369563f9e48f788c6_l3.png)
Yukarıda 4.1 no.lu denklemde
olduğundan, yukarıdaki matriste yer alan kovaryans ifadelerinin yerine sıfır yazılır.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon \varepsilon '} \right) = {\left[ {\begin{array}{*{20}{c}} {\delta _\varepsilon ^2}&0&0& \ldots &0 \\ 0&{\delta _\varepsilon ^2}&0& \ldots &0 \\ 0&0&{\delta _\varepsilon ^2}& \ldots &0 \\ \vdots &{}&{}&{}& \vdots \\ 0&0&0& \ldots &{\delta _\varepsilon ^2} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-6b11a6cc2305ae7992415c5f5dff9dd5_l3.png)
ifadeleri birer sabit olduğundan matrisin dışına alınır.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon \varepsilon '} \right) = \delta _\varepsilon ^2{\left[ {\begin{array}{*{20}{c}} 1&0&0& \ldots &0 \\ 0&1&0& \ldots &0 \\ 0&0&1& \ldots &0 \\ \vdots &{}&{}&{}& \vdots \\ 0&0&0& \ldots &1 \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-f5e0d48824126fec3f53b3bd951dddc0_l3.png)
Yukarıda nxn boyutlu asal köşegeni 1, diğer elemanları 0 değerlerinden oluşan matris birim matrise eşittir ve birim matris de 1’e eşit bir skalerdir.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon \varepsilon '} \right) = \delta _\varepsilon ^2{\underbrace {\left[ {\begin{array}{*{20}{c}} 1&0&0& \ldots &0 \\ 0&1&0& \ldots &0 \\ 0&0&1& \ldots &0 \\ \vdots &{}&{}&{}& \vdots \\ 0&0&0& \ldots &1 \end{array}} \right]}_{\rm I}_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-b25919c6b6952e9f1c7060da0d587b9d_l3.png)
![]()
![]()
Yukarıda gösterildiği gibi
matrisinin nx1 boyutlarında bir sütun vektörü olduğu varsayımı altında, 1×1 boyutlu
matrisinin yanı sıra, nxn boyutlu varyans-kovaryans matrisini temsil eden
matrisinin de
varsayımı geçerli iken hata teriminin varyansını temsil eden skaler (tek bir sayısal) bir sonucu vardır.
![]()
![]()
Yukarıda
matrisinin denklem sisteminde nx1 boyutlu bir sütun vektörü olarak yer aldığı varsayılmak suretiyle hata terimlerinin varyansı ve varyans-kovaryans matrisi elde edildi.
matrisinin denklem sisteminde 1xn boyutlu bir satır vektörü olarak yer alsaydı da yukarıda varılan sonuçlara yine varılabilirdi. Şöyle ki;
,
,
ve
ifadeleri birer matris olmak üzere,
matrisinin nx1 boyutlarında bir satır vektörü olduğu varsayımında denklem sistemi ve hata teriminin varyansının matris formatında elde edilmesi aşağıda gösterilmiştir.
![Rendered by QuickLaTeX.com \displaystyle \mathop {\left[ {\begin{array}{*{20}{c}} {{Y_1}} \\ {{Y_2}} \\ {{Y_3}} \\ {{Y_4}} \\ \vdots \\ {{Y_n}} \end{array}} \right]}\nolimits_{nx1} = \mathop {\left[ \begin{gathered} \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{11}}} \end{array}}&{{X_{21}}} \end{array}}&{{X_{31}}} \end{array}}& \ldots \end{array}}&{{X_{\left( {k - 1} \right)1}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{12}}} \end{array}}&{{X_{22}}}&{{X_{32}}}& \ldots &{{X_{\left( {k - 1} \right)2}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{13}}} \end{array}}&{{X_{23}}}&{{X_{33}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)3}}} \end{array} \hfill \\ \vdots \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{1n}}} \end{array}}&{{X_{2n}}}&{{X_{3n}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)n}}} \end{array} \hfill \\ \end{gathered} \right]}\nolimits_{nxk} \mathop {\left[ {\begin{array}{*{20}{c}} {{\beta _0}} \\ {{\beta _1}} \\ {{\beta _2}} \\ {{\beta _3}} \\ \vdots \\ {{\beta _{k - 1}}} \end{array}} \right]}\nolimits_{kx1} + \mathop {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}}&{{\varepsilon _2}}&{{\varepsilon _3}}&{{\varepsilon _4}}& \ldots &{{\varepsilon _n}} \end{array}} \right]}\nolimits_{nx1}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-c6f65d0b46e68cb5b07d1a25fcb391ad_l3.png)
matrisinin 1xn boyutlarında bir satır vektörü olduğu varsayımı altında,
matrisinin sağdan kendi transpozu ile çarpılması sonucu,
ifadesi 1×1 boyutlu bir skaler (yani c gibi sayısal bir) değeri olan hata terimlerinin kareleri toplamını verecektir.
![Rendered by QuickLaTeX.com \displaystyle \varepsilon \varepsilon ' = \left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]{\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]^\prime } = {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}}&{{\varepsilon _2}}&{{\varepsilon _3}}&{{\varepsilon _4}}& \ldots &{{\varepsilon _n}} \end{array}} \right]_{1xn}}{\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]_{nx1}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-baa5af513cc09ab5de5ab774657f6c64_l3.png)
![]()
Yukarıdaki ifadeye beklenen değer operatörü ilave edilirse hata teriminin varyansı elde edilir.

ifadesi beklenen değer operatörü ile toplam sembolü kullanılmadan da ifade edilebilir.
![]()
![]()
matrisinin 1xn boyutlarında bir satır vektörü olduğu varsayımı altında,
matrisinin soldan kendi transpozu ile çarpılması sonucu,
ifadesi nxn boyutlu bir kare matris olan varyans-kovaryans matrisini verecektir.
![Rendered by QuickLaTeX.com \displaystyle \varepsilon '\varepsilon = {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]^\prime }\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right] = {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]_{nx1}}{\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}}&{{\varepsilon _2}}&{{\varepsilon _3}}&{{\varepsilon _4}}& \ldots &{{\varepsilon _n}} \end{array}} \right]_{1xn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-c716f162b78aaa77124ff2d0b842d953_l3.png)
![Rendered by QuickLaTeX.com \displaystyle \varepsilon '\varepsilon = {\left[ {\begin{array}{*{20}{c}} {\varepsilon _1^2}&{{\varepsilon _1}{\varepsilon _2}}&{{\varepsilon _1}{\varepsilon _3}}& \ldots &{{\varepsilon _1}{\varepsilon _n}} \\ {{\varepsilon _2}{\varepsilon _1}}&{\varepsilon _2^2}&{{\varepsilon _2}{\varepsilon _3}}& \ldots &{{\varepsilon _2}{\varepsilon _n}} \\ {{\varepsilon _3}{\varepsilon _1}}&{{\varepsilon _3}{\varepsilon _2}}&{\varepsilon _3^2}& \ldots &{{\varepsilon _3}{\varepsilon _n}} \\ \vdots &{}&{}&{}& \vdots \\ {{\varepsilon _n}{\varepsilon _1}}&{{\varepsilon _n}{\varepsilon _2}}&{{\varepsilon _n}{\varepsilon _3}}& \ldots &{\varepsilon _n^2} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-1f387b5d4d71960b31e24bd307d1a501_l3.png)
Yukarıdaki matrisin içinde yer alan
,
,
, …,
ifadeleri matrisin asal köşegenini temsil eder. Matrise beklenen değer operatörü ilave edilerek matrisin içine dağıtılır.
![Rendered by QuickLaTeX.com \displaystyle E\left( {\varepsilon '\varepsilon } \right) = {\left[ {\begin{array}{*{20}{c}} {E\left( {\varepsilon _1^2} \right)}&{E\left( {{\varepsilon _1}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _1}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _1}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _2}{\varepsilon _1}} \right)}&{E\left( {\varepsilon _2^2} \right)}&{E\left( {{\varepsilon _2}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _2}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _3}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _3}{\varepsilon _2}} \right)}&{E\left( {\varepsilon _3^2} \right)}& \ldots &{E\left( {{\varepsilon _3}{\varepsilon _n}} \right)} \\ \vdots &{}&{}&{}& \vdots \\ {E\left( {{\varepsilon _n}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _3}} \right)}& \ldots &{E\left( {\varepsilon _n^2} \right)} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-e3ee6db6ec0ba93f2fd70965d63ffa0b_l3.png)
ve hata teriminin varyansı sabit olduğundan
olur ve matrisin asal köşegeninde yerlerine yazılır.
![Rendered by QuickLaTeX.com \displaystyle E\left( {\varepsilon '\varepsilon } \right) = {\left[ {\begin{array}{*{20}{c}} {\delta _\varepsilon ^2}&{E\left( {{\varepsilon _1}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _1}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _1}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _2}{\varepsilon _1}} \right)}&{\delta _\varepsilon ^2}&{E\left( {{\varepsilon _2}{\varepsilon _3}} \right)}& \ldots &{E\left( {{\varepsilon _2}{\varepsilon _n}} \right)} \\ {E\left( {{\varepsilon _3}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _3}{\varepsilon _2}} \right)}&{\delta _\varepsilon ^2}& \ldots &{E\left( {{\varepsilon _3}{\varepsilon _n}} \right)} \\ \vdots &{}&{}&{}& \vdots \\ {E\left( {{\varepsilon _n}{\varepsilon _1}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _2}} \right)}&{E\left( {{\varepsilon _n}{\varepsilon _3}} \right)}& \ldots &{\delta _\varepsilon ^2} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-fa1ed03da05be33ebcdf3e2a27e2df28_l3.png)
Yukarıda 4.1 no.lu denklemde
olduğundan, yukarıdaki matriste yer alan kovaryans ifadelerinin yerine sıfır yazılır.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon '\varepsilon } \right) = {\left[ {\begin{array}{*{20}{c}} {\delta _\varepsilon ^2}&0&0& \ldots &0 \\ 0&{\delta _\varepsilon ^2}&0& \ldots &0 \\ 0&0&{\delta _\varepsilon ^2}& \ldots &0 \\ \vdots &{}&{}&{}& \vdots \\ 0&0&0& \ldots &{\delta _\varepsilon ^2} \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-f85bfb998d276be920704d86dd8c3b98_l3.png)
ifadeleri birer sabit olduğundan matrisin dışına alınır.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon '\varepsilon } \right) = \delta _\varepsilon ^2{\left[ {\begin{array}{*{20}{c}} 1&0&0& \ldots &0 \\ 0&1&0& \ldots &0 \\ 0&0&1& \ldots &0 \\ \vdots &{}&{}&{}& \vdots \\ 0&0&0& \ldots &1 \end{array}} \right]_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-0b3b5271c276f3c7ce759ac122b7ebca_l3.png)
Yukarıda nxn boyutlu asal köşegeni 1, diğer elemanları 0 değerlerinden oluşan matris birim matrise eşittir ve birim matris de 1’e eşit bir skalerdir.
![Rendered by QuickLaTeX.com \displaystyle Var - Cov\left( \varepsilon \right) = E\left( {\varepsilon '\varepsilon } \right) = \delta _\varepsilon ^2{\underbrace {\left[ {\begin{array}{*{20}{c}} 1&0&0& \ldots &0 \\ 0&1&0& \ldots &0 \\ 0&0&1& \ldots &0 \\ \vdots &{}&{}&{}& \vdots \\ 0&0&0& \ldots &1 \end{array}} \right]}_{\rm I}_{nxn}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-80f9f8783ab91a3d4ea13ec45bc97b33_l3.png)
![]()
![]()
Yukarıda gösterildiği gibi
matrisinin 1xn boyutlarında bir satır vektörü olduğu varsayımı altında, 1×1 boyutlu
matrisinin yanı sıra, nxn boyutlu varyans-kovaryans matrisini temsil eden
matrisinin de
varsayımı geçerli iken hata teriminin varyansını temsil eden skaler (tek bir sayısal) bir sonucu vardır.
![]()
![]()
Özetle
matrisi, denklem sisteminde sütun veya satır vektörü olarak yer alabildiğinden dolayı,
matrislerinin sonucu 1×1 boyutlu bir skaler de olsa, nxn boyutlu bir varyans-kovaryans matrisi de olsa, her ikisinin sonucu da
ifadesine eşit birer skaler olacaktır.
Açıklanan değişken Y’nin varyansı ile hata teriminin varyansının eşit olmasını temsil eden White-Noise (beyaz gürültü veya problemsiz hata), matris cebiri kullanılarak aşağıda gösterilmiştir.
,
,
ve
ifadeleri birer matris olmak üzere,
![Rendered by QuickLaTeX.com \displaystyle \mathop {\left[ {\begin{array}{*{20}{c}} {{Y_1}} \\ {{Y_2}} \\ {{Y_3}} \\ {{Y_4}} \\ \vdots \\ {{Y_n}} \end{array}} \right]}\nolimits_{nx1} = \mathop {\left[ \begin{gathered} \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{11}}} \end{array}}&{{X_{21}}} \end{array}}&{{X_{31}}} \end{array}}& \ldots \end{array}}&{{X_{\left( {k - 1} \right)1}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{12}}} \end{array}}&{{X_{22}}}&{{X_{32}}}& \ldots &{{X_{\left( {k - 1} \right)2}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{13}}} \end{array}}&{{X_{23}}}&{{X_{33}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)3}}} \end{array} \hfill \\ \vdots \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{1n}}} \end{array}}&{{X_{2n}}}&{{X_{3n}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)n}}} \end{array} \hfill \\ \end{gathered} \right]}\nolimits_{nxk} \mathop {\left[ {\begin{array}{*{20}{c}} {{\beta _0}} \\ {{\beta _1}} \\ {{\beta _2}} \\ {{\beta _3}} \\ \vdots \\ {{\beta _{k - 1}}} \end{array}} \right]}\nolimits_{kx1} + \mathop {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]}\nolimits_{nx1}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-8c0710bdb5fe4a25cabd6d633c7d3613_l3.png)
Yukarıdaki denklem sistemi aşağıdaki gibi daha sade belirtilebilir.
![]()
Yukarıdaki denklem sistemine beklenen değer operatörü ilave edilir
![]()
1.3 no.lu nota göre
ve
matrislerinin beklenen değerleri kendilerine,
matrisinin beklenen değeri ise sıfıra eşittir.
![]()
(5.1)
Yukarıdaki 5.1 no.lu denklem sistemi, 3.2 ve 3.3 no.lu denklemlerde elde edilen aynı sonucu, açıklayıcı değişkenler belirli bir değer aldığında Y değişkenin beklenen değerini, alacağı ortalama değeri matris cinsinden ifade eder.
Y’nin varyansı, 5.2 no.lu not ile birlikte düşünülürse, matris formatında Y’nin beklenen değerinden farkının karesi, soldan kendi transpozu ile çarpılmak suretiyle elde edilir.
![]()
olduğundan denklemde yerine yazılır.
![]()
olduğundan denklemde yerine yazılır.
![]()
![]()
![]()
![]()
olduğundan yerine yazılır.
![]()
6. Varsayım:
Hata terimlerinin açıklayıcı değişkenlerle herhangi bir sistematik ilişkisi yoktur; diğer bir ifadeyle kovaryansı sıfır olmalıdır.
varsayımı gereği
olur.
İspat:
![]()
Hata teriminin beklenen değeri sıfıra eşittir.
![Rendered by QuickLaTeX.com \displaystyle Cov\left( {{\varepsilon _i},{X_{1i}}} \right) = E\left( {\left[ {{\varepsilon _i} - \underbrace {E\left( {{\varepsilon _i}} \right)}_0} \right]\left[ {{X_{1i}} - E\left( {{X_{1i}}} \right)} \right]} \right)](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-737c2a634e8ec45ded264c5dfa977531_l3.png)
![]()
Hata terimi parantezin içine dağıtılır.
![]()
Beklenen değer operatörü parantezin içine dağıtılır.
![]()
Bir değişkenin beklenen değeri bir sabite ve bir sabitin de beklenen değeri kendisine eşit olduğundan, bir değişkenin beklenen değerinin beklenen değeri yine o değişkenin beklenen değerine eşittir.
![]()
![]()
Hata teriminin beklenen değeri sıfıra eşittir.
![]()
![]()
iken
olur ve
,
gibi açıklayıcı değişkenlerin gözlem değerlerinin hata terimlerinden bağımsız bir şekilde belirlenmediği anlamına gelir. Bu sorunun sırasıyla olası 3 nedeni olabilir.
- Eşanlılık sorunu,
- Eşanlılık sorunu yoksa, ölçme hatası,
- Eşanlılık ve ölçme hatası yoksa, modelin fonksiyonel formunun yanlış seçilmesi.
7. Varsayım:
n gözlem sayısını ve k ise parametre sayısını temsil etmek üzere
olmalıdır. Aksi halde katsayı tahmin edicileri elde edilemez. Söz gelimi 3 bilinmeyenli (parametreye sahip) bir denklem sisteminin bilinmeyenler için çözülebilmesi için en az 3 farklı denklemin bulunması gerekir.
![]()
![]()
![]()
Temel matematik bilgisi yardımıyla x=4, y=5 ve z=6 olur. Eğer üç bilinmeyenli iki farklı denklem verilirse x, y ve z bulunamaz.
Konu matris cebiri bakımından ele alınacak olursa, n gözlem sayısı X matrisinin rankından-mertebesinden (sütun sayısından) büyük veya eşit olmalıdır,
. Yukarıdaki x, y, z bilinmeyenlerine sahip denklem sistemi aşağıdaki şekilde matris formuna dönüştürülebilir.
![Rendered by QuickLaTeX.com \displaystyle {\left[ {\begin{array}{*{20}{c}} {15} \\ {19} \\ {20} \end{array}} \right]_{3x1}} = {\left[ {\begin{array}{*{20}{c}} 1&1&1 \\ 2&1&1 \\ 1&2&1 \end{array}} \right]_{3x3}}{\left[ {\begin{array}{*{20}{c}} x \\ y \\ z \end{array}} \right]_{3x1}}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-68b86b1b4684f90bb9f8bd330068a3fc_l3.png)
Yukarıdaki denklem sisteminde eşitliğin sağında bulunan 3×3 boyutlu kare matrisin rankı, sütun sayısına eşit olup 3’tür. Gözlem sayısı ise eşitliğin solundaki veya sağındaki 3×1 boyutlu sütun vektörünün veya 3×3 boyutlu kare matrisinin satır sayısını temsil eden 3’’tür.
Yukarıdaki çerçevede konunun parametre tahmin edicileri bakımından ele alınması amacıyla, n gözlem sayısını, i gözlem sırasını ve k parametre sayısını temsil etmek üzere, kullanılacak denklem sayısı ve parametre sayısı aşağıda gibi olacaktır.
![]()
![]()
![]()
![]()
![]()
![]()
Yukarıdaki denklem sistemi aşağıdaki şekilde matris formunda ifade edilir.
![Rendered by QuickLaTeX.com \displaystyle \mathop {\left[ {\begin{array}{*{20}{c}} {{Y_1}} \\ {{Y_2}} \\ {{Y_3}} \\ {{Y_4}} \\ \vdots \\ {{Y_n}} \end{array}} \right]}\nolimits_{nx1} = \mathop {\left[ \begin{gathered} \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{11}}} \end{array}}&{{X_{21}}} \end{array}}&{{X_{31}}} \end{array}}& \ldots \end{array}}&{{X_{\left( {k - 1} \right)1}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{12}}} \end{array}}&{{X_{22}}}&{{X_{32}}}& \ldots &{{X_{\left( {k - 1} \right)2}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{13}}} \end{array}}&{{X_{23}}}&{{X_{33}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)3}}} \end{array} \hfill \\ \vdots \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{1n}}} \end{array}}&{{X_{2n}}}&{{X_{3n}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)n}}} \end{array} \hfill \\ \end{gathered} \right]}\nolimits_{nxk} \mathop {\left[ {\begin{array}{*{20}{c}} {{\beta _0}} \\ {{\beta _1}} \\ {{\beta _2}} \\ {{\beta _3}} \\ \vdots \\ {{\beta _{k - 1}}} \end{array}} \right]}\nolimits_{kx1} + \mathop {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]}\nolimits_{nx1}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-8c0710bdb5fe4a25cabd6d633c7d3613_l3.png)
Yukarıdaki X matrisinin rankı, sütun sayısına eşit olup k ifadesine eşittir. Gözlem sayısı ise X matrisinin satır sayısını temsil eden n ifadesine eşittir. Bu bakımdan
koşulu,
olduğu için
, yani gözlem sayısı n parametre sayısı k’den büyük veya eşit olması şeklinde de ifade edilebilir.
Yukarıdaki
sütun vektörünün son elemanının
olması,
sütun vektörünün satır sayısının k-1 olduğu anlamına gelmez. Çünkü dikkat edilirse
sütun vektörünün ilk elemanı
ile değil, sabit terimi temsil eden
ile başladığından
sütun vektörünün satır sayısı k olmaktadır.
Yukarıdaki denklem sisteminin
sütun vektörü (yani her bir
parametresi) için çözülebilmesi amacıyla en az k tane gözlemin olması gerekir. O halde;
veya
olduğu için
olmalıdır.
Diğer taraftan
katsayıları için istatistik/hipotez testleri yapabilmek için değerleri 1’den başlayan n-k gibi serbestlik derecelerine ihtiyaç olacaktır.
iken serbestlik derecesi
olacağı için istatistiki testlerin yapılabilmesi mümkün olamayacaktır.
olmak koşuluyla, hata terimlerinin normal dağılımına ilişkin 10. Varsayım da göz önüne alınarak literatürde tercih edilen gözlem sayısı en az 30’dur,
.
8. Varsayım:
Açıklayıcı değişkenlerin değerleri birbirinin aynı olmamalıdır. Diğer bir ifadeyle
değişkeninin i. sıradaki değerleri birbirinin aynı olmamalıdır.
![]()
iken
parametre tahmin edicisi tanımlı değildir.

iken yukarıdaki
parametre tahmin edicisinin paydasında bulunan
ifadesi sıfır olacağından
parametre tahmin edicisini tanımsız yapacaktır.


Tanımsız
Konu matris cebiri bakımından ele alınacak olursa,
koşulu ile birlikte, X matrisinin rankı-mertebesi (sütun sayısı) modelde bulunan parametre sayısı olan k’ye eşit olmalıdır,
. Aksi durumda X matrisinin sütun sayısı ile
sütun vektörünün satır sayısı farklı olacağı için X matrisi ile
sütun vektörü arasında çarpma işlemi yapılamaz.
![Rendered by QuickLaTeX.com \displaystyle \mathop {\left[ {\begin{array}{*{20}{c}} {{Y_1}} \\ {{Y_2}} \\ {{Y_3}} \\ {{Y_4}} \\ \vdots \\ {{Y_n}} \end{array}} \right]}\nolimits_{nx1} = \mathop {\left[ \begin{gathered} \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{11}}} \end{array}}&3 \end{array}}&{{X_{31}}} \end{array}}& \ldots \end{array}}&{{X_{\left( {k - 1} \right)1}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{12}}} \end{array}}&3&{{X_{32}}}& \ldots &{{X_{\left( {k - 1} \right)2}}} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{13}}} \end{array}}&3&{{X_{33}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)3}}} \end{array} \hfill \\ \vdots \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{{X_{1n}}} \end{array}}&3&{{X_{3n}}} \end{array}}& \ldots &{{X_{\left( {k - 1} \right)n}}} \end{array} \hfill \\ \end{gathered} \right]}\nolimits_{nxk} \mathop {\left[ {\begin{array}{*{20}{c}} {{\beta _0}} \\ {{\beta _1}} \\ {{\beta _2}} \\ {{\beta _3}} \\ \vdots \\ {{\beta _{k - 1}}} \end{array}} \right]}\nolimits_{kx1} + \mathop {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]}\nolimits_{nx1}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-48904cefa10b0e0ea4e2bd9d81450a16_l3.png)
Yukarıdaki matrisinin 3. sütununda yer alan 3 sabiti, X matrisinin rankının k’dan küçük olmasına yol açacaktır,
. Çünkü X matrisi içindeki sütun vektörleri birbirinden bağımsız değildir, diğer bir ifadeyle aynı bilgiyi içeren birden fazla sütun vektörü vardır. Bu durum X matrisinin determinantının sıfır olmasına sebep olacaktır. Bu yüzden parametre tahmin edicisi tanımsız olacağından parametre tahmin edicisi elde edilemez. Konuyla ilgili olarak benzer bir ispat 9. Varsayım konusunda yapılmıştır.
9. Varsayım:
Açıklayıcı değişkenler arasında tam çoklu doğrusallık (tam çoklu doğrusal bağlantı) sorunu olmamalıdır. Örneğin ile
arasında
gibi birebir (deterministik) bir ilişki olmamalıdır. Böyle bir durumda parametre tahmin edicileri tanımlı değildir.
![]()
,
sabit teriminin temsili değişkeni olup değeri 1’e eşittir. Aşağıdaki matrisin ilk sütununda bulunan ve değeri 1 olan
ifadeleridir.
![Rendered by QuickLaTeX.com \displaystyle \mathop {\left[ {\begin{array}{*{20}{c}} {{Y_1}} \\ {{Y_2}} \\ {{Y_3}} \\ {{Y_4}} \\ \vdots \\ {{Y_n}} \end{array}} \right]}\nolimits_{nx1} = \mathop {\left[ \begin{gathered} \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{10} \end{array}}&5 \end{array}}&{15} \end{array}}& \ldots \end{array}}&{20} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{20} \end{array}}&7&{27}& \ldots &{40} \end{array} \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{30} \end{array}}&9&{39} \end{array}}& \ldots &{60} \end{array} \hfill \\ \vdots \hfill \\ \begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} {\begin{array}{*{20}{c}} 1&{70} \end{array}}&{21}&{91} \end{array}}& \ldots &{140} \end{array} \hfill \\ \end{gathered} \right]}\nolimits_{nxk} \mathop {\left[ {\begin{array}{*{20}{c}} {{\beta _0}} \\ {{\beta _1}} \\ {{\beta _2}} \\ {{\beta _3}} \\ \vdots \\ {{\beta _{k - 1}}} \end{array}} \right]}\nolimits_{kx1} + \mathop {\left[ {\begin{array}{*{20}{c}} {{\varepsilon _1}} \\ {{\varepsilon _2}} \\ {{\varepsilon _3}} \\ {{\varepsilon _4}} \\ \vdots \\ {{\varepsilon _n}} \end{array}} \right]}\nolimits_{nx1}](https://ishakkutlu.com/wp-content/ql-cache/quicklatex.com-655c644903ba84761864643305e84e66_l3.png)
Yukarıdaki X matrisinde
ve
olduğundan X matrisinin rankı k değildir,
. Çünkü X matrisi içindeki sütun vektörleri birbirinden bağımsız değildir, diğer bir ifadeyle aynı bilgiyi içeren birden fazla sütun vektörü vardır. Bu durumda “tam çoklu doğrusal bağlantı” sorunu söz konusu olur ve
olduğundan dolayı X matrisinin determinantı sıfıra eşit olacaktır, .
X matrisinin determinantının sıfır olması ise parametre ta
hmin edicisini tanımsız yapacağından parametre tahmin edicisi elde edilemez.
![]()
Yukarıdaki parametre tahmin edicisi içinde bulunan
ifadesinin eşiti aşağıda yer almaktadır.
![]()
![]()
iken yukarıdaki denklemde yerine yazılır.
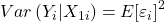
![]()
Tanımsız
Yukarıdaki ifade parametre tahmin edicisinde yerine yazılır.
Tanımsız
10. Varsayım:
Hata terimleri normal dağılıma sahip olmalıdır.
![]()
Hata teriminin sıfır ortalama ve sabit bir varyans ile normal dağılıma sahip olması gerektiğini ifade eder. Bu varsayım özellikle hipotez testleri için önemlidir. Eğer gözlem sayısı (n) büyükse zorunlu bir varsayım olarak kabul edilmemekle birlikte, gözlem sayısı (n) küçükse zorunlu bir varsayım olarak kabul edilir.
İshak Kutlu, Ekonometri Notları