1. Normal Dağılım Varsayımı
Aşağıdaki gibi bir model olsun.

EKK (En Küçük Kareler, Ordinary Least Squares, OLS) tahmin edicisinin önemli varsayımlarından biri doğrusal bir modelin “hata terimlerinin” normal dağılıma sahip olduğudur. Yukarıdaki modelde hata terimi  (Epsilon) ile temsil edilmiştir.
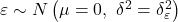
Burada  (Mu) hata teriminin ortalamasını,
 (Sigma kare) ise hata teriminin (sabit kabul edilen) varyansını ifade eder. Hata teriminin ortalaması ’nun değerinin sıfır, varyansı ’nin değerinin ise bir sabit olan
 olduğu kabul edilir.

Kısacası hata teriminin ortalamasının sıfır, varyansının olduğu yönündeki varsayım normalite varsayımı olarak adlandırılır. Normalite varsayımının geçerli olmadığı modellerin tahminleri de tutarlı olmayacaktır. Hata teriminin sıfır ortalama ve gibi bir varyans ile normal dağılıp dağılmadığını farklı koşullarda araştıran bazı test istatistikleri aşağıda açıklanacaktır.
Yukarıdaki model aşağıdaki tablodaki veriler ile EKK yardımıyla tahmin edildiğinde hata terimleri aşağıdaki gibi olacaktır.
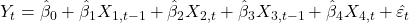

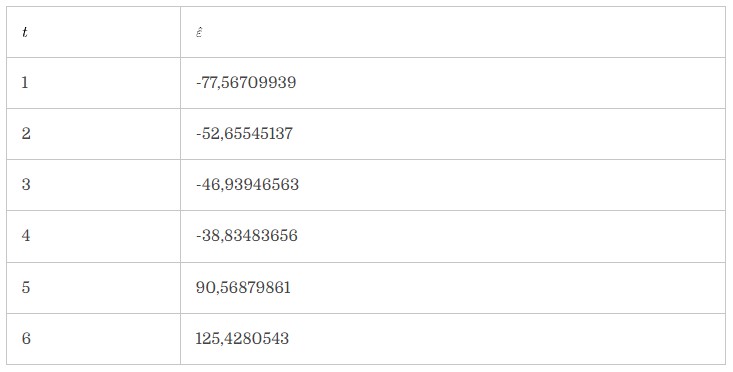 Yukarıdaki hata terimleri tüm normalite testleri için örnek olarak kullanılacaktır.
2. Kolmogorov – Smirnov Testi
 “kesikli” bir rassal değişken kümesinin (hata terimlerinin) birikimli olasılık dağılım fonksiyonunu,
 ise “sürekli” bir rassal değişkenin standart normal dağılım fonksiyonunu temsil etmektedir.
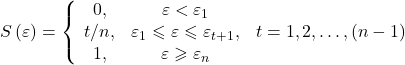
Yukarıda n gözlem sayısını, t ise gözlem sırasını ifade eder. Ayrıca “kesikli” rassal değişkenler olan hata terimlerinin küçükten büyüğe doğru sıralanmış olduğunu göstermekte ve ’a eşit ve ’dan küçük örnek birimlerinin oranını temsil etmektedir.

Yukarıdaki ifade ise örneklem dağılımının normal dağılımdan mutlak olarak maksimum ne kadar saptığını ya da uzaklaştığını temsil etmektedir.
Boş ve alternatif hipotezler ise aşağıdaki şekilde oluşturulur.


Eğer hesaplanan  değeri,
 kritik değerini aşıyorsa hata terimlerinin
 ortalama ve
 varyans ile normal dağılmadığı, tersi durumda ise hata terimlerinin ortalama ve varyans ile normal dağıldığı sonucuna ulaşılır.
Eğer  değerleri hesaplandığında KS istatistiği de kolaylıkla hesaplanabilir. , hata terimlerinin ortalama ve varyans ile standart normal dağılıma dönüştürülmüş değerini ifade eder.
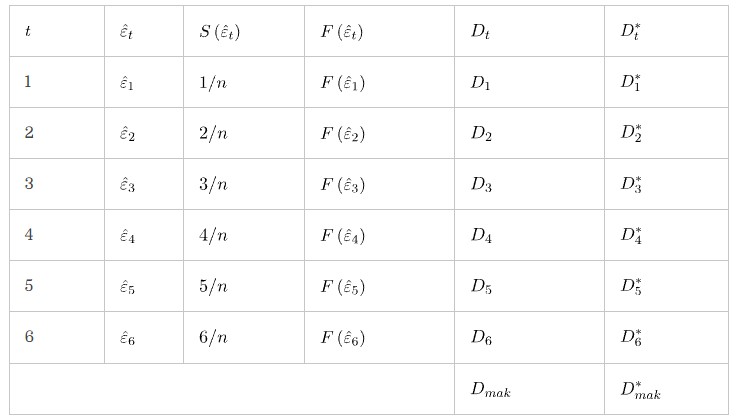
Hata terimleri “küçükten büyüğe” doğru sıralanır ve ilgili istatistikler aşağıda belirtildiği gibi hesaplanır.


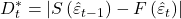
 hata teriminin ortalaması ve
 (Sigma) hata teriminin standart hatası olmak üzere
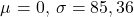 olarak hesaplanmıştır. Hata teriminin varyansı ise standart hatasının karesi olduğundan
 olarak hesaplanır.
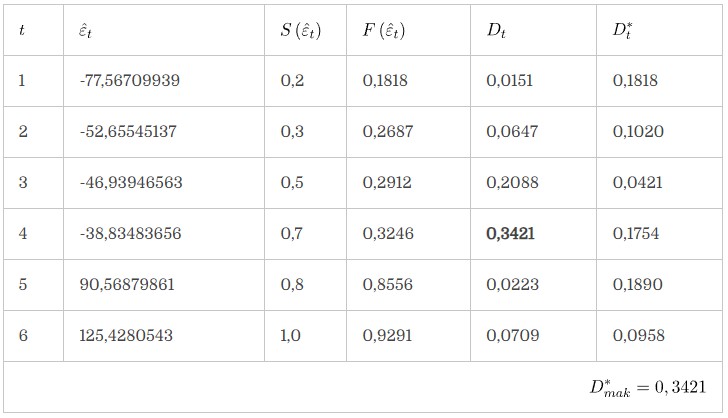
Yukarıdaki tabloda  içindeki maksimum değer 0,1890 iken
 içindeki maksimum değer 0,3421 olarak hesaplanmıştır. Dolayısıyla daha büyük olan D değeri maksimum (
 ) olarak kabul edilir.


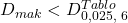 olduğundan boş hipotez kabul edilir ve hata terimlerinin
 ortalama ve varyans ile normal dağılıma uyduğu sonucuna ulaşılır.
3. Shapiro – Wilk Testi
Shapiro – Wilk testi Kolmogorov – Smirnov testinden türetilmiş daha kapsamlı ve güçlü bir normalite testidir. Aşağıdaki adımlar izlenerek test istatistiği hesaplanır.
- Kolmogorov testinde olduğu gibi hata terimleri küçükten büyüğe doğru sıralanır.
- Gözlem sayısı n çift sayı, yani
 ise b değeri a değerlerine tablodan bakılarak aşağıdaki gibi hesaplanır.

- Gözlem sayısı n tek sayı, yani
 ise b değeri a değerlerine tablodan bakılarak aşağıdaki gibi hesaplanır.
- Shapiro – Wilk test istatistiği hesaplanır.

- Boş hipotez hata terimlerinin normal dağılıma uyduğunu, alternatif hipotez ise uymadığını ifade eder.
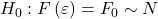

 ise boş hipotez kabul edilir ve hata terimlerinin normal dağılıma uyduğu sonucuna ulaşılır. ise boş hipotez reddedilir ve hata terimlerinin normal dağılıma uymadığı sonucuna varılır.
 ise boş hipotez kabul edilir ve hata terimlerinin normal dağılıma uyduğu sonucuna ulaşılır.
 ise boş hipotez reddedilir ve hata terimlerinin normal dağılıma uymadığı sonucuna varılır.
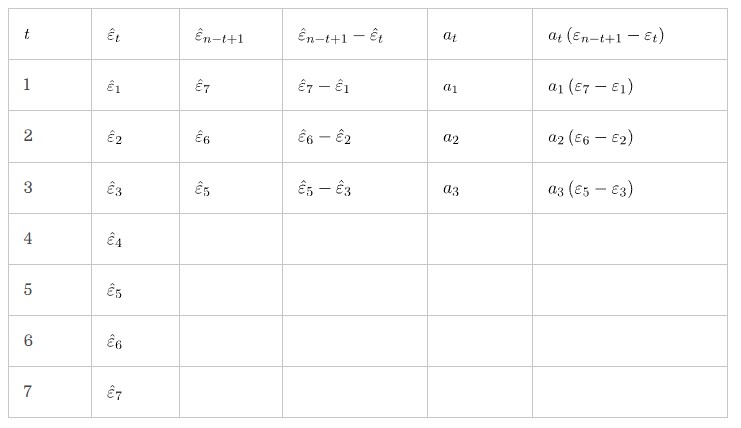
 iken değerinin kuramsal ve sayısal olarak hesaplanması aşağıdaki tablolarda gösterilmiştir.
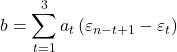

 KS istatistiğinden farklı olarak SW istatistiğinde , regresyondan hesaplanan varyans (regresyonun standart hatasının karesi) olup örneğimiz için 36435,17’dir.
k modeldeki katsayı adeti olmak üzere regresyonun varyansı aşağıdaki gibi hesaplanır.
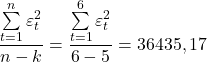
Gerekli parametreler hesaplandığına göre SW istatistiği aşağıdaki gibi hesaplanır.

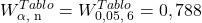
 olduğundan boş hipotez kabul edilir ve hata terimlerinin normal dağılıma uyduğu sonucuna varılır.
 iken de değerinin kuramsal olarak hesaplanması aşağıdaki tabloda gösterilmiştir.
 4. Anderson – Darling Testi
Anderson – Darling testi, Kolmogorov – Smirnov yaklaşımından türetilmiş olup hata terimlerinin normal dağılıma uyumunu ölçen güçlü bir parametrik normalite sınamasıdır. Küçük örneklem sayısına sahip rassal değişkenlerin normal dağılıma uyumunu ölçmek için de önerilmektedir.
AD istatistiği, parametreleri (ortalaması ve varyansı) bilinen “sürekli” bir rassal değişkenin standart normal dağılımını temsil eden yardımıyla aşağıdaki gibi hesaplanır.


AD istatistiğinin gözlem sayısı n’ye göre aşağıdaki gibi düzeltilerek kullanılması gerektiği önerilmektedir.
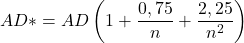
Boş hipotez hata terimlerinin ortalama ve varyans ile normal dağılıma uyduğunu, alternatif hipotez ise hata terimlerinin ortalama ve varyans ile normal dağılıma uymadığını ifade eder.

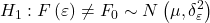
AD* istatistiği  anlamlılık düzeyinde 0,752 değerinden küçük, yani
 ise boş hipotez kabul edilir ve hata terimlerinin ortalama ve varyans ile normal dağılıma uyduğu sonucuna ulaşılır. AD* istatistiği anlamlılık düzeyinde 0,752 değerinden büyük, yani
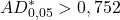 ise boş hipotez reddedilir ve hata terimlerinin ortalama ve varyans ile normal dağılıma uymadığı sonucuna varılır.
Eğer değerleri hesaplandığında AD* istatistiği de kolaylıkla hesaplanabilir. değerlerinin nasıl hesaplanacağı KS istatistiği kısmında bahsedilmişti.
AD* istatistiğinin hesaplanmasına dair kuramsal ve (başlangıçtaki modelin hata terimleri üzerinden) sayısal yaklaşımlar aşağıdaki tablolarda gösterilmektedir.
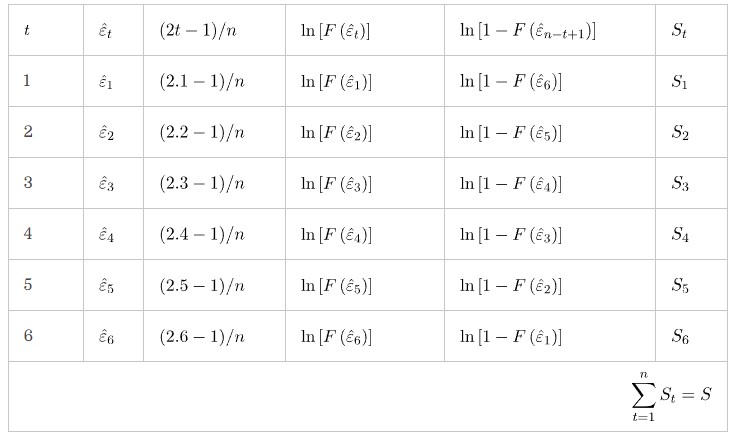
A=
B=
C=

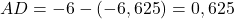


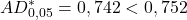 olduğundan boş hipotez kabul edilir ve hata terimlerinin ortalama ve
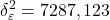 varyans ile normal dağılıma uyduğu sonucuna ulaşılır.
5. Jarque – Bera Testi
Jarque – Bera Testi, hata terimlerinin normal dağılıma uyumunu ölçen parametrik olmayan bir normalite sınamasıdır.

Burada n gözlem sayısını, S hata terimlerinin çarpıklık (skewness) ölçüsünü, K ise basıklık (kurtosis) ölçüsünü temsil edip S ve K aşağıdaki şekilde hesaplanır.
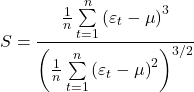
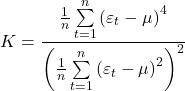
Yukarıdaki ifadelerde , hata terimi  ’nin ortalamasını temsil eder.
JB istatistiği aşağıdaki gibi de hesaplanabilir.
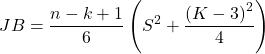
Burada k bağımsız değişken sayısını temsil etmekte olup birden fazla bağımsız değişken içeren modeller için JB istatistiğinin yukarıdaki gibi düzeltilmesi gerektiği savunulur.
Boş hipotez hata terimlerinin normal dağılıma uyduğunu, alternatif hipotez ise uymadığını ifade eder.
JB istatistiği asimptotik olarak anlamlılık düzeyinde serbestlik derecesi 2 olan ki-kare  dağılımına yaklaşır. Hata terimleri, normal dağılımın çarpıklık ve basıklık ölçüsünden uzaklaştıkça JB istatistiği artar.
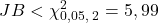 ise boş hipotez kabul edilir ve hata terimlerinin normal dağılıma uyduğu sonucuna ulaşılır.
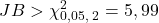 ise boş hipotez reddedilir ve hata terimlerinin normal dağılıma uymadığı sonucuna varılır.
Eğer S ve K değerleri hesaplandığında JB istatistiği de kolaylıkla hesaplanabilir.
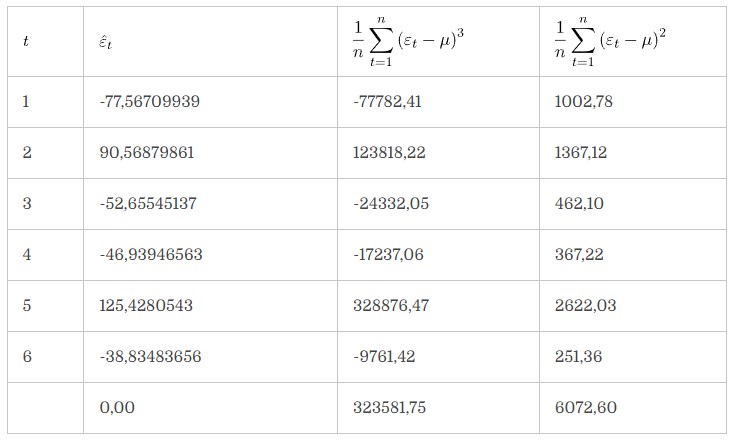
S değerinin hesaplanmasına dair kuramsal ve (başlangıçtaki modelin hata terimleri üzerinden) sayısal yaklaşımlar aşağıdaki tablolarda gösterilmektedir.
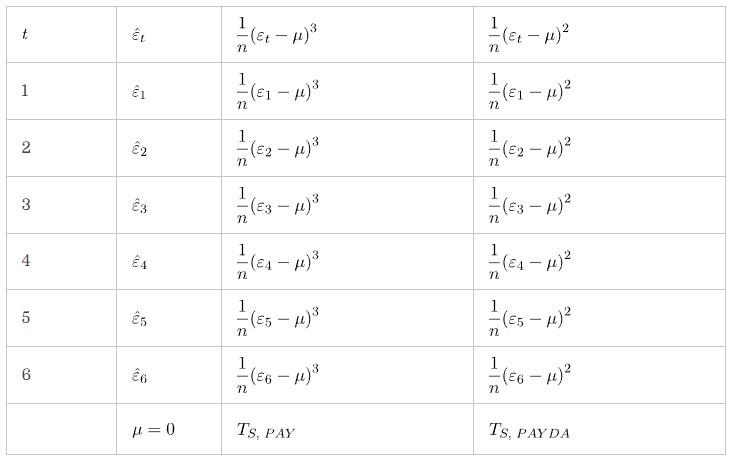
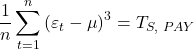

Bilindiği gibi , hata teriminin ortalaması olup 0’a eşittir.  ifadesi S’nin pay kısmı toplamını,
 ifadesi ise S’nin payda kısmı toplamını ifade etmektedir. Sonuç olarak aşağıdaki ifade S değerini verecektir.
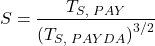

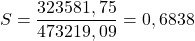
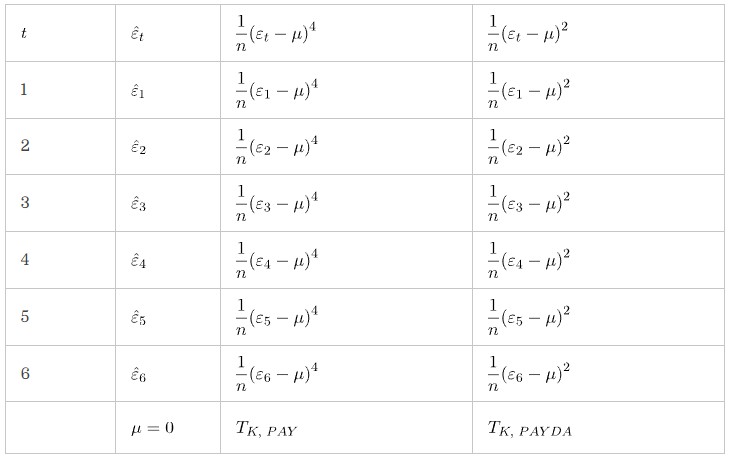
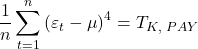

 ifadesi K’nin pay kısmı toplamını,
 ifadesi ise K’nin payda kısmı toplamını ifade etmektedir. Sonuç olarak aşağıdaki ifade K değerini verecektir.


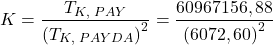
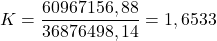
Gözlem sayısı n=6 olduğuna ve S ile K değerleri bilindiğine göre JB istatistiği aşağıdaki gibi hesaplanır.
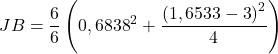

 olduğundan boş hipotez kabul edilir ve hata terimlerinin normal dağılıma uyduğu sonucuna ulaşılır.
İshak Kutlu, Ekonometri Notları