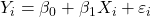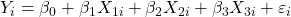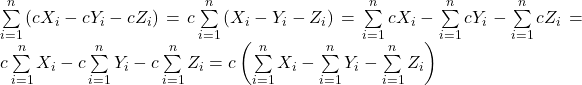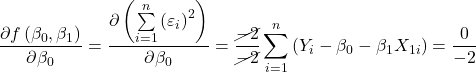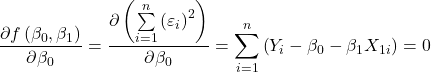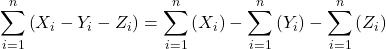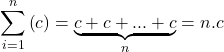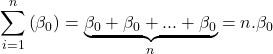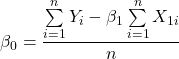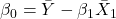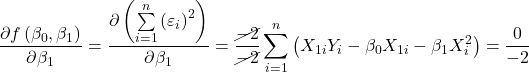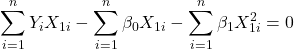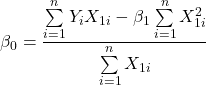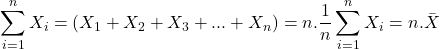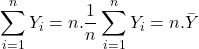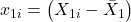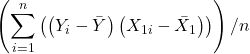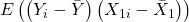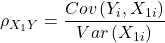
En Küçük Kareler Yöntemi

E


1.  En Küçük Kareler Tahmin Edicisinin Elde Edilmesi

En küçük kareler veya sıradan en küçük kareler yöntemi (EKK, SEK veya OLS, ordinary least squares) doğrusal bir modelin parametrelerini (\displaystyle \beta  katsayılarını) tahmin etmede (parametre tahmin edicilerini elde etmede) kullanılan yaygın bir yöntemdir.

\displaystyle {\beta _0}, \displaystyle {\beta _1} gibi \displaystyle \beta  parametrelerinin tahmin edicisi popülasyona aitse  \displaystyle {\beta _0}, \displaystyle {\beta _1} olarak, örnekleme aitse \displaystyle {\hat \beta _0}, \displaystyle {\hat \beta _1} olarak ifade edilir. Parametre tahmin edicilerini elde etme/hesaplama aşamasında popülasyon verilerine ulaşmak genellikle mümkün değildir veya çok zordur. Bu sebeple parametre tahmin edicileri genellikle örnekleme dayanılarak elde edilir/hesaplanır. Bununla birlikte popülasyona ait parametre tahmin edicilerinin elde edilme yöntemi ile örnekleme ait parametre tahmin edicilerinin elde edilme yönteminde matematiksel bakımdan herhangi bir farklılık yoktur. Bu sebeple parametre tahmin edicilerini temsil etmede kullanılan \displaystyle {\beta _0} ve \displaystyle {\beta _1} ifadeleri yerine, \displaystyle {\hat \beta _0} ve \displaystyle {\hat \beta _1} ifadeleri de kullanılabilir.  Aksi belirtilmedikçe, \displaystyle {\beta _0} ve \displaystyle {\beta _1} ifadeleri ile \displaystyle {\hat \beta _0} ve \displaystyle {\hat \beta _1} ifadeleri birbirinin yerine kullanılabilir.

EKK’da temel amaç, modelin hata terimlerinin kareleri toplamını minimize etmek yoluyla \displaystyle \beta  katsayılarını tahmin etmektir.

Matematiksel işlem kolaylığı sağlaması amacıyla bir sabiti ve bir açıklayıcı değişkeni bulunan aşağıdaki gibi bir model olsun.
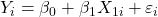
\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}

Yukarıdaki modelde tek açıklayıcı/bağımsız değişken bulunduğu için \displaystyle {X_{1i}} ifadesi aşağıdaki şekilde \displaystyle {X_i} olarak da ifade edilebilir.

\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_i} + {\varepsilon _i}

Ancak söz konusu modelde birden fazla açıklayıcı/bağımsız değişken bulunsaydı, X ifadelerinin birbirleri ile karışmaması amacıyla, zorunlu olarak \displaystyle {X_{1i}}, \displaystyle {X_{2i}}, \displaystyle {X_{3i}} şeklinde ifade edilmesi gerekirdi.

\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\beta _2}{X_{2i}} + {\beta _3}{X_{3i}} + {\varepsilon _i}

Burada \displaystyle {X_{1i}}, \displaystyle {X_{2i}}, \displaystyle {X_{3i}} ifadelerinde yer alan 1, 2, 3 ifadeleri değişkenlerin birbirinden farklı olduğunu temsil etmek amacıyla kullanılmıştır. Ancak açıklanan/bağımlı değişken Y, açıklayıcı/bağımsız değişkenler X ve hata terimi/kalıntısı \displaystyle \varepsilon  ifadelerinde yer alan “i” harfleri gözlem sırasını temsil etmektedir.

Bu makalede, tek açıklayıcı/bağımsız değişkeni bulunan ve onun da \displaystyle {X_i} yerine \displaystyle {X_{1i}} ifadesi ile temsil edildiği, aşağıdaki gibi spesifik (örnek-temsili) bir modelden yararlanılacaktır.

\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}

Yukarıdaki modelde hata terimi yalnız bırakılır.

\displaystyle {\varepsilon _i} = {Y_i} - {\beta _0} - {\beta _1}{X_{1i}}

Eşitliğin her iki tarafının da karesi alınarak toplam sembolü ile ifade edilir.

\displaystyle {\left( {{\varepsilon _i}} \right)^2} = {\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)^2}

\displaystyle \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}}  = \sum\limits_{i = 1}^n {{{\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)}^2}}

EKK’da temel amaç, modelin hata terimlerinin kareleri toplamını minimize etmek yoluyla \displaystyle \beta  katsayılarını tahmin etmek olduğu için yukarıdaki denklem, \displaystyle {\beta _0} ve \displaystyle {\beta _1} parametrelerinin bir fonksiyonu olarak ifade edilebilir.

\displaystyle f\left( {{\beta _0},{\beta _1}} \right) = \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}}  = \sum\limits_{i = 1}^n {{{\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)}^2}}

Yukarıdaki denklemde hata terimlerinin karelerinin toplamı elde edildi. Hata terimlerinin karelerinin toplamını minimize etmek için \displaystyle {\beta _0} ve \displaystyle {\beta _1} parametrelerine göre ayrı ayrı kısmi türev alınarak 0’a (sıfıra) eşitlenir. Ancak denklemin \displaystyle {\beta _0} ve \displaystyle {\beta _1} parametrelerine göre kısmi türevlerini almadan önce, aşağıdaki gibi düzenlenmesi türev aşamalarının daha iyi analiz edilmesine yardımcı olacaktır.
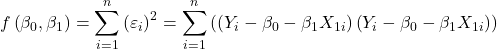
\displaystyle f\left( {{\beta _0},{\beta _1}} \right) = \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}}  = \sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)} \right)}

\displaystyle f\left( {{\beta _0},{\beta _1}} \right) = \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}}  = \sum\limits_{i = 1}^n {\left( {Y_i^2 - 2{\beta _0}{Y_i} - 2{\beta _1}{X_{1i}}{Y_i} + \beta _0^2 + 2{\beta _0}{\beta _1}{X_{1i}} + \beta _1^2X_{1i}^2} \right)}  (1.1)

\displaystyle {\beta _0} parametresinin tahmin edicisini elde etmek için yukarıdaki ifadenin \displaystyle {\beta _0} parametresine göre kısmi türevi alınır.

\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _0}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _0}}} = \sum\limits_{i = 1}^n {\left( { - 2{Y_i} + 2{\beta _0} + 2{\beta _1}{X_{1i}}} \right)} = 0

Not 1.1: X, Y, Z birer değişken ve c bir sabit olmak üzere, c sabiti toplam sembolünün dışında ifade edilebilir.

\sum\limits_{i = 1}^n {\left( {c{X_i} - c{Y_i} - c{Z_i}} \right)}  = c\sum\limits_{i = 1}^n {\left( {{X_i} - {Y_i} - {Z_i}} \right)}  = \sum\limits_{i = 1}^n {c{X_i}}  - \sum\limits_{i = 1}^n {c{Y_i}}  - \sum\limits_{i = 1}^n {c{Z_i}} = c\sum\limits_{i = 1}^n {{X_i}} - c\sum\limits_{i = 1}^n {{Y_i}} - c\sum\limits_{i = 1}^n {{Z_i}} = c\left( {\sum\limits_{i = 1}^n {{X_i}} - \sum\limits_{i = 1}^n {{Y_i}} - \sum\limits_{i = 1}^n {{Z_i}} } \right)

1.1 no.lu notta belirtildiği gibi -2 sabiti toplam sembolünün dışına alınır.
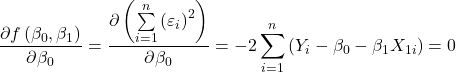
\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _0}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _0}}} = - 2\sum\limits_{i = 1}^n {\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)} = 0

\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _0}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _0}}} = \frac{{\cancel{{ - 2}}}}{{\cancel{{ - 2}}}}\sum\limits_{i = 1}^n {\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)} = \frac{0}{{ - 2}}

\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _0}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _0}}} = \sum\limits_{i = 1}^n {\left( {{Y_i} - {\beta _0} - {\beta _1}{X_{1i}}} \right)} = 0

Not 1.2: X, Y, Z birer değişken veya sabit olmak üzere, toplam sembolünün dağılma özelliği vardır.

\displaystyle \sum\limits_{i = 1}^n {\left( {{X_i} - {Y_i} - {Z_i}} \right)}  = \sum\limits_{i = 1}^n {\left( {{X_i}} \right)}  - \sum\limits_{i = 1}^n {\left( {{Y_i}} \right)}  - \sum\limits_{i = 1}^n {\left( {{Z_i}} \right)}

1.2 no.lu notta belirtildiği gibi toplam sembolü parantez içine dağıtılır.
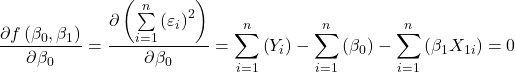
\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _0}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _0}}} = \sum\limits_{i = 1}^n {\left( {{Y_i}} \right)} - \sum\limits_{i = 1}^n {\left( {{\beta _0}} \right)} - \sum\limits_{i = 1}^n {\left( {{\beta _1}{X_{1i}}} \right)} = 0

Not 1.3: c bir sabit olmak üzere, \displaystyle \sum\limits_{i = 1}^n {\left( c \right)}  = \underbrace {c + c + ... + c}_n = n.c ifadesine eşit olduğu ve \displaystyle {\beta _0} da bir sabit olduğu için\displaystyle \sum\limits_{i = 1}^n {\left( {{\beta _0}} \right)}  = \underbrace {{\beta _0} + {\beta _0} + ... + {\beta _0}}_n = n.{\beta _0} olarak ifade edilebilir.

1.3 no.lu notta belirtildiği gibi toplam sembolü içinde sabit dışında herhangi bir ifade yoksa, toplam sembolünün sonucu sabit ile n ifadesinin çarpımına eşittir.
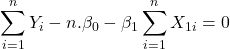
\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  - n.{\beta _0} - {\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}  = 0

Yukarıdaki denklemde \displaystyle {\beta _0} ifadesi yalnız bırakılır.

\displaystyle {\beta _0} = \frac{{\sum\limits_{i = 1}^n {{Y_i}}  - {\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}} }}{n}       (1.2)

1.2 no.lu denklem aşağıdaki gibi düzenlenir.

\displaystyle {\beta _0} = \frac{1}{n}\sum\limits_{i = 1}^n {{Y_i}}  - {\beta _1}\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}

Not 1.4: X bir değişken ve \displaystyle \bar X ifadesi X değişkeninin aritmetik ortalamasını temsil etmek üzere,
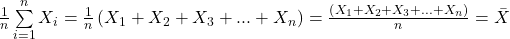
\frac{1}{n}\sum\limits_{i = 1}^n {{X_i}}  = \frac{1}{n}\left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right) = \frac{{\left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right)}}{n} = \bar X olur.

1.4 no.lu notta belirtildiği gibi toplam sembolü içindeki bir değişkenin n ifadesine bölümü, o değişkenin aritmetik ortalamasına eşittir. Yukarıdaki denklem bu çerçevede düzenlenecek olursa, \displaystyle {\beta _0} katsayısının (sabitinin, parametresinin) tahmin edicisi elde edilir.
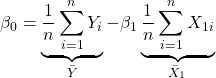
\displaystyle {\beta _0} = \underbrace {\frac{1}{n}\sum\limits_{i = 1}^n {{Y_i}} }_{\bar Y} - {\beta _1}\underbrace {\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}} }_{{{\bar X}_1}}

\displaystyle {\beta _0} = \bar Y - {\beta _1}{\bar X_1}                                              (1.3)

Yukarıdaki 1.1 no.lu denklemin (bu kez) \displaystyle {\beta _1}  parametresine göre kısmi türevi alınır.

\displaystyle f\left( {{\beta _0},{\beta _1}} \right) = \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}}  = \sum\limits_{i = 1}^n {\left( {Y_i^2 - 2{\beta _0}{Y_i} - 2{\beta _1}{X_{1i}}{Y_i} + \beta _0^2 + 2{\beta _0}{\beta _1}{X_{1i}} + \beta _1^2X_{1i}^2} \right)}

\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _1}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _1}}} = \sum\limits_{i = 1}^n {\left( { - 2{X_{1i}}{Y_i} + 2{\beta _0}{X_{1i}} + 2{\beta _1}X_i^2} \right)} = 0

\displaystyle \frac{{\partial f\left( {{\beta _0},{\beta _1}} \right)}}{{\partial {\beta _1}}} = \frac{{\partial \left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i}} \right)}^2}} } \right)}}{{\partial {\beta _1}}} = \frac{{\cancel{{ - 2}}}}{{\cancel{{ - 2}}}}\sum\limits_{i = 1}^n {\left( {{X_{1i}}{Y_i} - {\beta _0}{X_{1i}} - {\beta _1}X_i^2} \right)} = \frac{0}{{ - 2}}

\displaystyle \sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{\beta _0}{X_{1i}}}  - \sum\limits_{i = 1}^n {{\beta _1}X_{1i}^2}  = 0

\displaystyle \sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - {\beta _0}\sum\limits_{i = 1}^n {{X_{1i}}}  - {\beta _1}\sum\limits_{i = 1}^n {X_{1i}^2}  = 0

Yukarıdaki denklemde de (bir öncekinde olduğu gibi) \displaystyle {\beta _0} ifadesi yalnız bırakılır.

\displaystyle {\beta _0} = \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - {\beta _1}\sum\limits_{i = 1}^n {X_{1i}^2} }}{{\sum\limits_{i = 1}^n {{X_{1i}}} }}                  (1.4)

\displaystyle {\beta _1} parametresinin tahmin edicisini elde etmek amacıyla, 1.2 ve 1.4 no.lu ifadeler birbirine eşitlenir.
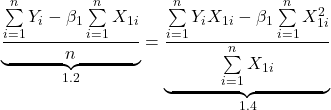
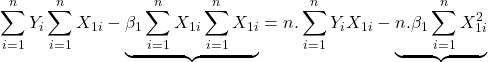
\displaystyle \underbrace {\frac{{\sum\limits_{i = 1}^n {{Y_i}}  - {\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}} }}{n}}_{1.2} = \underbrace {\frac{{\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - {\beta _1}\sum\limits_{i = 1}^n {X_{1i}^2} }}{{\sum\limits_{i = 1}^n {{X_{1i}}} }}}_{1.4}

\displaystyle \sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}}  - \underbrace {{\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}} \sum\limits_{i = 1}^n {{X_{1i}}} }_{} = n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \underbrace {n.{\beta _1}\sum\limits_{i = 1}^n {X_{1i}^2} }_{}

Denklemde \displaystyle {\beta _1} parametrelerinin bulunduğu ifadeler eşitliğin aynı tarafında bir araya getirilir.
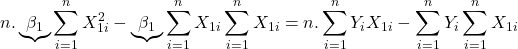
\displaystyle n.\underbrace {{\beta _1}}_{}\sum\limits_{i = 1}^n {X_{1i}^2}  - \underbrace {{\beta _1}}_{}\sum\limits_{i = 1}^n {{X_{1i}}} \sum\limits_{i = 1}^n {{X_{1i}}}  = n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}}

1.1 no.lu notta belirtildiği gibi toplam sembollerinde bulunan \displaystyle {\beta _1} parametreleri parantez dışında çarpan olarak ifade edilir.
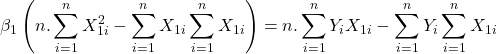
\displaystyle {\beta _1}\left( {n.\sum\limits_{i = 1}^n {X_{1i}^2}  - \sum\limits_{i = 1}^n {{X_{1i}}} \sum\limits_{i = 1}^n {{X_{1i}}} } \right) = n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}}

\displaystyle {\beta _1} parametresi yalnız bırakılmak suretiyle \displaystyle {\beta _1} parametresinin tahmin edicisi elde edilir.
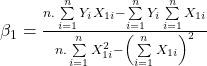
{\beta _1} = \frac{{n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}} }}{{n.\sum\limits_{i = 1}^n {X_{1i}^2}  - {{\left( {\sum\limits_{i = 1}^n {{X_{1i}}} } \right)}^2}}}      (1.5)

Yukarıdaki ifadenin pay ve paydasının -1 ile çarpılması durumunda \displaystyle {\beta _1} katsayısının tahmin edicisi aşağıdaki şekilde de ifade edilebilir.

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}}  - n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}} }}{{{{\left( {\sum\limits_{i = 1}^n {{X_{1i}}} } \right)}^2} - n.\sum\limits_{i = 1}^n {X_{1i}^2} }}     (1.6)

2.  En Küçük Kareler Tahmin Edicisinin Ortalamadan Farklar Yöntemiyle Elde Edilmesi

Yukarıdaki 1.5 no.lu denklemden devam edilir.
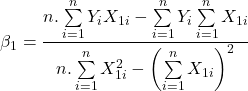
\displaystyle {\beta _1} = \frac{{n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}} }}{{n.\sum\limits_{i = 1}^n {X_{1i}^2}  - {{\left( {\sum\limits_{i = 1}^n {{X_{1i}}} } \right)}^2}}}

Not 2.1: X bir değişken ve \displaystyle \bar X ifadesi X değişkeninin aritmetik ortalamasını temsil etmek üzere,

\displaystyle \sum\limits_{i = 1}^n {{X_i}}  = \left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right) = n.\frac{1}{n}\sum\limits_{i = 1}^n {{X_i}}  = n.\bar X

2.1 no.lu nota göre 1.5 no.lu ifadede yer alan \displaystyle \sum\limits_{i = 1}^n {{X_{1i}}}  = n.\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}  = n.{\bar X_1} ve \displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = n.\frac{1}{n}\sum\limits_{i = 1}^n {{Y_i}}  = n.\bar Y olduğundan 1.5 no.lu ifade aşağıdaki gibi düzenlenebilir.
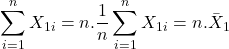
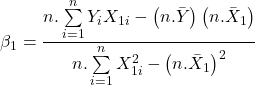
\displaystyle {\beta _1} = \frac{{n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {n.\bar Y} \right)\left( {n.{{\bar X}_1}} \right)}}{{n.\sum\limits_{i = 1}^n {X_{1i}^2}  - {{\left( {n.{{\bar X}_1}} \right)}^2}}}

\displaystyle {\beta _1} = \frac{{\cancel{n}.\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {n.\bar Y{{\bar X}_1}} \right)} \right)}}{{\cancel{n}.\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {n.\bar Y{{\bar X}_1}} \right)} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}                              (2.1)

2.1 no.lu ifadenin payına ve paydasına aşağıda gösterildiği gibi denklemin sonucunu değiştirmeyecek olan aynı ifadelerin + ve – değerleri eklenir. Burada amaç denklemde yer alan “n” ifadelerinden kurtularak, denklemi her değişkenin kendi ortalamasından farkı cinsinden ifade etmektir.
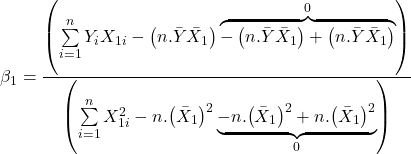
\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {n.\bar Y{{\bar X}_1}} \right)\overbrace { - \left( {n.\bar Y{{\bar X}_1}} \right) + \left( {n.\bar Y{{\bar X}_1}} \right)}^0} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}\underbrace { - n.{{\left( {{{\bar X}_1}} \right)}^2} + n.{{\left( {{{\bar X}_1}} \right)}^2}}_0} \right)}}

2.1 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki ifade aşağıdaki şekilde düzenlenir.

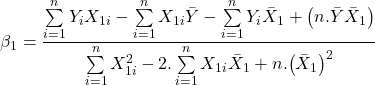
\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \cancel{n}.\left( {\overbrace {\frac{1}{{\cancel{n}}}\sum\limits_{i = 1}^n {{X_{1i}}} }^{{{\bar X}_1}}\bar Y} \right) - \cancel{n}.\left( {\overbrace {\frac{1}{{\cancel{n}}}\sum\limits_{i = 1}^n {{Y_i}} }^{\bar Y}{{\bar X}_1}} \right) + \left( {n.\bar Y{{\bar X}_1}} \right)} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - 2\cancel{n}.\left( {\underbrace {\frac{1}{{\cancel{n}}}\sum\limits_{i = 1}^n {{X_{1i}}} }_{{{\bar X}_1}}{{\bar X}_1}} \right) + n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{X_{1i}}} \bar Y - \sum\limits_{i = 1}^n {{Y_i}} {{\bar X}_1} + \left( {n.\bar Y{{\bar X}_1}} \right)}}{{\sum\limits_{i = 1}^n {X_{1i}^2}  - 2.\sum\limits_{i = 1}^n {{X_{1i}}} {{\bar X}_1} + n.{{\left( {{{\bar X}_1}} \right)}^2}}}

1.2 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki denklemin payı ve paydası aşağıdaki şekilde düzenlenir.
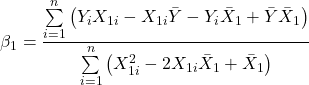
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {{Y_i}{X_{1i}} - {X_{1i}}\bar Y - {Y_i}{{\bar X}_1} + \bar Y{{\bar X}_1}} \right)} }}{{\sum\limits_{i = 1}^n {\left( {X_{1i}^2 - 2{X_{1i}}{{\bar X}_1} + {{\bar X}_1}} \right)} }}

Denklemin payında ve paydasında yer alan toplam sembollerinin içindeki ifadelerin birer özdeşlik olduğuna dikkat edilecek olursa, yukarıdaki denklem aşağıdaki şekilde düzenlenir.
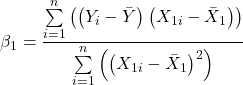
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} }}{{\sum\limits_{i = 1}^n {\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} }} (2.2)

\displaystyle {y_i} = \left( {{Y_i} - \bar Y} \right) ve \displaystyle {x_{1i}} = \left( {{X_{1i}} - {{\bar X}_1}} \right) ifadelerini temsil etmek üzere, \displaystyle {\beta _1} parametresinin tahmin edicisi aşağıdaki şekilde her değişkenin kendi ortalamasından farkı şeklinde de ifade edilebilir.

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{y_i}{x_{1i}}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                        (2.3)

2.3 no.lu denklemin dışında, \displaystyle {\beta _1} parametresinin tahmin edicisini ortalamadan farklar yöntemiyle ifade etmenin ikinci yolu için yukarıdaki 2.1 no.lu denklemden devam edilir.
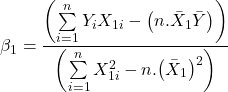
\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {n.{{\bar X}_1}\bar Y} \right)} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

Burada amaç denklemde yer alan “n” ifadelerinden kurtularak, denklemi Y değişkenin kendi ortalamasından farkı cinsinden ifade etmektir. Bu sebeple 2.1 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki ifade aşağıdaki şekilde düzenlenir.
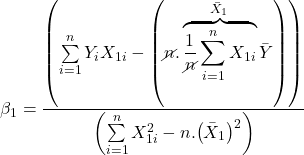
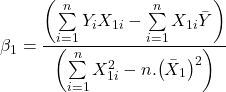
\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {\cancel{n}.\overbrace {\frac{1}{{\cancel{n}}}\sum\limits_{i = 1}^n {{X_{1i}}} }^{{{\bar X}_1}}\bar Y} \right)} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{X_{1i}}} \bar Y} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

1.2 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki denklemin payı aşağıdaki şekilde düzenlenir.
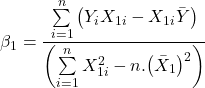
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {{Y_i}{X_{1i}} - {X_{1i}}\bar Y} \right)} }}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

Yukarıdaki ifadenin payında buluna \displaystyle {X_{1i}} ifadesi toplam sembolünün içinde kalmak koşuluyla aşağıdaki şekilde parantez dışında ifade edilir.
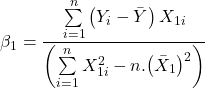
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {{Y_i} - \bar Y} \right){X_{1i}}} }}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

\displaystyle {y_i} = \left( {{Y_i} - \bar Y} \right) ifadesini temsil etmek üzere, \displaystyle {\beta _1} parametresinin tahmin edicisi aşağıdaki şekilde Y değişkeninin kendi ortalamasından farkı şeklinde de ifade edilebilir.
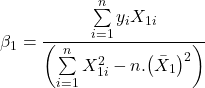
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{y_i}{X_{1i}}} }}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}                    (2.4)

Yukarıda 2.3 no.lu denklemin paydası ile 2.4 no.lu denklemin paydası birbirine eşit olduğundan 2.4 no.lu denklem aşağıdaki şekilde de ifade edilebilir.
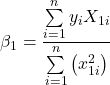
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{y_i}{X_{1i}}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                        (2.5)

2.3 ve 2.5 no.lu denklemlerin dışında, \displaystyle {\beta _1} parametresinin tahmin edicisini ortalamadan farklar yöntemiyle ifade etmenin üçüncü yolu için yine yukarıdaki 2.1 no.lu denklemden devam edilir.

\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {n.{{\bar X}_1}\bar Y} \right)} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

Burada amaç denklemde yer alan “n” ifadelerinden kurtularak, denklemi \displaystyle {X_1} değişkenin kendi ortalamasından farkı cinsinden ifade etmektir. Bu sebeple 2.1 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki ifade aşağıdaki şekilde düzenlenir.

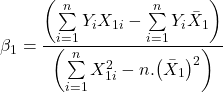
\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \left( {\cancel{n}.\overbrace {\frac{1}{{\cancel{n}}}\sum\limits_{i = 1}^n {{Y_i}} }^{\bar Y}{{\bar X}_1}} \right)} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{Y_i}} {{\bar X}_1}} \right)}}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

1.2 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki denklemin payı aşağıdaki şekilde düzenlenir.
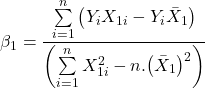
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {{Y_i}{X_{1i}} - {Y_i}{{\bar X}_1}} \right)} }}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

Yukarıdaki ifadenin payında buluna \displaystyle {Y_i} ifadesi toplam sembolünün içinde kalmak koşuluyla aşağıdaki şekilde parantez dışında ifade edilir.
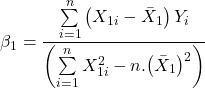
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {{X_{1i}} - {{\bar X}_1}} \right){Y_i}} }}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}

\displaystyle {x_{1i}} = \left( {{X_{1i}} - {{\bar X}_1}} \right) ifadesini temsil etmek üzere, \displaystyle {\beta _1} parametresinin tahmin edicisi aşağıdaki şekilde \displaystyle {X_1} değişkeninin kendi ortalamasından farkı şeklinde de ifade edilebilir.

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{x_{1i}}{Y_i}} }}{{\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - n.{{\left( {{{\bar X}_1}} \right)}^2}} \right)}}                    (2.6)

Yukarıda 2.3 no.lu denklemin paydası ile 2.6 no.lu denklemin paydası birbirine eşit olduğundan 2.6 no.lu denklem aşağıdaki şekilde de ifade edilebilir.
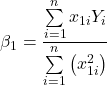
\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{x_{1i}}{Y_i}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                        (2.7)

3.  En Küçük Kareler Tahmin Edicisinin Kovaryans-Varyans Yöntemiyle Elde Edilmesi

Yukarıdaki 2.2 no.lu ifadeden devam edilir.

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} }}{{\sum\limits_{i = 1}^n {\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} }}

Yukarıdaki denklemin payı ve paydası “n” ifadesine bölünür.
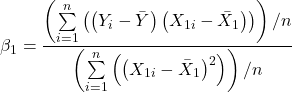
\displaystyle {\beta _1} = \frac{{\left( {\sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} } \right)/n}}{{\left( {\sum\limits_{i = 1}^n {\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} } \right)/n}}                     (3.1)

Yukarıdaki denkleme “E” beklenen değer operatörü ilave edilir.
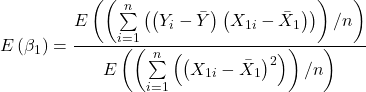
\displaystyle E\left( {{\beta _1}} \right) = \frac{{E\left( {\left( {\sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} } \right)/n} \right)}}{{E\left( {\left( {\sum\limits_{i = 1}^n {\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} } \right)/n} \right)}}

Bir sabitin beklenen değeri kendisine eşit olduğundan ve \displaystyle {\beta _1} ifadesi de bir sabit olduğundan yukarıdaki denklem aşağıdaki şekilde ifade edilebilir.
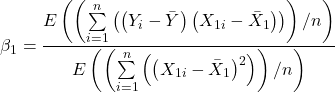
\displaystyle {\beta _1} = \frac{{E\left( {\left( {\sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} } \right)/n} \right)}}{{E\left( {\left( {\sum\limits_{i = 1}^n {\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} } \right)/n} \right)}}

3.1 no.lu ifadenin payında yer alan \displaystyle \left( {\sum\limits_{i = 1}^n {\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} } \right)/n ifadesi \displaystyle E\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right) ifadesine (kovaryansa), paydasında yer alan \displaystyle \left( {\sum\limits_{i = 1}^n {\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} } \right)/n ifadesi de \displaystyle E\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right) ifadesine (varyansa) eşittir. Bu bilgi yukarıdaki denklemde uygulanırsa aşağıdaki gibi bir denklem elde edilir.
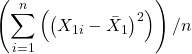
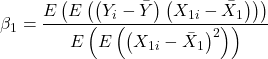
\displaystyle {\beta _1} = \frac{{E\left( {E\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)} \right)}}{{E\left( {E\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)} \right)}}

Bir değişkenin beklenen değeri (yani aritmetik ortalaması) bir sabit ve bir sabitin beklenen değeri kendisine eşit olduğu için bir değişkenin beklenen değerinin beklenen değeri de yine o değişkenin beklenen değerine eşit olacaktır. Bu çerçevede yukarıdaki denklem aşağıdaki şekilde düzenlenebilir.
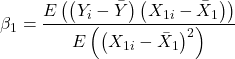
\displaystyle {\beta _1} = \frac{{E\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right)}}{{E\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right)}}

Yukarıdaki denklemin payında yer alan \displaystyle E\left( {\left( {{Y_i} - \bar Y} \right)\left( {{X_{1i}} - {{\bar X}_1}} \right)} \right) ifadesi \displaystyle Cov\left( {{Y_i},{X_{1i}}} \right) ifadesine, paydasında yer alan \displaystyle E\left( {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}} \right) ifadesi ise \displaystyle Var\left( {{X_{1i}}} \right) ifadesine eşittir. Bu sebeple \displaystyle {\beta _1} parametresinin tahmin edicisi, aşağıdaki gibi Y ve \displaystyle {X_1} değişkenlerinin kovaryansının \displaystyle {X_1} değişkeninin varyansına bölümü şeklinde de ifade edilebilir.
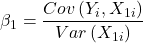
\displaystyle {\beta _1} = \frac{{Cov\left( {{Y_i},{X_{1i}}} \right)}}{{Var\left( {{X_{1i}}} \right)}}                        (3.1)

3.1 no.lu denklem, iki değişken arasındaki doğrusal ilişkin yönünü ve gücünü belirleyen, -1 ile +1 arasında değerlere sahip olabilen korelasyon katsayısı bakımından değerlendirilecek olursa, \displaystyle {X_1} değişkeninin Y değişkeni üzerindeki etkisini temsil eden \displaystyle {\rho _{{X_1}Y}} ifadesi ile sembolize edilebilir.

\displaystyle {\rho _{{X_1}Y}} = \frac{{Cov\left( {{Y_i},{X_{1i}}} \right)}}{{Var\left( {{X_{1i}}} \right)}}

Bu durumda \displaystyle {\beta _1} parametresinin tahmin edicisi, \displaystyle {X_1} ve Y değişkenleri arasındaki korelasyon katsayısına eşit olacaktır.

\displaystyle {\beta _1} = {\rho _{{X_1}Y}}                                   (3.2)

Toparlamak gerekirse yukarıda EKK yöntemi ile elde edilen alternatif parametre tahmin edicileri aşağıdaki şekilde özetlenebilir.

\displaystyle {\beta _0} = \bar Y - {\beta _1}{\bar X_1}                                        (1.3)

\displaystyle {\beta _1} = \frac{{n.\sum\limits_{i = 1}^n {{Y_i}{X_{1i}}}  - \sum\limits_{i = 1}^n {{Y_i}} \sum\limits_{i = 1}^n {{X_{1i}}} }}{{n.\sum\limits_{i = 1}^n {X_{1i}^2}  - {{\left( {\sum\limits_{i = 1}^n {{X_{1i}}} } \right)}^2}}}       (1.5)

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{y_i}{x_{1i}}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                          (2.3)

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{y_i}{X_{1i}}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                         (2.5)

\displaystyle {\beta _1} = \frac{{\sum\limits_{i = 1}^n {{x_{1i}}{Y_i}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                          (2.7)

\displaystyle {\beta _1} = \frac{{Cov\left( {{Y_i},{X_{1i}}} \right)}}{{Var\left( {{X_{1i}}} \right)}}                                 (3.1)

\displaystyle {\beta _1} = {\rho _{{X_1}Y}}                                                 (3.2)


İshak Kutlu, Ekonometri Notları
 

2 Yorum

  • Çok net, açıklayıcı ve öğretici bilgiler verdiğiniz için teşekkür ederim. Sayenizde aklımdaki tüm soru işaretlerine cevap bulabildim. Emeğinize sağlık.

İshak Kutlu

Veri & Otomasyon Uzmanı

Kurumsal iş akışlarını düzenleyen veri odaklı otomasyon sistemleri ve makine öğrenmesi tabanlı çözümler geliştirir. Gerçek operasyonel süreçler için ölçeklenebilir ve izlenebilir yapılar tasarlar.

YouTube   YouTube   YouTube   YouTube