Matris cebiri ile tahmin edicilerde aranan özelliklere geçmeden önce popülasyon parametresi ve tahmin edici ayrımının vurgulanması yararlı olacaktır.  ,
 ,
 ,
 birer matris olmak üzere, aşağıda yer alan genel doğrusal model popülasyona ilişkin gerçek bir modeli temsil eder.
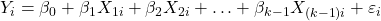
 (I)
 ,
 gibi parametrelerin ve
 hata teriminin üzerinde şapka (hat) işareti olmayan ifadeler, popülasyona ilişkin gerçek modelin parametreleri/hata terimleri olup pratikte bunları elde etmek/hesaplamak mümkün olmaz. Bu yüzden EKK yönteminde temel amaç, popülasyona ait gerçek modelin parametrelerini en az sapma/hata ile örnekleme dayanarak tahmin etmektir. Bu kapsamda, ,
 ,
 birer matris olmak üzere, aşağıdaki model (yukarıda yer alan popülasyona ilişkin gerçek modeli yansıttığı düşünülen) örnekleme dayanılarak elde edilen modeli temsil eder.
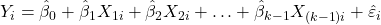
 (II)
 ,
 gibi parametrelerin ve
 hata teriminin üzerinde şapka (hat) işareti olan ifadeler, örnekleme ilişkin tahmin edilen modelin parametreleri (diğer bir ifadeyle tahmin ediciler/tahmin edilen hata terimleri) olup pratikte bunları elde etmek/hesaplamak mümkündür. Ancak , gibi tahmin edicilerin popülasyona ait gerçek modelin parametreleri ile belirli ilişkisel özellikler göstermesi beklenir. Bu yüzden matris cebiri ile tahmin edicilerde aranan özellikler başlığı altında, örnekleme dayanılarak tahmin (elde) edilen parametrelerin ve hata terimlerinin, gerçek modelin parametreleri ve hata terimleri ile aralarında olması gereken ideal ilişkiler “matris cebiri” kullanılarak ele alınacaktır. Bu makalede aksi belirtilmedikçe X, Y, , , , gibi alt indisi belirtilmeyen ifadeler birer matrisi temsil etmektedir. Genel doğrusal modelde k adet parametre ve k-1 adet açıklayıcı değişken bulunduğu ve gözlem sayısının ise “n” olduğu varsayılmıştır.
Matris cebiri kullanılmadan, diğer bir ifadeyle spesifik bir model üzerinden yapılan analizler için “Tahmin Edicilerde Aranan Özellikler” isimli makaleyi inceleyebilirsiniz.
1. Doğrusallık
EKK ile elde edilen tahmin edicilerin açıklayıcı değişkenlerin doğrusal bir fonksiyonu olduğunun ispatı, yukarıdaki I ve II no.lu genel doğrusal modeller üzerinden matris cebiri yöntemiyle gösterilecektir.
“Matris Cebiri ile En Küçük Kareler Yöntemi” isimli makalenin 1.5 no.lu denkleminde, parametre tahmin edicileri () aşağıdaki formda elde edilmişti.
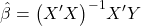 (1.1)
Referans verilen sayfada parametre matrisi popülasyona ilişkin gerçek modelin parametre matrisidir. Ancak örnekleme dayalı olarak tahmin edicileri elde etmek amacıyla da gerçek modelin parametre tahmin edicileri kullanılır. Bu durumda ise ifadesi yerine kullanılır.
 ifadesi bir matris olmak üzere aşağıdaki ifadeye eşit olduğu varsayılır.
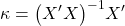
Bu durumda 1.1 no.lu denklem aşağıdaki şekilde ifade edilebilir.

“Matris Cebiri ile En Küçük Kareler Yöntemi” isimli makalenin 1.4 no.lu notunda gösterildiği gibi ifadesi, kxn, Y ifadesi de nx1 boyutlu bir matrise eşittir. Bu durumda matrisi de beklendiği gibi kx1 boyutlu (yani k adet parametrenin tahmin edicilerini içeren) bir sütun vektörüdür.
kx1 boyutlu parametre tahmin edicileri, Y ifadesinin X değişkenlerine (yani ifadesine) göre ağırlıklandırılmış bir ortalaması olduğundan doğrusal bir tahmin edicidir.
2. Sapmasızlık
Sapmasızlık, örnekleme dayanılarak tahmin edilen parametrelerinin popülasyona ait gerçek modelin parametrelerinin beklenen değerine eşit olmasını ifade eder. EKK ile elde edilen tahmin edicilerin sapmasız olduğunu göstermek için 1.1 no.lu denklemden devam edilir.
I no.lu denklem (popülasyona ait gerçek model) yukarıdaki denklemde yerine yazılır.
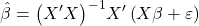


A bir matris ve I birim matris olmak üzere  ,
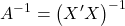 ve
 olur. Bir matrisi, kendi tersi ile çarpmak birim matrisi verdiğinden ve birim matrisin determinantı da 1 olduğundan,
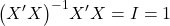 yoluyla sütun vektörü yalnız bırakılmış olur.
 (2.1)
2.1 no.lu denklem sistemine beklenen değer operatörü ilave edilir.
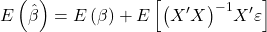
ve X matrisleri birer sabit olduğundan beklenen değerleri kendilerine eşittir.
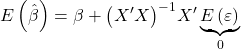
Hata terimlerinin beklenen değeri sıfırdır.

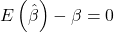 (2.2) |
tahmin edicilerinin beklenen değerinin popülasyon (gerçek modelin) parametresi olan ifadelerine eşit olması, tahmin edicilerinin (gerçek modelin parametrelerine göre) sapmasız olduğunu ifade eder.
3. Parametre Varyansları ve Kovaryansları ile Hata Teriminin Varyansı, Minimum Varyans ve Etkinlik
Parametre varyansları ve kovaryansları, , ,  gibi tahmin edicilerin varyanslarını ve kovaryanslarını, hata teriminin varyansı ise tahmin edilen modelin hata teriminin ( ifadesinin) varyansını temsil eder. Aşağıda detaylı olarak görüleceği gibi parametre varyansları da hata teriminin varyansından bağımsız değildir. Ancak minimum varyans kavramı ile esas olarak hata teriminin varyansının minimum olmasına değil, parametrelerin (, , gibi tahmin edicilerin) varyansının minimum olmasına işaret edilir.
Parametre varyansları ve kovaryansları ile hata teriminin varyansı konusuna, (tahmin edicilerde aranan özellikler ile doğrudan ilgili olmamasına rağmen) makalenin bütünlüğünün korunması amacıyla bu bölümde yer verilmiştir.
Parametre Varyansları ve Kovaryansları
Matris cebiri ile parametre varyansları ve kovaryansları (toplam sembollerinin kullanıldığı normal cebirsel yöntemde olduğu gibi) farklı yollardan elde edilmez. Bu yüzden matris cebiri ile işlem yapılırken parametrelerin varyansları ile birlikte aynı zamanda kovaryansları da elde edildiğinden  ifadesi yerine
 ifadesi kullanılır.
Varyans, tanım gereği bir değişkenin kendi ortalamasından farklarının kareleri toplamı olduğundan, matrisini elde etmek için kx1 boyutlu  matrisi “sağdan” (1xk boyutlu) transpozu ile çarpılarak beklenen değeri alınır.
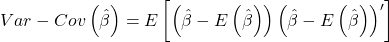 (3.1)
Not 3.1: Bir matrisin transpozunu (devriğini) almak, o matrisin satırlarının sütun, sütunlarının da satır biçiminde ifade edilmesi anlamına gelir. A ve B birer matris olmak üzere, A ve B matrislerinde AB biçiminde çarpma işlemi yapmak için soldaki ifadenin (A’nın) sütun sayısı sağdaki ifadenin (B’nin) satır sayısına eşit olmalıdır. Yeni matrisin boyutu da birinci matrisin (A’nın) satır sayısı ile ikinci matrisin (B’nin) sütun sayısına eşit olacaktır.
|
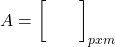 ve
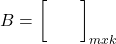 olmak üzere,
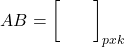 boyutlarında bir matris elde edilir.
3.1 no.lu nota göre kx1 boyutlu matrisi “sağdan” (1xk boyutlu) transpozu ile çarpılması sonucu kxk boyutlu bir kare matris elde edilir.
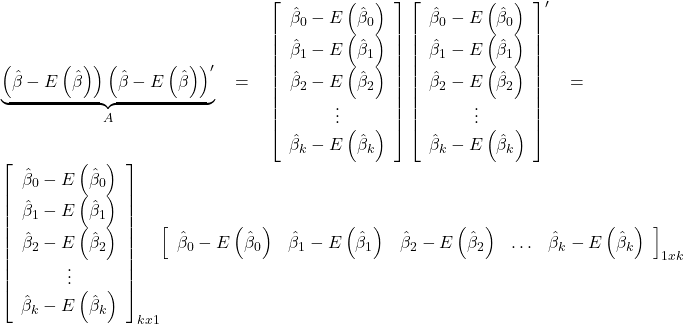
Denklemin sayfaya sığdırılabilmesi amacıyla denklem sisteminin solundaki ifadenin A’ya eşit olduğu kabul edilmiştir.

kxk boyutlu yukarıdaki A matrisine beklenen değer operatörü ilave edilir.
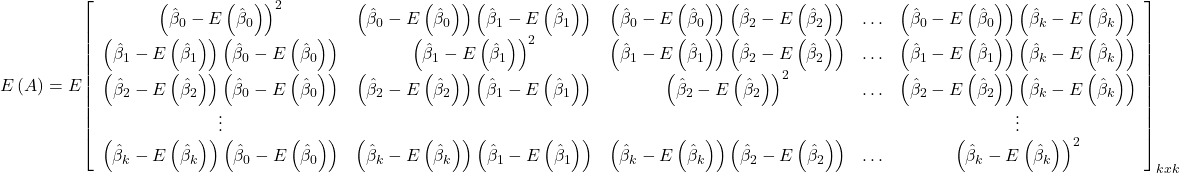
Beklenen değer operatörü matrisin içindeki tüm elemanlara dağıtılır. Ancak teknik sebeplerden dolayı (matrisin sayfaya sığdırılabilmesi için) beklenen değer operatörünün matrisin içindeki tüm elemanlara ilave edildiği varsayılmıştır. Ayrıca 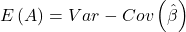 olacağından aşağıda yerine yazılır.
 (3.2)
kxk boyutlu yukarıdaki matrisinin asal köşegeni , , gibi parametre tahmin edicilerin varyanslarını, diğer elemanları ise kovaryanslarını verir.
Eğer kx1 boyutlu matrisi “sağdan” değil de “soldan” (1xk boyutlu) transpozu ile çarpılsaydı, sonucu kxk boyutlu bir kare matris değil, 1×1 boyutlu bir skaler olurdu.
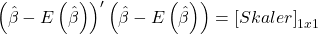
kx1 boyutlu matrisinin “sağdan” değil de “soldan” (1xk boyutlu) transpozu ile çarpılması sonucu 1×1 boyutlu bir skalerin elde edilmesi süreci için “Genel Doğrusal Modelin Varsayımları” isimli makalenin 5. Varsayım konusunda yer alan 5.2 no.lu not ve devamında yer alan matrislere ilişkin yapılan açıklamalar gözden geçirilebilir.
Yukarıda yapılan açıklamalardan sonra 3.1 no.lu denklem sisteminden devam edilir.
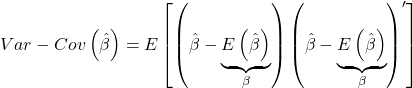
2.2 no.lu denklem sisteminden hareketle  yerine yazılır.
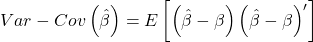

2.1 no.lu denklem sisteminden hareketle  yerine
 yazılır.

Not 3.2: A, B ve C birer matrisi temsil etmek üzere, matrislerde transpoze işlemi aşağıdaki gibi tanımlıdır.
|

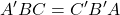
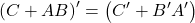

3.2 no.lu nota göre parantez dışında yer alan transpoze parantez içine dağıtılır.

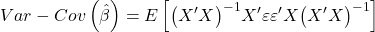
Beklenen değer operatörü parantez içine dağıtılır.

X matrisleri gözlemlenen değişkenlerden oluştuğu ve bu sebeple de birer sabit olduğu için beklenen değerleri kendisine eşittir.

“Genel Doğrusal Modelin Varsayımları” isimli makalenin 5. Varsayım konusunda  olduğundan yukarıdaki denklem sisteminde yerine yazılır.
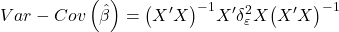
Hata teriminin sabit olan varyansını temsil eden  ifadesi skaler bir büyüklük olup bir sabittir. Bu yüzden yukarıdaki denklem sisteminde herhangi bir yerde konumlandırılabildiğinden en sola alınabilir.
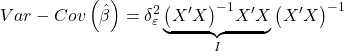
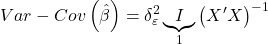
I birim matrisi de 1 skalerine eşit olduğundan tahmin edicilerinin varyansları ve kovaryansları elde edilir.
 (3.3) |
X matrisi nxk boyut bir matris olduğu için  ifadesi de 3.1 ve 3.2 no.lu notlara göre kxk boyutlu bir matrise eşit olacaktır.
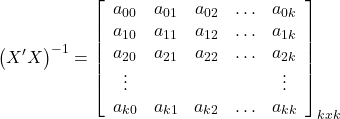
Yukarıdaki matriste bulunan  ,
 ,
 gibi ifadeler matrisinin (parametre tahmin edicilerin varyansını ve kovaryansını elde etmede rol oynayacak
 ,
 ,
 gibi açıklayıcı değişkenlerin matematiksel kombinasyonlarından oluşan) elemanlarıdır. Yukarıdaki matrisi 3.3 no.lu denklemde yerine yazılır.
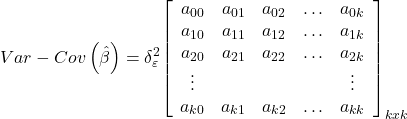
Hata teriminin sabit olan varyansını temsil eden ifadesi matrisin içine dağıtılır.

3.2 no.lu matris ile yukarıdaki matrisin her ikisi de tahmin edicilerin varyans-kovaryans matrisi olduğu için yukarıdaki denklem sisteminde yerine 3.2 no.lu matris yazılır.
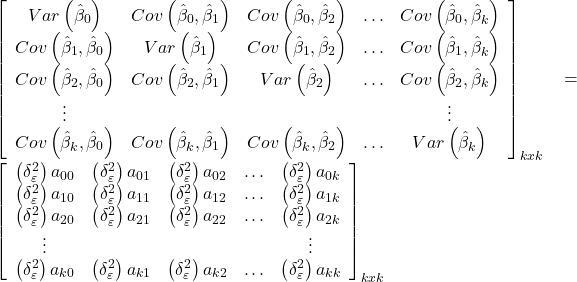
Not 3.3: a ve b birer değişken ve
|
 olmak üzere kovaryans için aşağıdaki özellik geçerlidir.
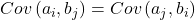
Yukarıdaki matrislerin parametre varyansları ve kovaryansları arasındaki ilişkisi 3.3 no.lu nota göre aşağıdaki tabloda özetlenmiştir.
| Parametre Varyansları | Parametre Kovaryansları |
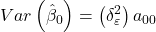 | 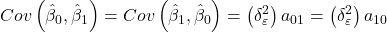 |
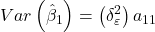 | 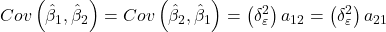 |
 | 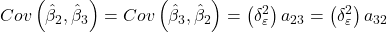 |
 | |
 | 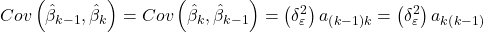 |
Parametre tahmin edicilerin varyansları ve kovaryanslarının hata teriminin ve X değişkenlerinin bir fonksiyonu olduğu yukarıdaki tablodan kolaylıkla görülebilir. Bu çerçevede parametre varyansları ve kovaryansları hata teriminin varyansı ifadesinin doğrusal bir fonksiyonudur.
Hata Teriminin Varyansı
Aşağıda yapılacak işlemlerde matrisinin sütun vektörü olduğu varsayılmıştır. Konuyla ilgili daha fazla bilgi için “Genel Doğrusal Modelin Varsayımları” isimli makalenin 5. Varsayım konusunda yer alan 5.2 no.lu not ve devamında yer alan matrislere ilişkin yapılan açıklamalar veya “Matris Cebiri ile En Küçük Kareler Yöntemi” isimli makale gözden geçirilebilir.
En küçük kareler yönteminde hata teriminin varyansını temsil eden ifadesini elde etmek için herhangi bir yöntem bulunmamaktadır. Ancak yukarıda gösterildiği gibi parametre varyanslarının elde edilebilmesi için hata teriminin varyansına da ihtiyaç duyulmaktadır. Bununla birlikte Maksimum Olabilirlik (Maximum Likelihood) yönteminde hata teriminin varyansı aşağıdaki denklem ile elde edilir.
 (3.4)
EKK ile hata teriminin varyansını elde etmek için yukarıdaki maksimum olabilirlik yöntemine ilişkin denklemin uyarlanmış formundan yararlanılır. Söz konusu uyarlama işlemi ise tahmin edilen hata terimlerinin kareleri toplamının serbestlik derecesine bölümüdür.
 (3.5)
En Küçük Kareler Yönteminde Hata Teriminin Varyansı
“k” modelde bulunan (sabit terim dahil) parametre sayısı ve “n” gözlem sayısı olmak üzere serbestlik derecesi n-k olarak tanımlanır. EKK yönteminde tahmin edilen hata teriminin varyansını elde etmek için 3.5 no.lu denklemin payında yer alan stokastik özellikli  ifadesinin deterministik özellikli açıklanan (Y) ve açıklayıcı (X) değişkenler cinsinden ifade edilmesi gerekir. Bu amaçla hata teriminin varyansını elde etmek için örnekleme dayalı II no.lu denklemden hareket edilir.
ifadesi yalnız bırakılır.

Denklem sisteminin her iki tarafı da soldan kendi transpozu ile çarpılır.
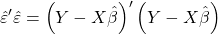
Yukarıdaki denklem sistemi 3.5 no.lu denklemde yerine yazılır.
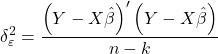
Yukarıdaki denklem sisteminde yerine, tamamen deterministik kısımlardan oluşan 1.1 no.lu denklem sistemi yazılır.

3.2 no.lu nota göre parantez dışındaki transpoze parantez içine aktarılır.
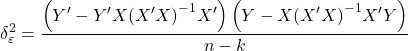
Parantez içindeki ifadeler, sağ/sol sırası gözetilerek (yani konumlarında herhangi bir değişiklik yapılmadan) birbirleri ile çarpılır.

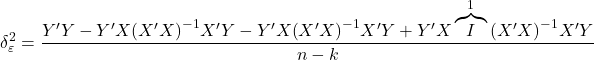
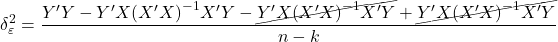
Böylece hata teriminin varyansı elde edilir.
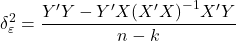 (3.6) |
3.6 no.lu denklem sisteminden devam edilir.
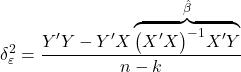
Yukarıdaki denklem sisteminde işaretlenen bölümün yerine 1.1 no.lu denklem sistemi yazılabilir.
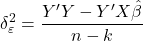 (3.7) |
Tekrar 3.6 no.lu denklem sisteminden devam edilir.
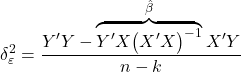
Yukarıdaki denklem sisteminde işaretlenen bölümün yerine, “Matris Cebiri ile En Küçük Kareler Yöntemi” isimli makalede yer alan 1.6 no.lu denklem sistemi olan 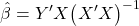 yazılabilir.
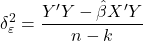 (3.8) |
Maksimum Olabilirlik Yönteminde Hata Teriminin Varyansı
Maksimum olabilirlik yönteminde tahmin edilen hata teriminin varyansını elde etmek için 3.4 no.lu denklemin payında yer alan stokastik özellikli ifadesinin deterministik özellikli açıklanan (Y) ve açıklayıcı (X) değişkenler cinsinden ifade edilmesi gerekir. Bu amaçla hata teriminin varyansını elde etmek için örnekleme dayalı II no.lu denklemden hareket edilir.
ifadesi yalnız bırakılır.
Denklem sisteminin her iki tarafı da soldan kendi transpozu ile çarpılır.
Yukarıdaki denklem sistemi 3.4 no.lu denklemde yerine yazılır.

Yukarıdaki denklem sisteminde yerine, tamamen deterministik kısımlardan oluşan 1.1 no.lu denklem sistemi yazılır.
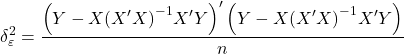
3.2 no.lu nota göre parantez dışındaki transpoze parantez içine aktarılır.
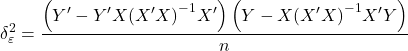
Parantez içindeki ifadeler, sağ/sol sırası gözetilerek (yani konumlarında herhangi bir değişiklik yapılmadan) birbirleri ile çarpılır.

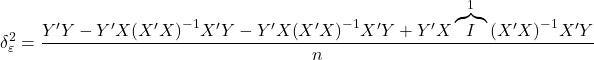

Böylece hata teriminin varyansı elde edilir.
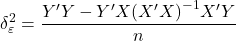 (3.9) |
EKK yönteminde hata teriminin varyansını farklı şekilde ifade etmek için yukarıdaki denklem sisteminde yerine, matrisinin eşiti yazılmıştı. Ancak parametre tahmin edicileri EKK yöntemiyle elde edildiğinden, maksimum olabilirlik yöntemiyle elde edilecek hata teriminin varyansında kullanılamaz. Bu çerçevede 3.9 no.lu denklemden devam edilir.
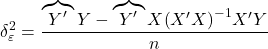
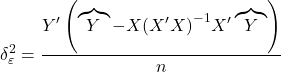
Matrislerde bir matrisin sağdan veya soldan çarpımı belirleyici bir özellik olduğundan, yukarıda da  matrisleri soldan, matrisleri ise sağdan parantez dışına alınmıştır.

nxn boyutlu 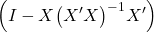 ifadesinin yine nxn boyutlu K matrisine eşit olduğu kabul edilerek maksimum olabilirlik yönteminde hata teriminin varyansı, 1×1 boyutlu bir skalere eşit olan
 denklem sisteminin “n” ifadesine bölümü olup aşağıdaki şekilde de ifade edilebilir.
 (3.10) |
Minimum Varyans ve Etkinlik
Etkinlik, sapmasız tahmin ediciler arasında minimum varyansa sahip olan tahmin edici olarak tanımlanabilir. EKK tahmin edicisinin alternatif tahmin ediciler arasında minimum varyansa sahip, dolayısıyla etkin bir tahmin edici olduğunu ispatlamak amacıyla “Doğrusallık” konusunda yer alan aşağıdaki ilişkilerden yararlanılacaktır.
ve olmak üzere ifadesi aşağıdaki ifadeye eşitti.
 alternatif tahmin edicisini temsil etmek üzere, EKK tahmin edicisinin alternatif tahmin ediciler arasında minimum varyansa sahip, dolayısıyla etkin bir tahmin edici olduğunu ispatlamak amacıyla alternatif tahmin edicisi aşağıdaki şekilde tanımlanır.
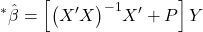 (3.11)
Yukarıdaki denklem sisteminin çözümünün parametre tahmin edicilerini içeren kx1 boyutlu bir matrise eşit olabilmesi için P matrisinin kxn boyutlu ve X matrisleri gibi deterministik olduğu varsayılmıştır.
 ifadesi bir matris olmak üzere aşağıdaki ifadeye eşit olduğu varsayılır.
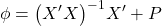
Bu durumda 3.11 no.lu denklem aşağıdaki şekilde ifade edilebilir.

“Matris Cebiri ile En Küçük Kareler Yöntemi” isimli makalenin 1.4 no.lu notunda gösterildiği gibi ifadesi, kxn, Y ifadesi de nx1 boyutlu bir matrise eşittir. Bu durumda matrisi de beklendiği gibi kx1 boyutlu (yani k adet parametrenin alternatif tahmin edicilerini içeren) bir sütun vektörüdür.
kx1 boyutlu alternatif parametre tahmin edicileri, Y ifadesinin X değişkenlerine (yani ifadesine) göre ağırlıklandırılmış bir ortalaması olduğundan, EKK ile elde edilen parametre tahmin edicileri gibi doğrusal bir tahmin edicidir.
EKK dışında elde edilen alternatif tahmin edicilerin sapmasız olduğunu göstermek için 3.11 no.lu denklemden devam edilir.
I no.lu denklem (popülasyona ait gerçek model) yukarıdaki denklemde yerine yazılır.
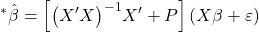
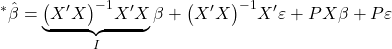
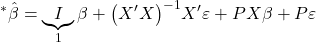
A bir matris ve I birim matris olmak üzere , ve olur. Bir matrisi, kendi tersi ile çarpmak birim matrisi verdiğinden ve birim matrisin determinantı da 1 olduğundan, yoluyla sütun vektörü yalnız bırakılmış olur.
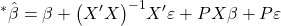 (3.12)
3.12 no.lu denklem sistemine beklenen değer operatörü ilave edilir.
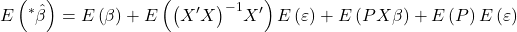
, X ve P matrisleri birer sabit olduğundan beklenen değerleri kendilerine eşittir.
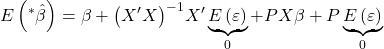
Hata terimlerinin beklenen değeri sıfırdır.
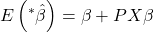 (3.13)
alternatif parametre tahmin edicilerinin sapmasız olması için  olması gerekir. varsayımında yukarıdaki ifade aşağıdaki şekilde ifade edilir.
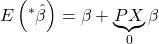
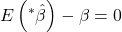 (3.14) |
varsayımının geçerli olması durumunda, alternatif tahmin edicilerinin beklenen değerinin popülasyon (gerçek modelin) parametresi olan ifadelerine eşit olması, tahmin edicilerinin (gerçek modelin parametrelerine göre) sapmasız olduğunu ifade eder.
alternatif tahmin edicisinin sapmasız olduğu ispatlandıktan sonra varyansına geçilir.
Varyans, tanım gereği bir değişkenin kendi ortalamasından farklarının kareleri toplamı olduğundan, 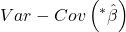 matrisini elde etmek için kx1 boyutlu
 matrisi “sağdan” (1xk boyutlu) transpozu ile çarpılarak beklenen değeri alınır.
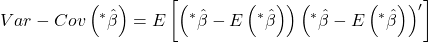

3.14 no.lu denklem sisteminden hareketle  yerine yazılır.

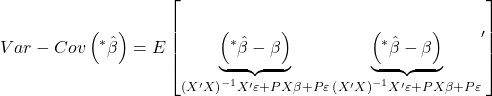
3.12 no.lu denklem sisteminden hareketle  yerine
 yazılır.
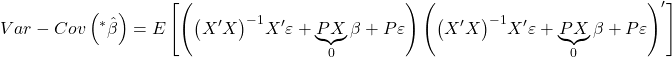
alternatif parametre tahmin edicilerinin sapmasız olması için varsayımının geçerli olması gerektiğinden ve etkinlik sapmasız tahmin ediciler arasında minimum varyansa sahip olan tahmin edici olduğundan, olduğu kabul edilir.
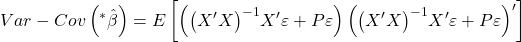
3.2 no.lu nota göre parantez dışında yer alan transpoze parantez içine dağıtılır.
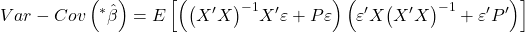
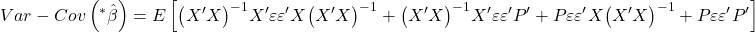
Beklenen değer operatörü parantez içine dağıtılır.
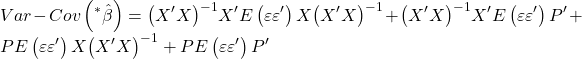
X ve P matrisleri deterministik ve bu sebeple de birer sabit olduğu için beklenen değerleri kendisine eşit olduğundan yukarıda beklenen değer operatörü ile gösterilmemiştir.
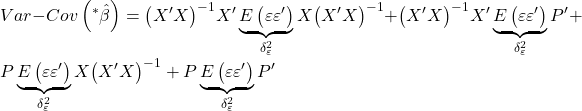
“Genel Doğrusal Modelin Varsayımları” isimli makalenin 5. Varsayım konusunda olduğundan yukarıdaki denklem sisteminde yerine yazılır.
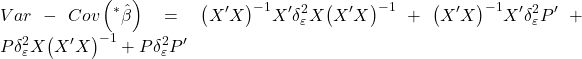
Hata teriminin sabit olan varyansını temsil eden ifadesi skaler bir büyüklük olup bir sabittir. Bu yüzden yukarıdaki denklem sisteminde herhangi bir yerde konumlandırılabildiğinden en sola alınabilir.
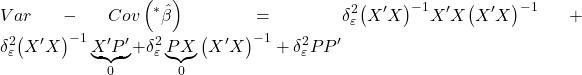
kxn boyutlu P matrisi ile nxk boyutlu X matrisinin çarpımı olan kxk boyutlu olduğu için onun devriğini temsil eden kxn boyutlu  matrisi ile nxk boyutlu
 matrisinin çarpımı olan kxk boyutlu
 olur. Bu yüzden yukarıdaki denklem sisteminde
 ve
 ifadelerinin yerine sıfır yazılır.
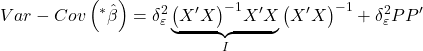
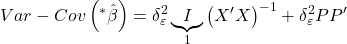
I birim matrisi de 1 skalerine eşit olduğundan alternatif tahmin edicilerinin varyansları ve kovaryansları elde edilir.
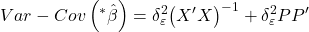 (3.15) |
alternatif tahmin edicisinin varyansı 3.15 no.lu denklem sisteminde elde edilmiş oldu. Denklem sisteminin solunda yer alan ifadenin ise tahmin edicisinin varyansı olduğu göz önüne alınırsa, alternatif tahmin edicisinin varyansının tahmin edicisinin varyansından büyük olduğu kolaylıkla fark edilebilir.
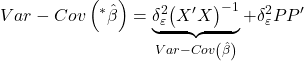
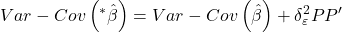
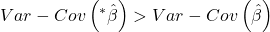
O halde, doğrusal tahmin edicisi gibi doğrusal alternatif tahmin edicisi sapmasız olsa bile, tahmin edicisinin varyansı, alternatif tahmin edicisinin varyansından küçük olduğu için tahmin edicisi “etkin” bir tahmin edicidir.
Yukarıdaki koşulda parametre tahmin edicilerinin varyansı minimum varyansa sahip etkin tahmin edicilerdir. Bir tahmin edicinin minimum varyansa sahip etkin bir tahmin edici olabilmesi için aşağıdaki üç koşulu sağlaması gerekir.
- Açıklayıcı değişkenlerin deterministik (gözlem değerlerinin) olması (
 ),
- Hata terimlerinin toplamının (yani beklenen değerinin) sıfır olması (
 ),
- Hata teriminin varyansının sabit olması (
 ).
 ),
4. Asimptotik Sapmasızlık
Asimptotik sapmasızlık büyük örneklem özelliğidir. Gözlem sayısı n sonsuza giderken tahmin edicilerinin beklenen değerinin popülasyon parametreleri olan ifadelerine eşit olmasını temsil eder.
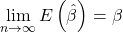
Kolaylıkla fark edilebileceği gibi sapmasız tahmin ediciler aynı zamanda asimptotik olarak da sapmasızdırlar. Ancak sapmasız olmayan bir tahmin edici asimptotik olarak sapmasız olabilir. Diğer bir ifadeyle asimptotik olarak sapmasız tahmin ediciler daima sapmasız olmayabilir.
5. Tutarlılık
Büyük örneklem özelliklerden olan tutarlılık, gözlem sayısı n sonsuza giderken (asimptotik bakımdan) tahmin edicilerinin popülasyon parametreleri olan ifadelerine eşit olmasını temsil eder.

Tutarlılık, yukarıdaki tanım gereği gözlem sayısı n sonsuza giderken tahmin edicilerinin varyansının sıfıra yaklaşmasını/eşit olmasını ifade eder.
Bir tahmin edicinin tutarlı olabilmesi için aşağıdaki iki koşulu sağlaması gerekir.
- Gözlem sayısı n sonsuza giderken tahmin edicinin varyansının sıfır olması (
 ),
- Tahmin edicinin (sapmasız olmasa da en azından) asimptotik olarak sapmasız olması (
 ),
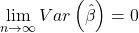 ),
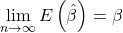 ),
6. Asimptotik Etkinlik
Büyük örneklem özelliklerinden olan asimptotik etkinlik, tahmin edicilerinin sonlu bir beklenen değeri ve varyansı olmak üzere, gözlem sayısı n sonsuza giderken tutarlı tahmin ediciler arasından minimum varyansa sahip tahmin ediciler olarak tanımlanabilir.
ve  olmak üzere,
 ise tahmin edicileri asimptotik olarak etkin birer tahmin edicidir.
İshak Kutlu, Ekonometri Notları