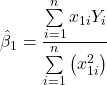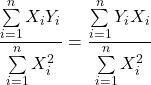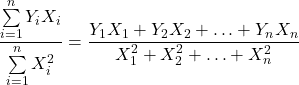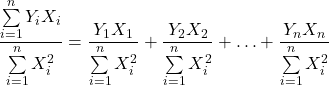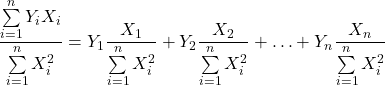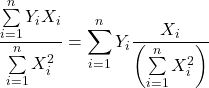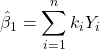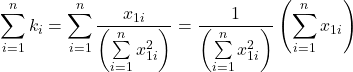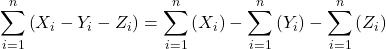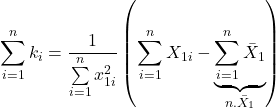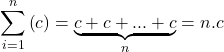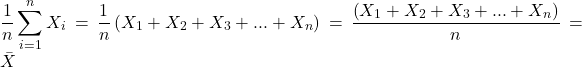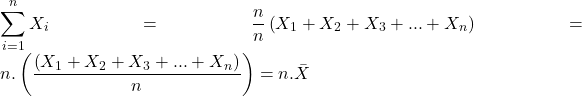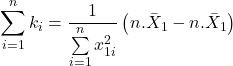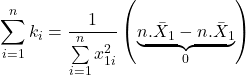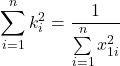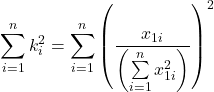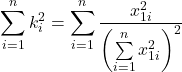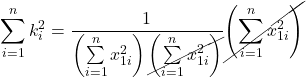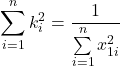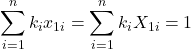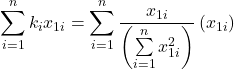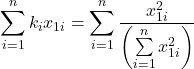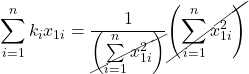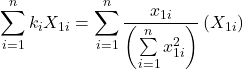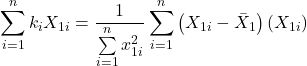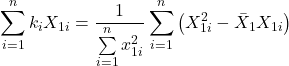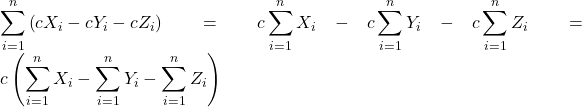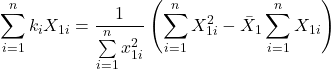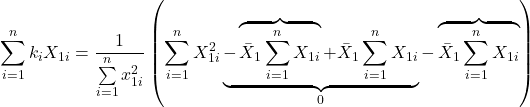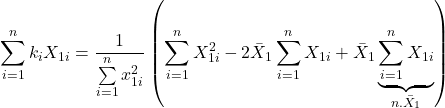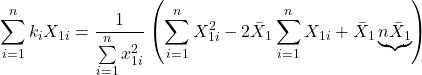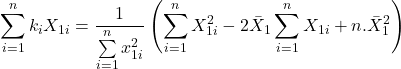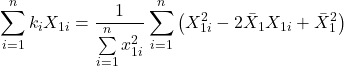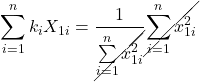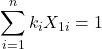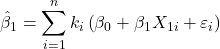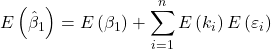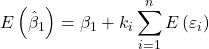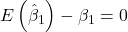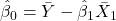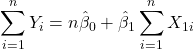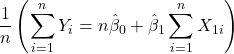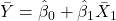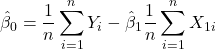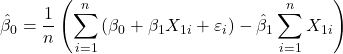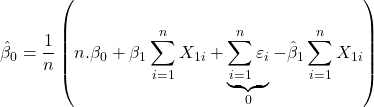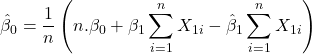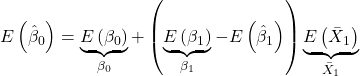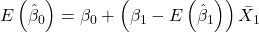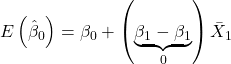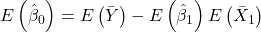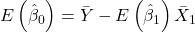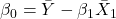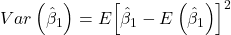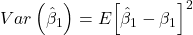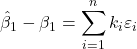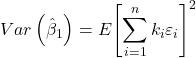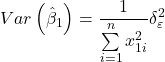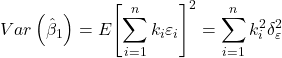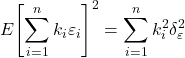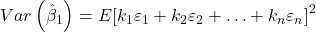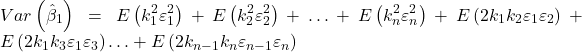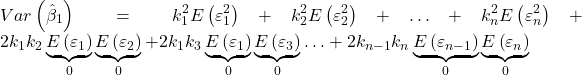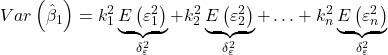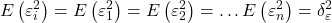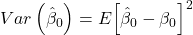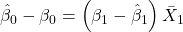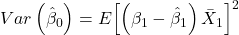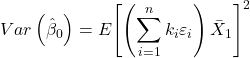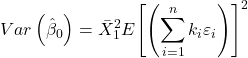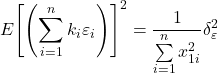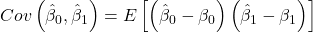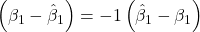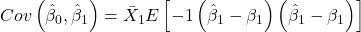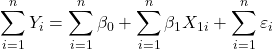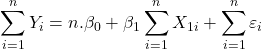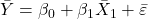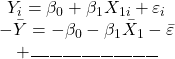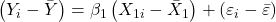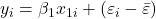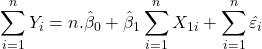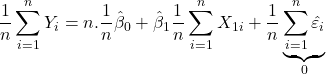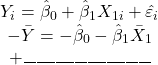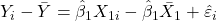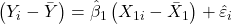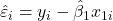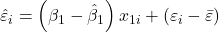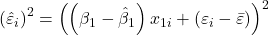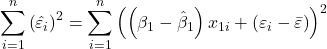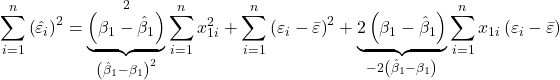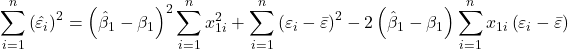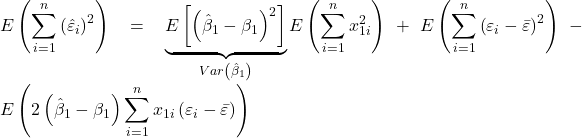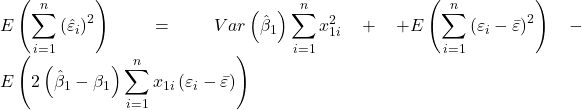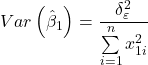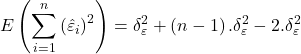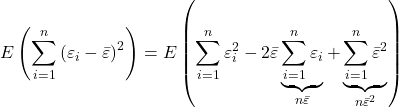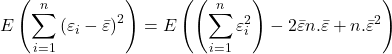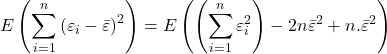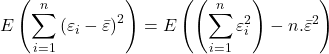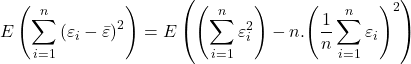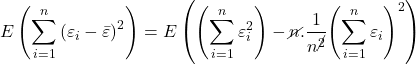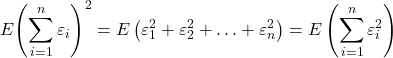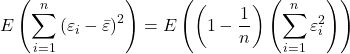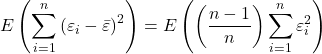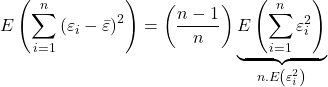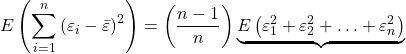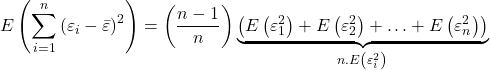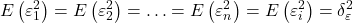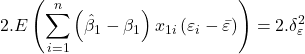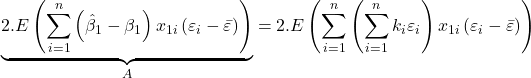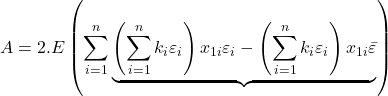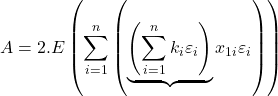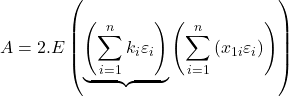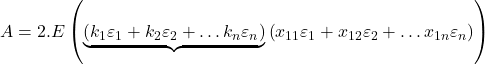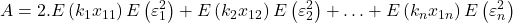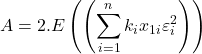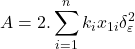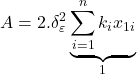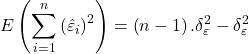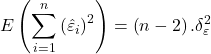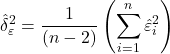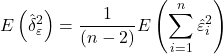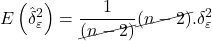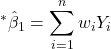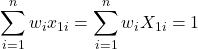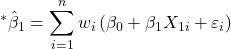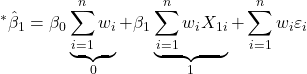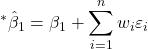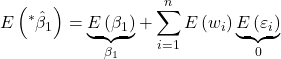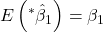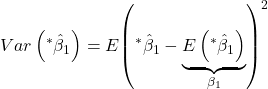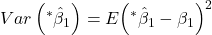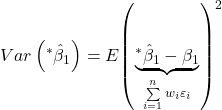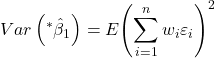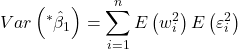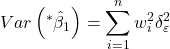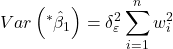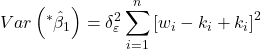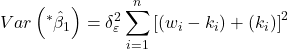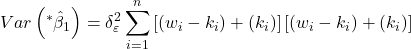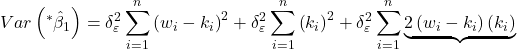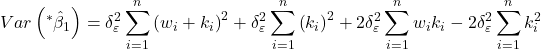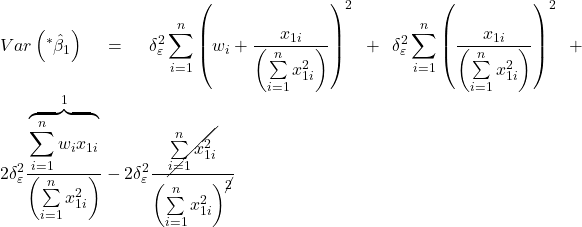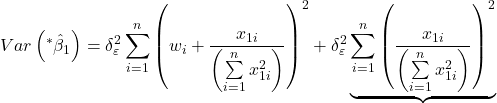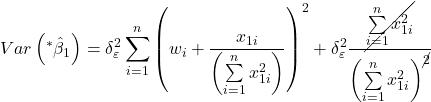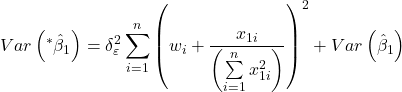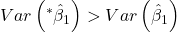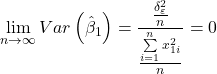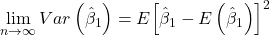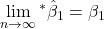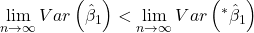
Tahmin Edicilerde Aranan Özellikler

T


Tahmin edicilerde aranan özelliklere geçmeden önce popülasyon parametresi ve tahmin edici ayrımının vurgulanması yararlı olacaktır. Aşağıda yer alan bir sabit ve açıklayıcı değişkenli spesifik model popülasyona ilişkin gerçek bir modeli temsil eder.
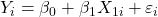
\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}                  (I)

\displaystyle {\beta _0}, \displaystyle {\beta _1} gibi parametrelerin ve \displaystyle {\varepsilon _i} hata teriminin üzerinde şapka (hat) işareti olmayan ifadeler, popülasyona ilişkin gerçek modelin parametreleri/hata terimleri olup pratikte bunları elde etmek/hesaplamak mümkün olmaz. Bu yüzden EKK yönteminde temel amaç, popülasyona ait gerçek modelin parametrelerini en az sapma/hata ile örnekleme dayanarak tahmin etmektir. Bu kapsamda aşağıdaki model (yukarıda yer alan popülasyona ilişkin gerçek modeli yansıttığı düşünülen) örnekleme dayanılarak elde edilen modeli temsil eder.
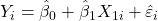
\displaystyle {Y_i} = {\hat \beta _0} + {\hat \beta _1}{X_{1i}} + {\hat \varepsilon _i}                     (II)

\displaystyle {\hat \beta _0}, \displaystyle {\hat \beta _1} gibi parametrelerin ve \displaystyle {\hat \varepsilon _i} hata teriminin üzerinde şapka (hat) işareti olan ifadeler, örnekleme ilişkin tahmin edilen modelin parametreleri (diğer bir ifadeyle tahmin ediciler/tahmin edilen hata terimleri) olup pratikte bunları elde etmek/hesaplamak mümkündür. Ancak \displaystyle {\hat \beta _0}, \displaystyle {\hat \beta _1} gibi tahmin edicilerin popülasyona ait gerçek modelin parametreleri ile belirli ilişkisel özellikler göstermesi beklenir.  Bu yüzden tahmin edicilerde aranan özellikler başlığı altında, örnekleme dayanılarak tahmin (elde) edilen parametrelerin ve hata terimlerinin, gerçek modelin parametreleri ve hata terimleri ile aralarında olması gereken ideal ilişkileri ele alınacaktır.

1.  Doğrusallık

EKK ile elde edilen tahmin edicilerin açıklayıcı değişkenlerin doğrusal bir fonksiyonu olduğunun ispatı, anlatım kolaylığı sağlaması amacıyla yukarıdaki I ve II no.lu spesifik modeller üzerinden gösterilecektir.

\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}

\displaystyle {Y_i} = {\hat \beta _0} + {\hat \beta _1}{X_{1i}} + {\hat \varepsilon _i}

En Küçük Kareler Yöntemi” isimli makalenin 2.7 no.lu denkleminde, \displaystyle {\beta _1} parametresinin tahmin edicisi (\displaystyle {\hat \beta _1}) aşağıdaki formda elde edilmişti.

\displaystyle {\hat \beta _1} = \frac{{\sum\limits_{i = 1}^n {{x_{1i}}{Y_i}} }}{{\sum\limits_{i = 1}^n {\left( {x_{1i}^2} \right)} }}                                        (1.1)

Yukarıda bahsi geçen makalede \displaystyle {x_{1i}} = {X_{1i}} - {\bar X_1} olarak tanımlanmıştı.

Not 1.1: X, Y birer değişken olmak üzere toplam sembolü için aşağıdaki ilişkiler tanımlıdır.

\displaystyle \frac{{\sum\limits_{i = 1}^n {{X_i}{Y_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }} = \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }}

\displaystyle \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }} = \frac{{{Y_1}{X_1} + {Y_2}{X_2} +  \ldots  + {Y_n}{X_n}}}{{X_1^2 + X_2^2 +  \ldots  + X_n^2}}

\displaystyle \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }} = \frac{{{Y_1}{X_1}}}{{X_1^2 + X_2^2 +  \ldots  + X_n^2}} + \frac{{{Y_2}{X_2}}}{{X_1^2 + X_2^2 +  \ldots  + X_n^2}} +  \ldots  + \frac{{{Y_n}{X_n}}}{{X_1^2 + X_2^2 +  \ldots  + X_n^2}}

\displaystyle \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }} = \frac{{{Y_1}{X_1}}}{{\sum\limits_{i = 1}^n {X_i^2} }} + \frac{{{Y_2}{X_2}}}{{\sum\limits_{i = 1}^n {X_i^2} }} +  \ldots  + \frac{{{Y_n}{X_n}}}{{\sum\limits_{i = 1}^n {X_i^2} }}

\displaystyle \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }} = {Y_1}\frac{{{X_1}}}{{\sum\limits_{i = 1}^n {X_i^2} }} + {Y_2}\frac{{{X_2}}}{{\sum\limits_{i = 1}^n {X_i^2} }} +  \ldots  + {Y_n}\frac{{{X_n}}}{{\sum\limits_{i = 1}^n {X_i^2} }}

\displaystyle \frac{{\sum\limits_{i = 1}^n {{Y_i}{X_i}} }}{{\sum\limits_{i = 1}^n {X_i^2} }} = \sum\limits_{i = 1}^n {{Y_i}\frac{{{X_i}}}{{\left( {\sum\limits_{i = 1}^n {X_i^2} } \right)}}}

1.1 no.lu nota göre yukarıdaki ifade aşağıdaki şekilde ifade edilebilir.
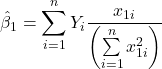
\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{Y_i}\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}}

\displaystyle {k_i} = \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}} olmak üzere, yukarıdaki denklemde yerine yazılır.

\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{k_i}{Y_i}}                                            (1.2)

\displaystyle {\hat \beta _1} parametresinin tahmin edicisi, \displaystyle {Y_i} ifadesinin \displaystyle {X_{1i}} değişkenine (yani \displaystyle {k_i} ifadesine) göre ağırlıklandırılmış bir ortalaması olduğundan doğrusal bir tahmin edicidir.

Ağırlıklandırılmış k_i İfadesinin Özellikleri

  1. Açıklayıcı değişken \displaystyle {X_{1i}} ifadeleri deterministik (gözlem değerleri) olduğu için \displaystyle {k_i} ifadesi de deterministiktir.
  2. \displaystyle {k_i} ifadelerinin toplamı sıfırdır, \displaystyle \sum\limits_{i = 1}^n {{k_i}} = 0.

İspat:

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = \sum\limits_{i = 1}^n {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}}  = \frac{1}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}\left( {\sum\limits_{i = 1}^n {{x_{1i}}} } \right)

\displaystyle {x_{1i}} = {X_{1i}} - {\bar X_1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {\left( {{X_{1i}} - {{\bar X}_1}} \right)} } \right)

Not 1.2: X, Y, Z birer değişken veya sabit olmak üzere, toplam sembolünün dağılma özelliği vardır;\displaystyle \sum\limits_{i = 1}^n {\left( {{X_i} - {Y_i} - {Z_i}} \right)}  = \sum\limits_{i = 1}^n {\left( {{X_i}} \right)}  - \sum\limits_{i = 1}^n {\left( {{Y_i}} \right)}  - \sum\limits_{i = 1}^n {\left( {{Z_i}} \right)}

1.2 no.lu notta belirtildiği gibi toplam sembolü parantez içine dağıtılır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {{X_{1i}}}  - \underbrace {\sum\limits_{i = 1}^n {{{\bar X}_1}} }_{n.{{\bar X}_1}}} \right)

Not 1.3: c bir sabit olmak üzere, \displaystyle \sum\limits_{i = 1}^n {\left( c \right)}  = \underbrace {c + c + ... + c}_n = n.c ifadesine eşit olur.

\displaystyle {\bar X_1} ifadesi bir sabit olduğu için 1.3 no.lu notta belirtilen özellik uygulanır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\underbrace {\sum\limits_{i = 1}^n {{X_{1i}}} }_{n.{{\bar X}_1}} - n.{{\bar X}_1}} \right)

Not 1.4: X bir değişken ve \displaystyle \bar X ifadesi X değişkeninin aritmetik ortalamasını temsil etmek üzere,

\displaystyle \frac{1}{n}\sum\limits_{i = 1}^n {{X_i}}  = \frac{1}{n}\left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right) = \frac{{\left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right)}}{n} = \bar X ya da

\displaystyle \sum\limits_{i = 1}^n {{X_i}}  = \frac{n}{n}\left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right) = n.\left( {\frac{{\left( {{X_1} + {X_2} + {X_3} + ... + {X_n}} \right)}}{n}} \right) = n.\bar X olur.

1.4 no.lu notta belirtilen özellik uygulanır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {n.{{\bar X}_1} - n.{{\bar X}_1}} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\underbrace {n.{{\bar X}_1} - n.{{\bar X}_1}}_0} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}}  = 0                                             (1.3)
  1. \displaystyle {k_i} ifadelerinin kareleri toplamı, \displaystyle {x_{1i}} ifadelerinin kareleri toplamının çarpmaya göre tersine eşittir, \displaystyle \sum\limits_{i = 1}^n {k_i^2} = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}.

İspat:

\displaystyle \sum\limits_{i = 1}^n {k_i^2}  = {\sum\limits_{i = 1}^n {\left( {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)} ^2}

\displaystyle \sum\limits_{i = 1}^n {k_i^2}  = \sum\limits_{i = 1}^n {\frac{{x_{1i}^2}}{{{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}^2}}}}

\displaystyle \sum\limits_{i = 1}^n {k_i^2}  = \frac{1}{{{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}^2}}}\sum\limits_{i = 1}^n {x_{1i}^2}

\displaystyle \sum\limits_{i = 1}^n {k_i^2}  = \frac{1}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)\cancel{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}}}\cancel{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}

\displaystyle \sum\limits_{i = 1}^n {k_i^2}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}                                       (1.4)
  1. \displaystyle {k_i} ifadelerinin \displaystyle {x_{1i}} veya \displaystyle {X_{1i}} ifadeleri ile çarpımlarının toplamı 1’e eşittir, \displaystyle \sum\limits_{i = 1}^n {{k_i}{x_{1i}}} = \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = 1.

İspat:

\displaystyle \sum\limits_{i = 1}^n {{k_i}{x_{1i}}}  = \sum\limits_{i = 1}^n {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \left( {{x_{1i}}} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}{x_{1i}}}  = \sum\limits_{i = 1}^n {\frac{{x_{1i}^2}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}}

\displaystyle \sum\limits_{i = 1}^n {{k_i}{x_{1i}}}  = \frac{1}{{\cancel{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}}}\cancel{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}

\displaystyle \sum\limits_{i = 1}^n {{k_i}{x_{1i}}}  = 1                                               (1.5)

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \sum\limits_{i = 1}^n {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \left( {{X_{1i}}} \right)

\displaystyle {x_{1i}} = {X_{1i}} - {\bar X_1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \sum\limits_{i = 1}^n {\frac{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \left( {{X_{1i}}} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\sum\limits_{i = 1}^n {\left( {{X_{1i}} - {{\bar X}_1}} \right)} \left( {{X_{1i}}} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\sum\limits_{i = 1}^n {\left( {X_{1i}^2 - {{\bar X}_1}{X_{1i}}} \right)}

Not 1.5: X, Y, Z birer değişken ve c bir sabit olmak üzere, c sabiti toplam sembolünün dışında ifade edilebilir;\displaystyle \sum\limits_{i = 1}^n {\left( {c{X_i} - c{Y_i} - c{Z_i}} \right)}  = c\sum\limits_{i = 1}^n {\left( {{X_i} - {Y_i} - {Z_i}} \right)}  = \sum\limits_{i = 1}^n {c{X_i}}  - \sum\limits_{i = 1}^n {c{Y_i}}  - \sum\limits_{i = 1}^n {c{Z_i}}

\displaystyle \sum\limits_{i = 1}^n {\left( {c{X_i} - c{Y_i} - c{Z_i}} \right)}  = c\sum\limits_{i = 1}^n {{X_i}}  - c\sum\limits_{i = 1}^n {{Y_i}}  - c\sum\limits_{i = 1}^n {{Z_i}}  = c\left( {\sum\limits_{i = 1}^n {{X_i}}  - \sum\limits_{i = 1}^n {{Y_i}}  - \sum\limits_{i = 1}^n {{Z_i}} } \right)

1.5 no.lu notta belirtilen toplam sembolünün dağılma özelliği uygulanır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - \sum\limits_{i = 1}^n {{{\bar X}_1}{X_{1i}}} } \right)

\displaystyle {\bar X_1} bir sabit olduğundan toplam sembolünün dışına alınabilir.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - {{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}} } \right)

Amaç, parantez içindeki ifadeleri kendi ortalamasından farklar şeklinde ifade edebilmektir. Bu yüzden yukarıdaki denklemin eşitliği bozulmayacak şekilde aşağıdaki ifadeler denkleme ilave edilir.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {X_{1i}^2} \underbrace { - \overbrace {{{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}} }^{} + {{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}} }_0 - \overbrace {{{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}} }^{}} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - 2{{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}}  + {{\bar X}_1}\underbrace {\sum\limits_{i = 1}^n {{X_{1i}}} }_{n.{{\bar X}_1}}} \right)

1.4 no.lu notta belirtilen özellik uygulanır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - 2{{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}}  + {{\bar X}_1}\underbrace {n{{\bar X}_1}}_{}} \right)

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\left( {\sum\limits_{i = 1}^n {X_{1i}^2}  - 2{{\bar X}_1}\sum\limits_{i = 1}^n {{X_{1i}}}  + n.\bar X_1^2} \right)

1.5 no.lu notta belirtilen toplam sembolünün dağılma özelliği tersine şekilde uygulanır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\sum\limits_{i = 1}^n {\left( {X_{1i}^2 - 2{{\bar X}_1}{X_{1i}} + \bar X_1^2} \right)}

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\sum\limits_{i = 1}^n {{{\left( {{X_{1i}} - {{\bar X}_1}} \right)}^2}}

\displaystyle {x_{1i}} = {X_{1i}} - {\bar X_1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = \frac{1}{{\cancel{{\sum\limits_{i = 1}^n {x_{1i}^2} }}}}\cancel{{\sum\limits_{i = 1}^n {x_{1i}^2} }}

\displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = 1                                              (1.6)

2.  Sapmasızlık

Sapmasızlık, örnekleme dayanılarak tahmin edilen \displaystyle \hat \beta  parametrelerinin popülasyona ait gerçek modelin \displaystyle \beta  parametrelerinin beklenen değerine eşit olmasını ifade eder. EKK ile elde edilen tahmin edicilerin sapmasız olduğunu göstermek için 1.2 no.lu denklemden devam edilir ve öncelikle \displaystyle {\hat \beta _1} ifadesinin sapmasız olduğu ispat edilir.

\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{k_i}{Y_i}}

I no.lu denklem (popülasyona ait gerçek model) yukarıdaki denklemde yerine yazılır.

\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{k_i}\left( {{\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}} \right)}

1.5 no.lu notta belirtilen toplam sembolünün dağılma özelliği uygulanır.

\displaystyle {\hat \beta _1} = {\beta _0}\underbrace {\sum\limits_{i = 1}^n {{k_i}} }_0 + {\beta _1}\underbrace {\sum\limits_{i = 1}^n {{k_i}{X_{1i}}} }_1 + \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}

1.3 no.lu denklemde \displaystyle \sum\limits_{i = 1}^n {{k_i}}  = 0 ve 1.6 no.lu denklemde de \displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = 1 olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle {\hat \beta _1} = {\beta _1} + \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}

Beklenen değer operatörü ilave edilir.

\displaystyle E\left( {{{\hat \beta }_1}} \right) = E\left( {{\beta _1}} \right) + \sum\limits_{i = 1}^n {E\left( {{k_i}} \right)E\left( {{\varepsilon _i}} \right)}

\displaystyle {k_i} açıklayıcı değişkenlerden oluştuğu için bir sabit ve bir sabitin beklenen değeri de kendisine eşittir. Benzer şekilde popülasyon parametresi olan \displaystyle {\beta _1} de bir sabit olduğu için beklenen değeri kendisine eşittir.

\displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} + {k_i}\sum\limits_{i = 1}^n {E\left( {{\varepsilon _i}} \right)}

Hata teriminin beklenen değeri sıfır olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} + {k_i}\left[ {\underbrace {E\left( {{\varepsilon _1}} \right)}_0 + \underbrace {E\left( {{\varepsilon _2}} \right)}_0 +  \ldots  + \underbrace {E\left( {{\varepsilon _n}} \right)}_0} \right]

Kısaca aşağıdaki gibi de ifade edilebilir.

\displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} + {k_i}n.\underbrace {E\left( {{\varepsilon _i}} \right)}_0

Dolayısıyla \displaystyle {\hat \beta _1} tahmin edicisinin beklenen değeri popülasyon parametresi olan \displaystyle {\beta _1} ifadesine eşittir.

\displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1}

\displaystyle E\left( {{{\hat \beta }_1}} \right) - {\beta _1} = 0                                (2.1)

\displaystyle {\hat \beta _1} tahmin edicisinin beklenen değerinin popülasyon (gerçek modelin) parametresi olan \displaystyle {\beta _1} ifadesine eşit olması, \displaystyle {\hat \beta _1} tahmin edicisinin (gerçek modelin parametresine göre) sapmasız olduğunu ifade eder.

\displaystyle {\hat \beta _0} ifadesinin  (yani sabitin) sapmasız olduğunun ispatı için “En Küçük Kareler Yöntemi” isimli makalenin 1.3 no.lu denkleminde elde edilen \displaystyle {\beta _0} parametresinin tahmin edicisinden hareket edilecektir.

\displaystyle {\hat \beta _0} = \bar Y - {\hat \beta _1}{\bar X_1}

Yukarıdaki \displaystyle {\hat \beta _0} parametresinin tahmin edicisi, II no.lu denklemden hareketle aşağıdaki şekilde de elde edilebilir.

\displaystyle {Y_i} = {\hat \beta _0} + {\hat \beta _1}{X_{1i}} + {\hat \varepsilon _i}

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = \sum\limits_{i = 1}^n {{{\hat \beta }_0}}  + \sum\limits_{i = 1}^n {{{\hat \beta }_1}{X_{1i}}}  + \sum\limits_{i = 1}^n {{{\hat \varepsilon }_i}}

1.3 ve 1.5 no.lu notlarda belirtilen özelliklerden hareketle yukarıdaki denklem aşağıda şekilde ifade edilebilir.

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = n{\hat \beta _0} + {\hat \beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}  + \underbrace {\sum\limits_{i = 1}^n {{{\hat \varepsilon }_i}} }_0

Hata terimlerinin toplamı sıfır olduğu için denklemde yerine yazılır.

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = n{\hat \beta _0} + {\hat \beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}

Yukarıdaki denklem 1/n ile çarpılarak denklem ortalamalar cinsinden ifade edilmiş olur.

\displaystyle \frac{1}{n}\left( {\sum\limits_{i = 1}^n {{Y_i}}  = n{{\hat \beta }_0} + {{\hat \beta }_1}\sum\limits_{i = 1}^n {{X_{1i}}} } \right)

1.4 no.lu notta belirtilen özellik uygulanır.

\displaystyle \bar Y = {\hat \beta _0} + {\hat \beta _1}{\bar X_1}

\displaystyle {\hat \beta _0} yalnız bırakılarak tahmin edicisi elde edilir.

\displaystyle {\hat \beta _0} = \bar Y - {\hat \beta _1}{\bar X_1}

\displaystyle {\hat \beta _0} tahmin edicisinin sapmasız olduğunu ispatlamak için 1.4 no.lu notta belirtilen özellikten yararlanılarak yukarıdaki denklem aşağıdaki şekilde düzenlenir.

\displaystyle {\hat \beta _0} = \frac{1}{n}\sum\limits_{i = 1}^n {{Y_i}}  - {\hat \beta _1}\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}

Denklem, 1/n ortak çarpan parantezine alınır.

\displaystyle {\hat \beta _0} = \frac{1}{n}\left( {\sum\limits_{i = 1}^n {{Y_i}}  - {{\hat \beta }_1}\sum\limits_{i = 1}^n {{X_{1i}}} } \right)

Popülasyona ait gerçek model olan I no.lu denklem yukarıdaki denklemde yerine yazılır.

\displaystyle {\hat \beta _0} = \frac{1}{n}\left( {\sum\limits_{i = 1}^n {\left( {{\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}} \right)}  - {{\hat \beta }_1}\sum\limits_{i = 1}^n {{X_{1i}}} } \right)

\displaystyle {\hat \beta _0} = \frac{1}{n}\left( {n.{\beta _0} + {\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}  + \underbrace {\sum\limits_{i = 1}^n {{\varepsilon _i}} }_0 - {{\hat \beta }_1}\sum\limits_{i = 1}^n {{X_{1i}}} } \right)

\displaystyle {\hat \beta _0} = \frac{1}{n}\left( {n.{\beta _0} + {\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}  - {{\hat \beta }_1}\sum\limits_{i = 1}^n {{X_{1i}}} } \right)

\displaystyle {\hat \beta _0} = \cancel{n}.\frac{1}{{\cancel{n}}}{\beta _0} + {\beta _1}\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}  - {\hat \beta _1}\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}

\displaystyle {\hat \beta _0} = {\beta _0} + {\beta _1}{\bar X_1} - {\hat \beta _1}{\bar X_1}

\displaystyle {\hat \beta _0} = {\beta _0} + \left( {{\beta _1} - {{\hat \beta }_1}} \right){\bar X_1}                           (2.2)

Beklenen değer operatörü ilave edilir.

\displaystyle E\left( {{{\hat \beta }_0}} \right) = \underbrace {E\left( {{\beta _0}} \right)}_{{\beta _0}} + \left( {\underbrace {E\left( {{\beta _1}} \right)}_{{\beta _1}} - E\left( {{{\hat \beta }_1}} \right)} \right)\underbrace {E\left( {{{\bar X}_1}} \right)}_{{{\bar X}_1}}

\displaystyle {\beta _0}, \displaystyle {\beta _1}, \displaystyle {\bar X_1} ifadeleri birer sabit ve bir sabitin beklenen değeri kendisine eşit olduğundan denklemde yerine yazılır.

\displaystyle E\left( {{{\hat \beta }_0}} \right) = {\beta _0} + \left( {{\beta _1} - E\left( {{{\hat \beta }_1}} \right)} \right){\bar X_1}

2.1 no.lu denklemden hareketle \displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle E\left( {{{\hat \beta }_0}} \right) = {\beta _0} + \left( {\underbrace {{\beta _1} - {\beta _1}}_0} \right){\bar X_1}

\displaystyle E\left( {{{\hat \beta }_0}} \right) = {\beta _0}

\displaystyle E\left( {{{\hat \beta }_0}} \right) - {\beta _0} = 0                                (2.3)

Alternatif İspat:

\displaystyle {\hat \beta _0} = \bar Y - {\hat \beta _1}{\bar X_1}

Beklenen değer operatörü ilave edilir.

\displaystyle E\left( {{{\hat \beta }_0}} \right) = E\left( {\bar Y} \right) - E\left( {{{\hat \beta }_1}} \right)E\left( {{{\bar X}_1}} \right)

\displaystyle E\left( {{{\hat \beta }_0}} \right) = \bar Y - E\left( {{{\hat \beta }_1}} \right){\bar X_1}

2.1 no.lu denklemden hareketle \displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle E\left( {{{\hat \beta }_0}} \right) = \bar Y - {\beta _1}{\bar X_1}

En Küçük Kareler Yöntemi” isimli makalenin 1.3 no.lu popülasyona ait sabitin denklemi -1 ile çarpılarak yukarıdaki denklem ile toplanır.

\displaystyle {\beta _0} = \bar Y - {\beta _1}{\bar X_1}

\displaystyle \left( { - 1} \right){\beta _0} = \left( { - 1} \right)\bar Y - \left( { - 1} \right){\beta _1}{\bar X_1}

\displaystyle \begin{array}{*{20}{c}}  { - {\beta _0} =  - \bar Y + {\beta _1}{{\bar X}_1}} \\  {E\left( {{{\hat \beta }_0}} \right) = \bar Y - {\beta _1}{{\bar X}_1}} \\  { + \_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_} \\  {E\left( {{{\hat \beta }_0}} \right) - {\beta _0} = 0}  \end{array}

\displaystyle E\left( {{{\hat \beta }_0}} \right) - {\beta _0} = 0                                (2.3)

\displaystyle {\hat \beta _0} tahmin edicisinin beklenen değerinin popülasyon (gerçek modelin) parametresi olan \displaystyle {\beta _0} ifadesine eşit olması, \displaystyle {\hat \beta _0} tahmin edicisinin (gerçek modelin parametresine göre) sapmasız olduğunu ifade eder.

3.  Parametre Varyansları ve Kovaryansları ile Hata Teriminin Varyansı, Minimum Varyans ve Etkinlik

Parametre varyansları ve kovaryansları \displaystyle {\hat \beta _0}, \displaystyle {\hat \beta _1} gibi tahmin edicilerin varyansını ve kovaryansını, hata teriminin varyansı ise tahmin edilen modelin hata teriminin (\displaystyle {\hat \varepsilon _i} ifadesinin) varyansını temsil eder. Aşağıda detaylı olarak görüleceği gibi parametre varyansları da hata teriminin varyansından bağımsız değildir. Ancak minimum varyans kavramı ile esas olarak hata teriminin varyansının minimum olmasına değil, parametrelerin (\displaystyle {\hat \beta _0}, \displaystyle {\hat \beta _1} gibi tahmin edicilerin) varyansının minimum olmasına işaret edilir.

Parametre varyansları ve kovaryansları ile hata teriminin varyansı konusuna, (tahmin edicilerde aranan özellikler ile doğrudan ilgili olmamasına rağmen) makalenin bütünlüğünün korunması amacıyla bu bölümde yer verilmiştir.

Değişken Parametresinin Varyansı

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {{{\hat \beta }_1} - E\left( {{{\hat \beta }_1}} \right)} \right]^2}

2.1 no.lu denklemde \displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {{{\hat \beta }_1} - {\beta _1}} \right]^2}                      (3.1)

Yukarıdaki denklemden devam etmeden önce, sapmasızlık konusunda değinilen aşağıdaki ilişkiler tekrar gözden geçirilecek olursa, \displaystyle {\hat \beta _1} - {\beta _1} = \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}  eşitliğine ulaşılır. Şöyle ki:

\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{k_i}{Y_i}}

Popülasyona ait I no.lu gerçek model yukarıdaki denklemde yerine yazılır.

\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{k_i}\left( {{\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}} \right)}

1.5 no.lu notta belirtilen toplam sembolünün dağılma özelliği tersine şekilde uygulanır.

\displaystyle {\hat \beta _1} = {\beta _0}\underbrace {\sum\limits_{i = 1}^n {{k_i}} }_0 + {\beta _1}\underbrace {\sum\limits_{i = 1}^n {{k_i}{X_{1i}}} }_1 + \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}

1.3 no.lu denklemde \displaystyle \sum\limits_{i = 1}^n {{k_i}}  = 0 ve 1.6 no.lu denklemde de \displaystyle \sum\limits_{i = 1}^n {{k_i}{X_{1i}}}  = 1 olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle {\hat \beta _1} = {\beta _1} + \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}

\displaystyle {\hat \beta _1} - {\beta _1} = \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}                                                (3.2)

Yukarıdaki sonuç, 3.1 no.lu denklemde yerine yazılır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {{{\hat \beta }_1} - {\beta _1}} \right]^2}

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right]^2}

Eşitliğin sağında yer alan ifadenin çapraz çarpımlarının tümünde hata terimlerinin beklenen değerleri olacağından, çapraz çarpımların tümü sıfıra, dolayısıyla denklem aşağıdaki ifadeye eşit olacaktır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = \sum\limits_{i = 1}^n {k_i^2\delta _\varepsilon ^2}

1.4 no.lu denklemden hareketle \displaystyle \sum\limits_{i = 1}^n {k_i^2}  = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }} olduğundan yukarıdaki denklemde yerine yazılarak \displaystyle {\hat \beta _1} tahmin edicisinin varyansı elde edilir.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\delta _\varepsilon ^2             (3.3)

İspat:

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right]^2} = \sum\limits_{i = 1}^n {k_i^2\delta _\varepsilon ^2}

Yukarıdaki ifadenin çapraz çarpımlarının tümünde hata terimlerinin beklenen değerleri olduğundan, çapraz çarpımların tümünün sıfıra eşit olacağının, dolayısıyla \displaystyle E{\left[ {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right]^2} = \sum\limits_{i = 1}^n {k_i^2\delta _\varepsilon ^2}  eşitliğinin ispatıdır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right]^2}

Toplam sembolünün açık hali yazılır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {{k_1}{\varepsilon _1} + {k_2}{\varepsilon _2} +  \ldots  + {k_n}{\varepsilon _n}} \right]^2}

Eşitliğin sağında yer alan parantezin karesi alınır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E\left[ {k_1^2\varepsilon _1^2 + k_2^2\varepsilon _2^2 +  \ldots  + k_n^2\varepsilon _n^2 + 2{k_1}{k_2}{\varepsilon _1}{\varepsilon _2} + 2{k_1}{k_3}{\varepsilon _1}{\varepsilon _3} \ldots 2{k_{n - 1}}{k_n}{\varepsilon _{n - 1}}{\varepsilon _n}} \right]

Beklenen değer operatörü parantez içine dağıtılır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E\left( {k_1^2\varepsilon _1^2} \right) + E\left( {k_2^2\varepsilon _2^2} \right) +  \ldots  + E\left( {k_n^2\varepsilon _n^2} \right) + E\left( {2{k_1}{k_2}{\varepsilon _1}{\varepsilon _2}} \right) + E\left( {2{k_1}{k_3}{\varepsilon _1}{\varepsilon _3}} \right) \ldots  + E\left( {2{k_{n - 1}}{k_n}{\varepsilon _{n - 1}}{\varepsilon _n}} \right)

Sabitler beklenen değer operatörünün dışına çıkarılır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = k_1^2E\left( {\varepsilon _1^2} \right) + k_2^2E\left( {\varepsilon _2^2} \right) +  \ldots  + k_n^2E\left( {\varepsilon _n^2} \right) + 2{k_1}{k_2}\underbrace {E\left( {{\varepsilon _1}} \right)}_0\underbrace {E\left( {{\varepsilon _2}} \right)}_0 + 2{k_1}{k_3}\underbrace {E\left( {{\varepsilon _1}} \right)}_0\underbrace {E\left( {{\varepsilon _3}} \right)}_0 \ldots  + 2{k_{n - 1}}{k_n}\underbrace {E\left( {{\varepsilon _{n - 1}}} \right)}_0\underbrace {E\left( {{\varepsilon _n}} \right)}_0

Hata terimlerinin beklenen değeri sıfır olduğundan, parantez içindeki ifadenin karesi alındıktan sonra gelen çapraz çarpımların tümü sıfır olacaktır. Geriye sadece \displaystyle {k_i} ve \displaystyle {\varepsilon _i} ifadelerinin karelerinin beklenen değerleri kalacaktır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = k_1^2\underbrace {E\left( {\varepsilon _1^2} \right)}_{\delta _\varepsilon ^2} + k_2^2\underbrace {E\left( {\varepsilon _2^2} \right)}_{\delta _\varepsilon ^2} +  \ldots  + k_n^2\underbrace {E\left( {\varepsilon _n^2} \right)}_{\delta _\varepsilon ^2}

\displaystyle E\left( {\varepsilon _i^2} \right) = E\left( {\varepsilon _1^2} \right) = E\left( {\varepsilon _2^2} \right) =  \ldots E\left( {\varepsilon _n^2} \right) = \delta _\varepsilon ^2 olduğundan (hata teriminin varyansının sabit olduğu varsayımı yapıldığına dikkat ediniz) denklemde yerine yazılır.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = k_1^2\delta _\varepsilon ^2 + k_2^2\delta _\varepsilon ^2 +  \ldots  + k_n^2\delta _\varepsilon ^2

Yukarıdaki ifade toplam sembolü ile aşağıdaki şekilde daha sadece ifade edilebilir.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = \sum\limits_{i = 1}^n {k_i^2\delta _\varepsilon ^2}

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right]^2} = \sum\limits_{i = 1}^n {k_i^2\delta _\varepsilon ^2}                        (3.4)

Sabit Parametresinin Varyansı

\displaystyle Var\left( {{{\hat \beta }_0}} \right) = E{\left[ {{{\hat \beta }_0} - E\left( {{{\hat \beta }_0}} \right)} \right]^2}

2.3 no.lu denklemde \displaystyle E\left( {{{\hat \beta }_0}} \right) = {\beta _0} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle Var\left( {{{\hat \beta }_0}} \right) = E{\left[ {{{\hat \beta }_0} - {\beta _0}} \right]^2}                      (3.5)

2.2 no.lu denklemden hareketle \displaystyle {\hat \beta _0} - {\beta _0} = \left( {{\beta _1} - {{\hat \beta }_1}} \right){\bar X_1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle Var\left( {{{\hat \beta }_0}} \right) = E{\left[ {\left( {{\beta _1} - {{\hat \beta }_1}} \right){{\bar X}_1}} \right]^2}

3.2 no.lu denklemde \displaystyle {\hat \beta _1} - {\beta _1} = \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}  olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle Var\left( {{{\hat \beta }_0}} \right) = E{\left[ {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right){{\bar X}_1}} \right]^2}

\displaystyle {\bar X_1} sabiti parantezin ve beklenen değer operatörünün dışına \displaystyle \bar X_1^2 olarak alınır.

\displaystyle Var\left( {{{\hat \beta }_0}} \right) = \bar X_1^2E{\left[ {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right)} \right]^2}

Yukarıda 3.4 no.lu denklemde gösterildiği gibi parantez içindeki ifadenin (çapraz çarpımlarında hata terimi olduğundan dolayı) çapraz çarpımlarının beklenen değeri sıfıra eşit olduğu için \displaystyle E{\left[ {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right)} \right]^2} = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\delta _\varepsilon ^2 olur ve yukarıdaki denklemde yerine yazılarak \displaystyle {\hat \beta _0} tahmin edicisinin varyansı elde edilir.

\displaystyle Var\left( {{{\hat \beta }_0}} \right) = \bar X_1^2\frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\delta _\varepsilon ^2                              (3.6)

Parametre Kovaryansı

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = E\left[ {\left( {{{\hat \beta }_0} - E\left( {{{\hat \beta }_0}} \right)} \right)\left( {{{\hat \beta }_1} - E\left( {{{\hat \beta }_1}} \right)} \right)} \right]

2.1 ve 2.3 no.lu denklemlerden hareketle \displaystyle E\left( {{{\hat \beta }_0}} \right) = {\beta _0} ve \displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = E\left[ {\left( {{{\hat \beta }_0} - {\beta _0}} \right)\left( {{{\hat \beta }_1} - {\beta _1}} \right)} \right]

2.2 no.lu denklemden hareketle \displaystyle {\hat \beta _0} - {\beta _0} = \left( {{\beta _1} - {{\hat \beta }_1}} \right){\bar X_1} olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = E\left[ {\left( {{\beta _1} - {{\hat \beta }_1}} \right){{\bar X}_1}\left( {{{\hat \beta }_1} - {\beta _1}} \right)} \right]

\displaystyle {\bar X_1} bir sabit olduğundan beklenen değer operatörü dışına alınır.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = {\bar X_1}E\left[ {\left( {{\beta _1} - {{\hat \beta }_1}} \right)\left( {{{\hat \beta }_1} - {\beta _1}} \right)} \right]

Köşeli parantez içindeki ifadeleri birbiri ile aynı olacak şekilde ifade etmek için \displaystyle \left( {{\beta _1} - {{\hat \beta }_1}} \right) =  - 1\left( {{{\hat \beta }_1} - {\beta _1}} \right) ilişkisinden yararlanılarak yukarıdaki denklemde yerine yazılır.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = {\bar X_1}E\left[ { - 1\left( {{{\hat \beta }_1} - {\beta _1}} \right)\left( {{{\hat \beta }_1} - {\beta _1}} \right)} \right]

-1 sabiti beklenen değer operatörünün dışına alınır.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = \left( { - {{\bar X}_1}} \right)E\left[ {\left( {{{\hat \beta }_1} - {\beta _1}} \right)\left( {{{\hat \beta }_1} - {\beta _1}} \right)} \right]

Beklenen değer operatörü içindeki ifade aşağıdaki şekilde yazılacak olursa, \displaystyle {\hat \beta _1} parametresinin varyansına eşit olduğundan yerine yazılır.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = \left( { - {{\bar X}_1}} \right)\underbrace {E{{\left[ {\left( {{{\hat \beta }_1} - {\beta _1}} \right)} \right]}^2}}_{Var\left( {{{\hat \beta }_1}} \right)}

3.3 no.lu denklem, yukarıdaki denklemde yerine yazılarak \displaystyle {\hat \beta _0} ve \displaystyle {\hat \beta _1} tahmin edicileri arasındaki kovaryans elde edilir.

\displaystyle Cov\left( {{{\hat \beta }_0},{{\hat \beta }_1}} \right) = \left( { - {{\bar X}_1}} \right)\frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\delta _\varepsilon ^2             (3.7)

Hata Teriminin Varyansı

Hata teriminin varyansını elde edebilmek amacıyla, popülasyona ait gerçek modelin ve örnekleme ait tahmin edilen modelin açıklanan değişkenleri olan Y ifadelerinin ortalamadan farklar formunda ifade edilmesi gerekir.

Popülasyon için ortalamadan farklar formu

\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}                  (3.8)

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = \sum\limits_{i = 1}^n {{\beta _0}}  + \sum\limits_{i = 1}^n {{\beta _1}{X_{1i}}}  + \sum\limits_{i = 1}^n {{\varepsilon _i}}

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = n.{\beta _0} + {\beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}  + \sum\limits_{i = 1}^n {{\varepsilon _i}}

\displaystyle \frac{1}{n}\sum\limits_{i = 1}^n {{Y_i}}  = n.\frac{1}{n}{\beta _0} + {\beta _1}\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}  + \frac{1}{n}\sum\limits_{i = 1}^n {{\varepsilon _i}}

\displaystyle \bar Y = {\beta _0} + {\beta _1}{\bar X_1} + \bar \varepsilon                        (3.9)

3.8 no.lu denklemden 3.9 no.lu denklem çıkarılarak popülasyon için ortalamadan farklar formu elde edilir.

\displaystyle \begin{array}{*{20}{c}}  {{Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}} \\  { - \bar Y =  - {\beta _0} - {\beta _1}{{\bar X}_1} - \bar \varepsilon } \\  { + \_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_}  \end{array}

\displaystyle {Y_i} - \bar Y = {\beta _1}{X_{1i}} - {\beta _1}{\bar X_1} + {\varepsilon _i} - \bar \varepsilon

\displaystyle \left( {{Y_i} - \bar Y} \right) = {\beta _1}\left( {{X_{1i}} - {{\bar X}_1}} \right) + \left( {{\varepsilon _i} - \bar \varepsilon } \right)

\displaystyle {y_i} = {\beta _1}{x_{1i}} + \left( {{\varepsilon _i} - \bar \varepsilon } \right)                         (3.10)


Örneklem için ortalamadan farklar formu

\displaystyle {Y_i} = {\hat \beta _0} + {\hat \beta _1}{X_{1i}} + {\hat \varepsilon _i}                     (3.11)

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = \sum\limits_{i = 1}^n {{{\hat \beta }_0}}  + \sum\limits_{i = 1}^n {{{\hat \beta }_1}{X_{1i}}}  + \sum\limits_{i = 1}^n {{{\hat \varepsilon }_i}}

\displaystyle \sum\limits_{i = 1}^n {{Y_i}}  = n.{\hat \beta _0} + {\hat \beta _1}\sum\limits_{i = 1}^n {{X_{1i}}}  + \sum\limits_{i = 1}^n {{{\hat \varepsilon }_i}}

\displaystyle \frac{1}{n}\sum\limits_{i = 1}^n {{Y_i}}  = n.\frac{1}{n}{\hat \beta _0} + {\hat \beta _1}\frac{1}{n}\sum\limits_{i = 1}^n {{X_{1i}}}  + \frac{1}{n}\underbrace {\sum\limits_{i = 1}^n {{{\hat \varepsilon }_i}} }_0

\displaystyle \bar Y = {\hat \beta _0} + {\hat \beta _1}{\bar X_1}                                          (3.12)

3.11 no.lu denklemden 3.12 no.lu denklem çıkarılarak örneklem için ortalamadan farklar formu elde edilir.

\displaystyle \begin{array}{*{20}{c}}  {{Y_i} = {{\hat \beta }_0} + {{\hat \beta }_1}{X_{1i}} + {{\hat \varepsilon }_i}} \\  { - \bar Y =  - {{\hat \beta }_0} - {{\hat \beta }_1}{{\bar X}_1}} \\  { + \_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_}  \end{array}

\displaystyle {Y_i} - \bar Y = {\hat \beta _1}{X_{1i}} - {\hat \beta _1}{\bar X_1} + {\hat \varepsilon _i}

\displaystyle \left( {{Y_i} - \bar Y} \right) = {\hat \beta _1}\left( {{X_{1i}} - {{\bar X}_1}} \right) + {\hat \varepsilon _i}

\displaystyle {y_i} = {\hat \beta _1}{x_{1i}} + {\hat \varepsilon _i}

\displaystyle {\hat \varepsilon _i} = {y_i} - {\hat \beta _1}{x_{1i}}                                          (3.13)

\displaystyle {y_i} yerine 3.10 no.lu popülasyona ait modelin ortalamadan farklar formu yazılır.

\displaystyle {\hat \varepsilon _i} = \underbrace {\overbrace {{\beta _1}{x_{1i}}}^{} + \left( {{\varepsilon _i} - \bar \varepsilon } \right)}_{{y_i}} - \overbrace {{{\hat \beta }_1}{x_{1i}}}^{}

\displaystyle {\hat \varepsilon _i} = \left( {{\beta _1} - {{\hat \beta }_1}} \right){x_{1i}} + \left( {{\varepsilon _i} - \bar \varepsilon } \right)

Denklemin karesi alınır.

\displaystyle {\left( {{{\hat \varepsilon }_i}} \right)^2} = {\left( {\left( {{\beta _1} - {{\hat \beta }_1}} \right){x_{1i}} + \left( {{\varepsilon _i} - \bar \varepsilon } \right)} \right)^2}

Toplam sembolü ilave edilir.

\displaystyle \sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}}  = \sum\limits_{i = 1}^n {{{\left( {\left( {{\beta _1} - {{\hat \beta }_1}} \right){x_{1i}} + \left( {{\varepsilon _i} - \bar \varepsilon } \right)} \right)}^2}}

Parantezin karesi alınır ve toplam sembolü parantez içine dağıtılır.

\displaystyle \sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}}  = {\left( {{\beta _1} - {{\hat \beta }_1}} \right)^2}\sum\limits_{i = 1}^n {x_{1i}^2}  + \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}}  + 2\left( {{\beta _1} - {{\hat \beta }_1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)}

\displaystyle \sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}}  = {\underbrace {\left( {{\beta _1} - {{\hat \beta }_1}} \right)}_{{{\left( {{{\hat \beta }_1} - {\beta _1}} \right)}^2}}^2}\sum\limits_{i = 1}^n {x_{1i}^2}  + \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}}  + \underbrace {2\left( {{\beta _1} - {{\hat \beta }_1}} \right)}_{ - 2\left( {{{\hat \beta }_1} - {\beta _1}} \right)}\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)}

Denklemde yer alan \displaystyle {\beta _1} - {\hat \beta _1} ifadeleri \displaystyle {\hat \beta _1} - {\beta _1} olarak düzenlenir.

\displaystyle \sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}}  = {\left( {{{\hat \beta }_1} - {\beta _1}} \right)^2}\sum\limits_{i = 1}^n {x_{1i}^2}  + \sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}}  - 2\left( {{{\hat \beta }_1} - {\beta _1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)}

Denkleme beklenen değer operatörü ilave edilir.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \underbrace {E\left[ {{{\left( {{{\hat \beta }_1} - {\beta _1}} \right)}^2}} \right]}_{Var\left( {{{\hat \beta }_1}} \right)}E\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right) + E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) - E\left( {2\left( {{{\hat \beta }_1} - {\beta _1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)

\displaystyle {\hat \beta _1} tahmin edicisinin varyansını temsil eden 3.1 no.lu denklem, yukarıdaki denklemde yerine yazılır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = Var\left( {{{\hat \beta }_1}} \right)\sum\limits_{i = 1}^n {x_{1i}^2}  +  + E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) - E\left( {2\left( {{{\hat \beta }_1} - {\beta _1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)

3.3 no.lu denklemden hareketle, \displaystyle Var\left( {{{\hat \beta }_1}} \right) = \frac{{\delta _\varepsilon ^2}}{{\sum\limits_{i = 1}^n {x_{1i}^2} }} olduğundan yerine yazılır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \frac{{\delta _\varepsilon ^2}}{{\cancel{{\sum\limits_{i = 1}^n {x_{1i}^2} }}}}\cancel{{\sum\limits_{i = 1}^n {x_{1i}^2} }} + E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) - E\left( {2\left( {{{\hat \beta }_1} - {\beta _1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \delta _\varepsilon ^2 + \underbrace {E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right)}_{\left( {n - 1} \right).\delta _\varepsilon ^2} - \underbrace {E\left( {2\left( {{{\hat \beta }_1} - {\beta _1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)}_{2.\delta _\varepsilon ^2}         (3.14)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \delta _\varepsilon ^2 + \left( {n - 1} \right).\delta _\varepsilon ^2 - 2.\delta _\varepsilon ^2                             (3.15)

Yukarıdaki denklemin son iki bölümüne ilişkin ispatlar aşağıda yer almaktadır.

İspat:

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = \left( {n - 1} \right).\delta _\varepsilon ^2

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\sum\limits_{i = 1}^n {\left( {\varepsilon _i^2 - 2{\varepsilon _i}\bar \varepsilon  + {{\bar \varepsilon }^2}} \right)} } \right)

Toplam sembolü parantez içine dağıtılır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2}  - 2\bar \varepsilon \underbrace {\sum\limits_{i = 1}^n {{\varepsilon _i}} }_{n\bar \varepsilon } + \underbrace {\sum\limits_{i = 1}^n {{{\bar \varepsilon }^2}} }_{n{{\bar \varepsilon }^2}}} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - 2\bar \varepsilon n.\bar \varepsilon  + n.{{\bar \varepsilon }^2}} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - 2n{{\bar \varepsilon }^2} + n.{{\bar \varepsilon }^2}} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - n.{{\bar \varepsilon }^2}} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - n.{{\left( {\frac{1}{n}\sum\limits_{i = 1}^n {{\varepsilon _i}} } \right)}^2}} \right)

1/n ifadesi parantez dışına alınır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - \cancel{n}.\frac{1}{{{n^{\cancel{2}}}}}{{\left( {\sum\limits_{i = 1}^n {{\varepsilon _i}} } \right)}^2}} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - \frac{1}{n}{{\left( {\sum\limits_{i = 1}^n {{\varepsilon _i}} } \right)}^2}} \right)

Mini İspat:

\displaystyle E{\left( {\sum\limits_{i = 1}^n {{\varepsilon _i}} } \right)^2} = E\left( {\varepsilon _1^2} \right) + E\left( {\varepsilon _2^2} \right) +  \ldots  + E\left( {\varepsilon _n^2} \right) + \underbrace {E\left( {{\varepsilon _1}} \right)}_0\underbrace {E\left( {{\varepsilon _2}} \right)}_0 + \underbrace {E\left( {{\varepsilon _1}} \right)}_0\underbrace {E\left( {{\varepsilon _3}} \right)}_0 +  \ldots  + \underbrace {E\left( {{\varepsilon _{n - 1}}} \right)}_0\underbrace {E\left( {{\varepsilon _n}} \right)}_0

\displaystyle E{\left( {\sum\limits_{i = 1}^n {{\varepsilon _i}} } \right)^2} = E\left( {\varepsilon _1^2 + \varepsilon _2^2 +  \ldots  + \varepsilon _n^2} \right) = E\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right)

Yukarıdaki denklemde \displaystyle {\left( {\sum\limits_{i = 1}^n {{\varepsilon _i}} } \right)^2} yerine \displaystyle \left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) yazılır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right) - \frac{1}{n}\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right)} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {1 - \frac{1}{n}} \right)\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right)} \right)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = E\left( {\left( {\frac{{n - 1}}{n}} \right)\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right)

\displaystyle \frac{{n - 1}}{n} ifadesi bir sabit olduğundan beklenen değer operatörünün dışında ifade edilebilir.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = \left( {\frac{{n - 1}}{n}} \right)\underbrace {E\left( {\sum\limits_{i = 1}^n {\varepsilon _i^2} } \right)}_{n.E\left( {\varepsilon _i^2} \right)}

Şöyle ki,

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = \left( {\frac{{n - 1}}{n}} \right)\underbrace {E\left( {\varepsilon _1^2 + \varepsilon _2^2 +  \ldots  + \varepsilon _n^2} \right)}_{}

Beklenen değer operatörü parantez içine dağıtılır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = \left( {\frac{{n - 1}}{n}} \right)\underbrace {\left( {E\left( {\varepsilon _1^2} \right) + E\left( {\varepsilon _2^2} \right) +  \ldots  + E\left( {\varepsilon _n^2} \right)} \right)}_{n.E\left( {\varepsilon _i^2} \right)}

Hata teriminin varyansı sabit, dolayısıyla \displaystyle E\left( {\varepsilon _1^2} \right) = E\left( {\varepsilon _2^2} \right) =  \ldots  = E\left( {\varepsilon _n^2} \right) = E\left( {\varepsilon _i^2} \right) = \delta _\varepsilon ^2 olduğundan yukarıda belirtilen kısım \displaystyle n.E\left( {\varepsilon _i^2} \right) olur.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = \left( {\frac{{n - 1}}{{\cancel{n}}}} \right)\cancel{n}.\underbrace {E\left( {\varepsilon _i^2} \right)}_{\delta _\varepsilon ^2}

\displaystyle E\left( {\varepsilon _i^2} \right) ifadesi, hata teriminin sabit olan varyansına eşit olduğundan yerine yazılır.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right) = \left( {n - 1} \right).\delta _\varepsilon ^2           (3.16)

İspat:

\displaystyle 2.E\left( {\sum\limits_{i = 1}^n {\left( {{{\hat \beta }_1} - {\beta _1}} \right){x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right) = 2.\delta _\varepsilon ^2

3.2 no.lu denklemden hareketle \displaystyle {\hat \beta _1} - {\beta _1} = \sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}}  olduğundan yukarıdaki denklemde yerine yazılır.

\displaystyle \underbrace {2.E\left( {\sum\limits_{i = 1}^n {\left( {{{\hat \beta }_1} - {\beta _1}} \right){x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)}_A = 2.E\left( {\sum\limits_{i = 1}^n {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right){x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)

Eşitliğin solundaki ifade işlem kolaylığı sağlaması amacıyla A ile temsil edilmiştir.

\displaystyle A = 2.E\left( {\sum\limits_{i = 1}^n {\underbrace {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right){x_{1i}}{\varepsilon _i} - \left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right){x_{1i}}\bar \varepsilon }_{}} } \right)

Parantezlere dikkat edilirse, yukarıda işaretli alanda yer alan toplam sembolleri dahil tüm elemanlar en soldaki toplam sembolünün birer elemanıdır. Beklenen değer operatörü parantez içine dağıtılır.

\displaystyle A = 2\left( {\sum\limits_{i = 1}^n {E\left( {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right){x_{1i}}{\varepsilon _i}} \right) - \underbrace {\left( {\sum\limits_{i = 1}^n {E\left( {{k_i}} \right)\underbrace {E\left( {{\varepsilon _i}} \right)}_0} } \right)E\left( {{x_{1i}}} \right)E\left( {\bar \varepsilon } \right)}_0} } \right)

Parantezin içinde, sağ tarafta yer alan ifade, hata teriminin beklenen değerinden dolayı sıfıra eşit olacaktır.

\displaystyle A = 2.E\left( {\sum\limits_{i = 1}^n {\left( {\underbrace {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right)}_{}{x_{1i}}{\varepsilon _i}} \right)} } \right)

Yukarıda işaretli toplam sembolü, soldaki toplam sembolünün önüne (soluna) alınır.

\displaystyle A = 2.E\left( {\underbrace {\left( {\sum\limits_{i = 1}^n {{k_i}{\varepsilon _i}} } \right)}_{}\left( {\sum\limits_{i = 1}^n {\left( {{x_{1i}}{\varepsilon _i}} \right)} } \right)} \right)

Yukarıdaki ifadede, birinci toplam sembolü ile ikinci toplam sembolü elemanlarının çapraz çarpımların tümü, hata teriminin beklenen değerlerinin sıfıra eşit olmasından dolayı sıfır olacaktır.

\displaystyle A = 2.E\left( {\underbrace {\left( {{k_1}{\varepsilon _1} + {k_2}{\varepsilon _2} +  \ldots {k_n}{\varepsilon _n}} \right)}_{}\left( {{x_{11}}{\varepsilon _1} + {x_{12}}{\varepsilon _2} +  \ldots {x_{1n}}{\varepsilon _n}} \right)} \right)

\displaystyle A = 2.E\left( {{k_1}{x_{11}}\varepsilon _1^2 + {k_2}{x_{12}}\varepsilon _2^2 +  \ldots  + {k_n}{x_{1n}}\varepsilon _n^2 + {k_1}{\varepsilon _1}{x_{12}}{\varepsilon _2} + {k_1}{\varepsilon _1}{x_{13}}{\varepsilon _3} +  \ldots  + {k_{n - 1}}{\varepsilon _{n - 1}}{x_{1n}}{\varepsilon _n}} \right)

Beklenen değer operatörü parantez içine dağıtılır.

\displaystyle \begin{gathered}  A = 2.E\left( {{k_1}{x_{11}}} \right)E\left( {\varepsilon _1^2} \right) + E\left( {{k_2}{x_{12}}} \right)E\left( {\varepsilon _2^2} \right) +  \ldots  + E\left( {{k_n}{x_{1n}}} \right)E\left( {\varepsilon _n^2} \right) +  \hfill \\  E\left( {{k_1}{x_{12}}} \right)\underbrace {E\left( {{\varepsilon _1}} \right)}_0\underbrace {E\left( {{\varepsilon _2}} \right)}_0 + E\left( {{k_1}{x_{13}}} \right)\underbrace {E\left( {{\varepsilon _1}} \right)}_0\underbrace {E\left( {{\varepsilon _3}} \right)}_0 +  \ldots  + E\left( {{k_{n - 1}}{x_{1n}}} \right)\underbrace {E\left( {{\varepsilon _{n - 1}}} \right)}_0\underbrace {E\left( {{\varepsilon _n}} \right)}_0 \hfill \\  \end{gathered}

\displaystyle A = 2.E\left( {{k_1}{x_{11}}} \right)E\left( {\varepsilon _1^2} \right) + E\left( {{k_2}{x_{12}}} \right)E\left( {\varepsilon _2^2} \right) +  \ldots  + E\left( {{k_n}{x_{1n}}} \right)E\left( {\varepsilon _n^2} \right)

Yukarıdaki ifade toplam sembolü ile daha sade ifade edilebilir.

\displaystyle A = 2.E\left( {\left( {\sum\limits_{i = 1}^n {{k_i}{x_{1i}}\varepsilon _i^2} } \right)} \right)

\displaystyle A = 2.\sum\limits_{i = 1}^n {{k_i}{x_{1i}}\underbrace {E\left( {\varepsilon _i^2} \right)}_{\delta _\varepsilon ^2}}

\displaystyle A = 2.\sum\limits_{i = 1}^n {{k_i}{x_{1i}}\delta _\varepsilon ^2}

Hata teriminin varyansını temsil eden \displaystyle \delta _\varepsilon ^2 ifadesi bir sabit olduğundan toplam sembolünün dışına alınabilir.

\displaystyle A = 2.\delta _\varepsilon ^2\underbrace {\sum\limits_{i = 1}^n {{k_i}{x_{1i}}} }_1

1.5 no.lu denklemin eşiti olan 1, yukarıdaki denklemde yerine yazılır.

\displaystyle A = 2.\delta _\varepsilon ^2

A ifadesinin gerçek değeri yerine konularak, A ile temsil edilen ifadenin hata teriminin varyansının 2 katına eşit olduğu ispatlanmış olur.

\displaystyle 2.E\left( {\sum\limits_{i = 1}^n {\left( {{{\hat \beta }_1} - {\beta _1}} \right){x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right) = 2.\delta _\varepsilon ^2                    (3.17)

3.16 ve 3.17 no.lu sonuçlar 3.14 no.lu denklemde yerine yazılarak 3.15 no.lu denklem elde edilir.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \delta _\varepsilon ^2 + \underbrace {E\left( {\sum\limits_{i = 1}^n {{{\left( {{\varepsilon _i} - \bar \varepsilon } \right)}^2}} } \right)}_{\left( {n - 1} \right).\delta _\varepsilon ^2} - \underbrace {E\left( {2\left( {{{\hat \beta }_1} - {\beta _1}} \right)\sum\limits_{i = 1}^n {{x_{1i}}\left( {{\varepsilon _i} - \bar \varepsilon } \right)} } \right)}_{2.\delta _\varepsilon ^2}           (3.14)

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \delta _\varepsilon ^2 + \left( {n - 1} \right).\delta _\varepsilon ^2 - 2.\delta _\varepsilon ^2                                             (3.15)

3.15 no.lu denklemden devam edilir.

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \left( {n - 1} \right).\delta _\varepsilon ^2 - \delta _\varepsilon ^2

\displaystyle E\left( {\sum\limits_{i = 1}^n {{{\left( {{{\hat \varepsilon }_i}} \right)}^2}} } \right) = \left( {n - 2} \right).\delta _\varepsilon ^2                   (3.18)

3.18 no.lu denklemden hareketle EKK yönteminde örnekleme dayalı olarak tahmin edilen hata teriminin varyansı aşağıdaki gibi tanımlanabilir.

\displaystyle \hat \delta _\varepsilon ^2 = \frac{1}{{\left( {n - 2} \right)}}\left( {\sum\limits_{i = 1}^n {\hat \varepsilon _i^2} } \right)

Yukarıdaki ifadeye beklenen değer operatörü ilave edilir.

\displaystyle E\left( {\hat \delta _\varepsilon ^2} \right) = \frac{1}{{\left( {n - 2} \right)}}E\left( {\sum\limits_{i = 1}^n {\hat \varepsilon _i^2} } \right)

3.18 no.lu denklem yukarıdaki denklemde yerine yazılır.

\displaystyle E\left( {\hat \delta _\varepsilon ^2} \right) = \frac{1}{{\cancel{{\left( {n - 2} \right)}}}}\cancel{{\left( {n - 2} \right)}}.\delta _\varepsilon ^2

\displaystyle E\left( {\hat \delta _\varepsilon ^2} \right) = \delta _\varepsilon ^2                                         (3.19)

Böylece örnekleme dayalı olarak elde edilen hata teriminin varyansının beklenen değerinin popülasyona ilişkin gerçek modelin hata teriminin varyansına eşit olduğu ispat edilmiş olur.

Minimum Varyans ve Etkinlik

Etkinlik, sapmasız tahmin ediciler arasında minimum varyansa sahip olan tahmin edici olarak tanımlanabilir. EKK tahmin edicisinin alternatif tahmin ediciler arasında minimum varyansa sahip, dolayısıyla etkin bir tahmin edici olduğunu ispatlamak amacıyla “Doğrusallık” konusunda yer alan aşağıdaki ilişkilerden yararlanılacaktır.

\displaystyle {\hat \beta _1} = \sum\limits_{i = 1}^n {{k_i}{Y_i}}             ve           \displaystyle {k_i} = \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}

\displaystyle {\hat \beta _1} tahmin edicisinin minimum varyansa sahip etkin bir tahmin edici olduğunu göstermek için \displaystyle {\hat \beta _1} tahmin edicisinin alternatifi olarak \displaystyle {}^*{\hat \beta _1} tahmin edicisi aşağıdaki şekilde tanımlanır.

\displaystyle {}^*{\hat \beta _1} = \sum\limits_{i = 1}^n {{w_i}{Y_i}}                                   (3.20)

\displaystyle {w_i} ifadesi, \displaystyle {\hat \beta _1} tahmin edicisinin doğrusallığını temsil eden \displaystyle {k_i} ifadesi ile aynı özelliklere sahip olup \displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisinin doğrusal olduğunu ifade etmektedir. Bu sebeple \displaystyle {k_i} ifadesinde olduğu gibi \displaystyle {w_i} ifadesi de aşağıdaki özelliklere sahiptir.

\displaystyle \sum\limits_{i = 1}^n {{w_i}}  = 0            ve            \displaystyle \sum\limits_{i = 1}^n {{w_i}{x_{1i}}}  = \sum\limits_{i = 1}^n {{w_i}{X_{1i}}}  = 1

3.20 no.lu denklemde \displaystyle {Y_i} yerine \displaystyle {Y_i} ifadesinin popülasyona ait gerçek modele olan eşiti (I no.lu denklem) yazılır.

\displaystyle {Y_i} = {\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}

\displaystyle {}^*{\hat \beta _1} = \sum\limits_{i = 1}^n {{w_i}\left( {{\beta _0} + {\beta _1}{X_{1i}} + {\varepsilon _i}} \right)}

\displaystyle {}^*{\hat \beta _1} = {\beta _0}\underbrace {\sum\limits_{i = 1}^n {{w_i}} }_0 + {\beta _1}\underbrace {\sum\limits_{i = 1}^n {{w_i}{X_{1i}}} }_1 + \sum\limits_{i = 1}^n {{w_i}{\varepsilon _i}}

\displaystyle {}^*{\hat \beta _1} = {\beta _1} + \sum\limits_{i = 1}^n {{w_i}{\varepsilon _i}}                      (3.21)

Beklenen değer operatörü ilave edilir.

\displaystyle E\left( {{}^*{{\hat \beta }_1}} \right) = \underbrace {E\left( {{\beta _1}} \right)}_{{\beta _1}} + \sum\limits_{i = 1}^n {E\left( {{w_i}} \right)\underbrace {E\left( {{\varepsilon _i}} \right)}_0}

\displaystyle E\left( {{}^*{{\hat \beta }_1}} \right) = {\beta _1}                                             (3.22)

\displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisinin sapmasız olduğu ispatlandıktan sonra varyansına geçilir.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = E{\left( {{}^*{{\hat \beta }_1} - E\left( {{}^*{{\hat \beta }_1}} \right)} \right)^2}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = E{\left( {{}^*{{\hat \beta }_1} - \underbrace {E\left( {{}^*{{\hat \beta }_1}} \right)}_{{\beta _1}}} \right)^2}

3.22 no.lu denklem yukarıda yerine yazılır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = E{\left( {{}^*{{\hat \beta }_1} - {\beta _1}} \right)^2}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = E{\left( {\underbrace {{}^*{{\hat \beta }_1} - {\beta _1}}_{\sum\limits_{i = 1}^n {{w_i}{\varepsilon _i}} }} \right)^2}

3.21 no.lu denklemden hareketle yukarıdaki denklem aşağıdaki şekilde ifade edilebilir.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = E{\left( {\sum\limits_{i = 1}^n {{w_i}{\varepsilon _i}} } \right)^2}

Yukarıdaki ifadenin çapraz çarpımlarında \displaystyle {\varepsilon _i} ifadesi yer alacağı, \displaystyle {\varepsilon _i} ifadesinin beklenen değerleri de sıfıra eşit olduğu için yukarıdaki ifade aşağıdaki şekilde ifade edilebilir.
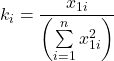
\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \sum\limits_{i = 1}^n {E\left( {w_i^2} \right)E\left( {\varepsilon _i^2} \right)}

\displaystyle {w_i} ifadesi deterministik olduğu için beklenen değeri kendisine, \displaystyle {\varepsilon _i} ifadesinin karesinin beklenen değeri ise hata teriminin varyansına eşit olacaktır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \sum\limits_{i = 1}^n {w_i^2\delta _\varepsilon ^2}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {w_i^2}              (3.23)

Yukarıda 3.3 no.lu denklemde \displaystyle {\hat \beta _1} tahmin edicisinin varyansı aşağıdaki şekilde elde edilmişti.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = \frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}\delta _\varepsilon ^2         (3.3)

Yukarıda yer alan 3.23 no.lu denklem, 3.3 no.lu denklemi içerecek şekilde ifade edilebilirse, \displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisinin varyansı ile \displaystyle {\hat \beta _1} tahmin edicisinin varyansı karşılaştırılabilir. Bu amaçla \displaystyle {w_i} ifadesinden  (\displaystyle {w_i} ifadesinde bir değişiklik yapmayacak olan) \displaystyle {k_i} ifadesi çıkarılır ve tekrar \displaystyle {w_i} ifadesine \displaystyle {k_i} ifadesi eklenir.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left[ {{w_i} - {k_i} + {k_i}} \right]}^2}}

Yukarıdaki ifade aşağıdaki gibi ifade edilir ve parantez içindeki ifadeler açılmadan köşeli parantezin karesi alınır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left[ {\left( {{w_i} - {k_i}} \right) + \left( {{k_i}} \right)} \right]}^2}}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {\left[ {\left( {{w_i} - {k_i}} \right) + \left( {{k_i}} \right)} \right]\left[ {\left( {{w_i} - {k_i}} \right) + \left( {{k_i}} \right)} \right]}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {\left[ {{{\left( {{w_i} - {k_i}} \right)}^2} + {{\left( {{k_i}} \right)}^2} + 2\left( {{w_i} - {k_i}} \right)\left( {{k_i}} \right)} \right]}

Toplam sembolü köşeli parantez içine dağıtılır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} - {k_i}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{k_i}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {\underbrace {2\left( {{w_i} - {k_i}} \right)\left( {{k_i}} \right)}_{}}

İşaretli bölümde 2 sabiti toplam sembolünün dışına alınır ve parantez içindeki ifadeler açılır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + {k_i}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{k_i}} \right)}^2}}  + 2\delta _\varepsilon ^2\sum\limits_{i = 1}^n {\underbrace {\left( {{w_i}{k_i} - k_i^2} \right)}_{}}

İşaretli bölümde toplam sembolü parantez içine dağıtılır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + {k_i}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{k_i}} \right)}^2}}  + 2\delta _\varepsilon ^2\sum\limits_{i = 1}^n {{w_i}{k_i}}  - 2\delta _\varepsilon ^2\sum\limits_{i = 1}^n {k_i^2}

\displaystyle {k_i} = \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}} olduğundan yukarıdaki denklemde yerine yazılır.
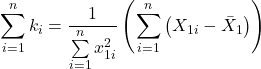
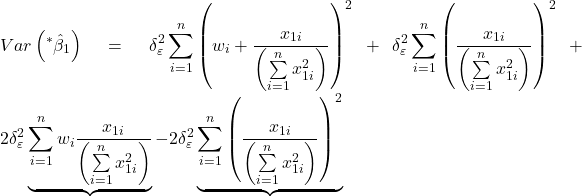
\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + 2\delta _\varepsilon ^2\underbrace {\sum\limits_{i = 1}^n {{w_i}\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} }_{} - 2\delta _\varepsilon ^2\underbrace {\sum\limits_{i = 1}^n {{{\left( {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}} }_{}

İşaretli bölümlerde parantez içindeki işlemler yapılır ve toplam sembolü içe aktarılır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + 2\delta _\varepsilon ^2\frac{{\overbrace {\sum\limits_{i = 1}^n {{w_i}{x_{1i}}} }^1}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}} - 2\delta _\varepsilon ^2\frac{{\cancel{{\sum\limits_{i = 1}^n {x_{1i}^2} }}}}{{{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}^{\cancel{2}}}}}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \cancel{{2\delta _\varepsilon ^2\frac{1}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}}} - \cancel{{2\delta _\varepsilon ^2\frac{1}{{{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}^2}}}}}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \delta _\varepsilon ^2\underbrace {\sum\limits_{i = 1}^n {{{\left( {\frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}} }_{}

İşaretli bölümde toplam sembolü içe aktarılır.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \delta _\varepsilon ^2\frac{{\cancel{{\sum\limits_{i = 1}^n {x_{1i}^2} }}}}{{{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}^{\cancel{2}}}}}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \delta _\varepsilon ^2\frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}                (3.24)

\displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisinin varyansı 3.24 no.lu denklemde elde edilmiş oldu. Denklemin en sağında yer alan ifadenin ise \displaystyle {\hat \beta _1} tahmin edicisinin varyansı olduğu göz önüne alınırsa, \displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisinin varyansının \displaystyle {\hat \beta _1} tahmin edicisinin varyansından büyük olduğu kolaylıkla fark edilebilir.

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + \underbrace {\delta _\varepsilon ^2\frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}}_{Var\left( {{{\hat \beta }_1}} \right)}

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\sum\limits_{i = 1}^n {{{\left( {{w_i} + \frac{{{x_{1i}}}}{{\left( {\sum\limits_{i = 1}^n {x_{1i}^2} } \right)}}} \right)}^2}}  + Var\left( {{{\hat \beta }_1}} \right)

\displaystyle Var\left( {{}^*{{\hat \beta }_1}} \right) > Var\left( {{{\hat \beta }_1}} \right)

O halde, doğrusal \displaystyle {\hat \beta _1} tahmin edicisi gibi doğrusal \displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisi de sapmasız olmasına rağmen,  \displaystyle {\hat \beta _1} tahmin edicisinin varyansı, \displaystyle {}^*{\hat \beta _1} alternatif tahmin edicisinin varyansından küçük olduğu için \displaystyle {\hat \beta _1} tahmin edicisi “etkin” bir tahmin edicidir.

Yukarıdaki işlem adımları dikkatli bir şekilde incelenecek olursa, bir tahmin edicinin minimum varyansa sahip etkin bir tahmin edici olabilmesi için aşağıdaki üç koşulu sağlaması gerekir.

  • Açıklayıcı değişkenlerin (ortalamadan farklar formunun) deterministik (gözlem değerleri) olması (\displaystyle {x_{1i}}),
  • \displaystyle {k_i} ifadelerinin toplamının sıfır olması (\displaystyle \sum\limits_{i = 1}^n {{k_i}} = 0),
  • Hata teriminin varyansının sabit olması (\displaystyle \delta _\varepsilon ^2).

4.  Asimptotik Sapmasızlık

Asimptotik sapmasızlık büyük örneklem özelliğidir. Gözlem sayısı n sonsuza giderken \displaystyle {\hat \beta _1} tahmin edicisinin beklenen değerinin popülasyon parametresi olan \displaystyle {\beta _1} ifadesine eşit olmasını temsil eder.

\displaystyle \mathop {\lim }\limits_{n \to \infty } E\left( {{{\hat \beta }_1}} \right) = {\beta _1}

Kolaylıkla fark edilebileceği gibi sapmasız tahmin ediciler aynı zamanda asimptotik olarak da sapmasızdırlar. Ancak sapmasız olmayan bir tahmin edici asimptotik olarak sapmasız olabilir. Diğer bir ifadeyle asimptotik olarak sapmasız tahmin ediciler daima sapmasız olmayabilir.

5.  Tutarlılık

Büyük örneklem özelliklerden olan tutarlılık, gözlem sayısı n sonsuza giderken (asimptotik bakımdan) \displaystyle {\hat \beta _1} tahmin edicisinin popülasyon parametresi olan \displaystyle {\beta _1} ifadesine eşit olmasını temsil eder.

\displaystyle \mathop {\lim }\limits_{n \to \infty } {\hat \beta _1} = {\beta _1}

Tutarlılık, yukarıdaki tanım gereği gözlem sayısı n sonsuza giderken \displaystyle {\hat \beta _1} tahmin edicisinin varyansının sıfıra yaklaşmasını/eşit olmasını ifade eder.

\displaystyle Var\left( {{{\hat \beta }_1}} \right) = \delta _\varepsilon ^2\frac{1}{{\sum\limits_{i = 1}^n {x_{1i}^2} }}

\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) = \frac{{\frac{{\delta _\varepsilon ^2}}{n}}}{{\frac{{\sum\limits_{i = 1}^n {x_{1i}^2} }}{n}}} = 0

\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) = 0

O halde \displaystyle {\hat \beta _1} tahmin edicisinin varyansı tekrar yazılır.

\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {{{\hat \beta }_1} - E\left( {{{\hat \beta }_1}} \right)} \right]^2}

2.1 no.lu denklemde \displaystyle E\left( {{{\hat \beta }_1}} \right) = {\beta _1} olduğundan yukarıdaki denklemde yerine yazılır.
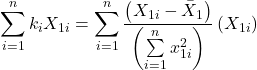
\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) = E{\left[ {{{\hat \beta }_1} - {\beta _1}} \right]^2}

\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) = E{\underbrace {\left[ {{{\hat \beta }_1} - {\beta _1}} \right]}_0^2}

İşaretli bölümde kare ifadesi olduğu için onu sıfır yapabilmenin tek yolu köşeli parantez içindeki ifadenin sıfır olmasıdır. Bu durumda da \displaystyle {\hat \beta _1} tahmin edicisi, popülasyon parametresi olan \displaystyle {\beta _1} ifadesine eşit olmak zorundadır.

\displaystyle \mathop {\lim }\limits_{n \to \infty } {\hat \beta _1} = {\beta _1}

Bir tahmin edicinin tutarlı olabilmesi için aşağıdaki iki koşulu sağlaması gerekir.

  • Gözlem sayısı n sonsuza giderken tahmin edicinin varyansının sıfır olması (\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) = 0),
  • Tahmin edicinin (sapmasız olmasa da en azından) asimptotik olarak sapmasız olması (\displaystyle \mathop {\lim }\limits_{n \to \infty } E\left( {{{\hat \beta }_1}} \right) = {\beta _1}),

6.  Asimptotik Etkinlik

Büyük örneklem özelliklerinden olan asimptotik etkinlik, \displaystyle {\hat \beta _1} tahmin edicisinin sonlu bir beklenen değeri ve varyansı olmak üzere, gözlem sayısı n sonsuza giderken tutarlı tahmin ediciler arasından minimum varyansa sahip tahmin edici olarak tanımlanabilir.

\displaystyle \mathop {\lim }\limits_{n \to \infty } {\hat \beta _1} = {\beta _1} ve \displaystyle \mathop {\lim }\limits_{n \to \infty } {}^*{\hat \beta _1} = {\beta _1} olmak üzere,

\displaystyle \mathop {\lim }\limits_{n \to \infty } Var\left( {{{\hat \beta }_1}} \right) < \mathop {\lim }\limits_{n \to \infty } Var\left( {{}^*{{\hat \beta }_1}} \right) ise \displaystyle {\hat \beta _1} tahmin edicisi asimptotik olarak etkin bir tahmin edicidir.


İshak Kutlu, Ekonometri Notları


Yorum Yap

İshak Kutlu

Veri & Otomasyon Uzmanı

Kurumsal iş akışlarını düzenleyen veri odaklı otomasyon sistemleri ve makine öğrenmesi tabanlı çözümler geliştirir. Gerçek operasyonel süreçler için ölçeklenebilir ve izlenebilir yapılar tasarlar.

YouTube   YouTube   YouTube   YouTube