LMFO AI (Layered Multiple Frequency Optimization), yapay sezgi tabanlı bir karar destek sistemidir. Verinin sınırlı ve sinyal/gürültü oranının düşük olduğu gerçek dünya ortamlarında bağlama duyarlı örüntü tanıma kapasitesiyle kritik bilgiyi gürültüden ayırarak anlamlı örüntüler çıkarır. Modüler ve ölçeklenebilir yapısıyla farklı alanlara uyarlanabilir.

(Click here to read this article in English.)
1. Genel Bakış
Algoritma yalnızca güçlü sinyalleri değil, tek başına anlamsız görünen zayıf sinyalleri de bağlam içinde anlamlı örüntülere dönüştürür.
Zayıf sinyal → Bağlamsal analiz → Güçlü örüntü
LMFO AI, makine öğrenmesinin (ML) veri odaklı analizini ve meta-sezgisellerin geniş arama stratejilerini bir araya getirir, fakat onların sınırlılıklarını aşarak özgün bir yaklaşım sunar:
- → Makine öğrenmesinden farkı: ML genellikle parametre optimizasyonuna ve güçlü sinyallere odaklanır. LMFO ise zayıf sinyalleri bağlam içinde koruyarak doğrudan örüntü çıkarımına yönelir. ML’de genelde gürültü kabul edilen zayıf sinyaller, LMFO’da anlamlı örüntülere dönüşür.
- → Meta-sezgisellerden farkı: Klasik meta-sezgisel yöntemler rastgele arama stratejilerine dayanırken, LMFO AI aramayı rastgele bırakmaz. Veri odaklı önceliklendirme ve adaptif stratejileriyle bağlamı koruyarak aramayı yönlendirir.
Bu özgün yapı, klasik ML ve meta-sezgisel yöntemlerin ötesinde, veriye dayalı ve bağlama duyarlı bir sezgisel çıkarım yaklaşımı sunar. Katmanlı mimarisi astronomik büyüklükteki arama uzaylarını yönetilebilir hale getirirken, veri odaklı adaptif stratejileri verimsiz yönleri eleyip anlamlı örüntülere odaklanmasını sağlar.
Python tabanlı olarak prototip düzeyinde geliştirilen LMFO AI, yüksek gürültü seviyeleriyle bilinen kamuya açık gerçek dünya veri setlerinde başarıyla doğrulanmıştır. Bu veri setleri, algoritmanın farklı alanlara uyarlanabilirliğini göstermek için zorlu bir benchmark ortamı olarak seçilmiştir. Kapsamlı testler, LMFO’nun sınırlı veri ve yüksek gürültü koşullarında tutarlı ve genellenebilir sonuçlar ürettiğini ortaya koymuştur.
Bu esnek yaklaşım, düşük sinyal/gürültü oranına sahip endüstriyel otomasyon, otomotiv, enerji, finans ve biyoinformatik gibi alanlarda hızlı ve güvenilir karar desteği sağlar.
- → Problem: Yüksek gürültü, sınırlı veri, astronomik arama uzayı.
- → Çözüm: Katmanlı, veriye dayalı, bağlama duyarlı örüntü çıkarımı.
- → Kanıt: Bağımsız testler + istatistiksel doğrulama → genellenebilirlik, dayanıklılık, tutarlılık.
2. Nasıl Çalışır – Kısaca
LMFO, geniş arama alanlarını veri odaklı çıkarımlarla daraltır ve katmanlı bir mantıkla yönetilebilir hale getirir:
- → Aday örüntülerin seçimi: Frekans, istikrar ve bağlamsal–ilişkisel uyum ölçütlerine göre örüntü potansiyeli yüksek adaylar belirlenir.
- → İlişki tabanlı genişletme: Adaylar, katmanlar arası hafıza transferi ile bağlamı korunarak genişletilir; böylece katmanlar boyunca ilerledikçe daha kapsamlı ve anlamlı örüntüler inşa edilir.
- → Adaptif arama stratejisi: Sabit kurallar yerine veri kaynaklı geri bildirimlere göre yön değiştirilir; düşük değerli bölgeler bırakılıp daha verimli alt arama alanlarına yeniden yönlenilir.
- → Bağımsız doğrulama: Çıkarımlar, bağımsız doğrulama ve test setleri üzerinde sınanarak istatistiksel anlamlılık ve genellenebilirlik açısından değerlendirilir.
3. Mimari Tasarım
LMFO’nun mimarisi, yüksek gürültülü ve geniş çözüm alanlarında zayıf sinyalleri anlamlı örüntülere dönüştürmeye odaklanan, katmanlı, veri odaklı ve adaptif bir yapı üzerine kuruludur. Bu mimari, astronomik büyüklükteki arama alanlarını yönetilebilir hale getirirken, katmanlar boyunca bağlamsal bütünlüğü koruyan ve çıkarımları güçlendiren bir bilgi aktarım mekanizması sağlar.
3.1. Katmanlı Yapı
Süreç, arama uzayını sistematik olarak daraltan çok katmanlı bir yapı üzerine kuruludur. Her katman, önceki aşamada çıkarılan örüntüleri, bağlamını koruyarak bir sonraki seviyeye taşır ve bunları bağlamsal olarak uygun sinyallerle genişletir. Böylece her katmanda daha derin ve anlamlı örüntüler inşa edilir. Bu yapı, yüksek gürültü koşullarında dahi potansiyel örüntülerin katmanlar boyunca adım adım ilerleyerek nihai örüntülere dönüşmesini sağlar.

Katmanlar arası hafıza transferi ve birikimli çıkarım (cumulative reasoning) mekanizması, yapay sezginin “önceki deneyimden öğrenerek bağlamı güçlendirme” yeteneğinin mimari karşılığıdır.
3.2. Veri Odaklı Önceliklendirme
Arama yönü, rastgele denemeler yerine veriye dayalı bir önceliklendirme mekanizmasıyla belirlenir. Bu mekanizma, aday çözümleri bilgi değeri ve bağlamsal anlamlarına göre sıralar; böylece sistem, arama uzayının tamamını taramak yerine öncelikli bölgelere yoğunlaşır. Bu strateji, örüntü potansiyeli yüksek yapılara odaklanarak arama sürecini baştan itibaren hedefe yönelik hale getirir.
Bu odaklı yönelim, yapay sezginin “ilgili olanı hızla ayırt etme” becerisini teknik düzeyde yansıtır.
3.3. Adaptif Arama Stratejisi
LMFO, örüntü ararken sabit stratejiler yerine duruma duyarlı, veri odaklı ve adaptif yollar izler. Arama yönü, iterasyonun gidişatına ve sinyal yoğunluğuna göre dinamik olarak şekillenir. Tekrarlayan denemeler ve sinyal zayıflığı, başlangıçta tolere edilir; ancak bu durum belli bir sınırı aştığında yön değiştirmenin gerekçesi olarak kabul edilir.
Bu strateji değişikliği, sistemin verimsiz arama alanlarını terk ederek daha verimli bölgelere odaklanmasını sağlar. Böylece yalnızca “örüntü aramakla” kalmaz, aynı zamanda “nerede aramamak gerektiğini” de sezgisel olarak belirler.
Bu adaptif yaklaşım, yapay sezginin mimari karşılığı olan “duruma göre strateji değiştirme” ve “yeniden yönlenme” yeteneklerini yansıtır.
4. LMFO’nun Temel İşleyişi
LMFO, her katmanda aşağıdaki işlem adımlarını tekrar eden döngüsel bir yapı üzerinde çalışır. Son katmanda çıkarılan nihai örüntüler, bağımsız doğrulama süreçlerinde değerlendirilir.
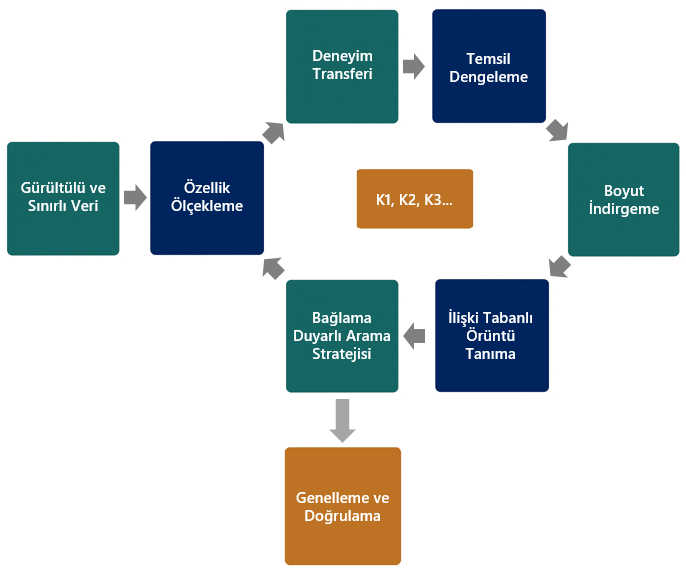
4.1. Veri Hazırlama
Amaç: Ham veriyi, algoritmanın doğrudan işleyebileceği tutarlı bir yapıya dönüştürmek.
- → Dönüşüm: Ham veriler, örüntü madenciliğine uygun ikili (0/1) temsile çevrilir.
- → Bölme: Veri seti, eğitim/doğrulama/test şeklinde üçe bölünür.
- → Aktarım: Algoritmaya yalnızca eğitim verisi gönderilir.
4.2. LMFO’da Özellik Ölçekleme
Amaç: Gürültü yoğunluğu farklı olan özellikleri normalize ederek arama uzayını dengeli hale getirmek.
- → Frekans ve istikrar ölçümü: Her özellik için ortalama ve varyansa dayalı katsayı hesaplanır.
- → Sinyal önceliklendirme: Hesaplanan katsayı ile ölçekleme yapılarak güçlü sinyaller ile zayıf ama istikrarlı olanlar öne çıkarılır; zayıf ve istikrarsız sinyallerin ağırlığı ise düşürülür.
Sonuç: Gürültü azaltılır ve kritik sinyaller daha belirgin hale gelir.
4.3. Deneyim Transferi
Amaç: Geçmiş çalıştırmalardan edinilen deneyimi, yeni çalıştırmalara taşıyarak aramayı doğru bağlamlara yönlendirmek.
- → Deneyim kaydı: Önceki çalıştırmalarda çıkarılan sinyal blokları, algoritmaya bağlamsal ipuçları olarak verilir.
- → Bağlamsal yayılım: Bu sinyallerin birlikte görülme eğilimleri, tüm özellikler üzerinde global bir ağırlıklandırma mekanizması kurar.
- → Süreklilik: Ağırlıklandırılmış özellikler, sonraki tüm katmanlarda tekrar kullanılarak bağlam korunur.
Sonuç: Algoritma, önceki deneyimlerin işaret ettiği bağlamları da dikkate alır. Böylece çözüm uzayı yalnızca anlık veriye değil, geçmiş deneyimlerle zenginleştirilmiş bağlama duyarlı hale gelir.
Deneyim transferi, LMFO’nun çalıştırmalar arası hafıza aktarımı mekanizmasının çekirdeğidir. Bu mekanizma sayesinde LMFO, yalnızca veri işleyen bir algoritma değil; deneyimle güçlenen, bağlama duyarlı bir karar destek sistemi haline gelir.
4.4. Temsil Dengeleme
Amaç: Nadir ama anlamlı sinyallerin analiz sürecinde kaybolmasını önlemek.
- → Temsil sorunu: Düşük sıklıkta görünen fakat bağlamda kritik sinyaller belirlenir.
- → Dengeleme: ROS/SMOTE teknikleri ile bu sinyallere benzer yapay örnekler üretilir.
Sonuç: Nadir sinyaller korunur, veri dağılımı dengelenir; böylece algoritmanın odaklı arama stratejilerinin verimliliği artar.
4.5. İki Aşamalı Boyut İndirgeme
Amaç: Çok geniş arama uzayını yönetilebilir bir boyuta indirirken yüksek potansiyelli özellikleri korumak.
- → Temsil dengeleme öncesi: Ölçeklenmiş özellikler sıralanır ve sinyal potansiyeli zayıf olanlar elenir.
- → Temsil dengeleme sonrası: Özelliklerin bağlamsal uyum ölçütlerine göre sıralama yapılır, hedeflenmiş arama uzayı oluşturulur.
Sonuç: Hesaplama maliyeti astronomik seviyelerden yönetilebilir düzeye iner.
4.6. LMFO’da İlişki Tabanlı Örüntü Tanıma
Amaç: Katmanlar arası bilgi transferi ile bağlamı koruyarak daha kapsamlı örüntüleri çıkarmak.
- → İlişki analizi: Sinyaller bağlamsal uyumuna göre yeniden gruplanır.
- → Çeşitlilik geri kazanımı: Boyut indirgemede elenen fakat bağlam açısından anlamlı özellikler arama uzayına geri eklenir. Bu işlem boyutu değiştirmez; yalnızca çeşitliliği bağlama göre günceller.
- → Örüntü zenginleştirme: Uyumlu olanlar birleştirilerek daha kapsamlı örüntüler üretilir.
Sonuç: Zayıf sinyaller, bağlam içinde anlam kazanarak korunur.
Bu süreç, LMFO’nun katmanlar arası “birikimli çıkarım” (cumulative reasoning) özelliğinin çekirdeğidir.
4.7. Bağlama Duyarlı Arama Stratejisi
Amaç: Arama sürecini sabit kurallar yerine veriden gelen geri bildirimlerle sürekli optimize etmek.
- → Parametre adaptasyonu: Arama uzayının boyutu ve çeşitliliği dinamik biçimde değişir.
- → Yön değişimi: İlerleme yavaşladığında strateji değiştirilir, verimli bölgeler hedeflenir.
- → Bağlama duyarlı strateji: Her aday örüntü için arama uzayı sürekli güncellenir.
Sonuç: LMFO, bağlama özgü arama uzayına odaklanarak daha verimli aramalar yapar.
4.8. Genellenebilirlik ve İstatistiksel Doğrulama
Amaç: Üretilen örüntülerin doğruluğunu ve genellenebilirliğini objektif biçimde ölçmek.
- → Çıktı dönüşümü: İkili temsiller okunabilir değerlere dönüştürülür.
- → Bağımsız test: Çıkarılan örüntüler, doğrulama ve test setleri üzerinde ayrı ayrı değerlendirilir.
- → Kademeli değerlendirme: Performans farklı zorluk seviyelerine göre analiz edilir.
- → İstatistiksel doğrulama: Genellenebilirlik, tutarlılık ve anlamlılık değerlendirilir.
5. Gerçek Dünya Kullanım Senaryoları
LMFO, yalnızca yüksek doğruluk hedefleyen bir algoritma değil; istatistiksel olarak zayıf ancak bağlamsal olarak güçlü sinyallerden örüntü çıkarabilen, bağlama duyarlı ve sezgisel zeka temelli bir karar destek sistemidir. Modüler ve kolay genişletilebilir katmanlı mimarisi, farklı veri türleri ve problem alanlarına uyarlanabilmesini kolaylaştırır. Bağlama duyarlı optimizasyon süreci ise sınırlı veri ve yüksek belirsizlik koşullarında dahi güvenilir ve genellenebilir sonuçlar üretir.

Bu yapının gerçek dünyadaki işleyişi, endüstriyel bakım alanından alınan aşağıdaki senaryo üzerinden gösterilmektedir.
5.1. LMFO ile Endüstriyel Alanda Kestirimci Bakım
5.1.1. Problem
Bir otomotiv üretim tesisinde 100 farklı sensör, makinelerin sıcaklık, basınç ve nem gibi kritik parametrelerini sürekli izler. Arıza durumlarında ortalama 25 sensör anormal değer üretir, fakat tetiklenen kombinasyonlar her olayda değişir; tek bir “arıza imzası” yoktur.
5.1.2. Zorluklar
- → Ölçek sorunu: Olası sensör kombinasyonlarının sayısı astronomik düzeydedir — ≈2×10²³.
- → Veri sorunu: Kullanılabilir veri ise yalnızca birkaç bin arıza kaydıyla sınırlıdır; dolayısıyla çözüm uzayının çok küçük bir bölümü gözlemlenebilmiştir.
- → Gürültü sorunu: Bu veri sorunu, klasik yöntemlerin nadir ama kritik sinyalleri “gürültü” olarak dışlamasına yol açabilir.
5.1.3. LMFO’nun Katkısı
LMFO, bu zorlukları üç temel yetenekle aşar:
- → Gösterge örüntü: LMFO, sınırlı kayıtlardan arıza riski yüksek 10 sensörlük örüntüleri çıkarır.
- → Risk yönetimi: Göstergenin 5–6/10’u tetiklendiğinde erken işaret, 7–8/10’da güçlü uyarı, 9–10/10’da kritik alarm üretir. Böylece yanlış alarmlar azalır, risk seviyesi derecelendirilir.
- → Kısıtlı veriyle öngörü: Henüz gözlemlenmemiş arıza senaryolarını bile tahmin edebilir.
Bu üç yetenek, “kestirimci bakım” stratejisini güçlendirir: arızaları önceden işaretlemek, risk seviyesini sınıflandırmak ve sınırlı veriyle olası senaryoları öngörmek.
5.1.4. İş Değeri
Bağımsız sektör raporları, kestirimci bakımın somut faydalarını ortaya koymaktadır:
- → Operasyonel güvenilirlik: Önleyici bakımdan kestirimci bakıma geçiş, plansız duruşu %30–50 azaltır; ekipman ömrünü %20–40 artırır (McKinsey, 2017).
- → Maliyet tasarrufu: Bakım maliyetleri %5–10 düşer ve işletme giderleri yaklaşık %12 azalır. Ayrıca çalışabilirlik (uptime) %10–20 artar, varlık ömrü yaklaşık %20 uzar (Deloitte, 2017; PwC & Mainnovation, 2018).
- → Finansal etki: Büyük üretim tesislerinde yıllık on milyonlarca euro tasarruf sağlanır (Siemens – Senseye Predictive Maintenance, case studies & ROI reports, 2021–2024).
5.2. Farklı Sektörlere Uyarlanabilirlik
LMFO, özelliklere bağımlı olmayan katmanlı mimarisi sayesinde belirli bir veri tipine veya sektöre bağlı değildir. Bu sayede farklı sektörlerdeki kombinatoryel sorunlarda doğrudan kullanılabilir bir çekirdek yapıya sahiptir. Yalnızca amaç fonksiyonunun bazı bileşenleri, problem gereksinimlerine göre yeniden tanımlanması gerekebilir. Ancak bu uyarlama her durumda zorunlu değildir.
Sektörel Uygulama Örnekleri:
- Siber Güvenlik (SOC/Tehdit Algılama)
→ 90 log türü: Tipik bir saldırıda ortalama 25’i anormalleşir. LMFO kritik 8 log imzasını çıkarır.
→ Sonuç: Tehdit seviyesi kısmi eşleşmelerle otomatik derecelendirilir. - Telekomünikasyon Ağ Yönetimi
→ 85 KPI: Bir ağ kesintisinde ortalama 20’si anormallik gösterir. LMFO kritik 9 KPI paterni belirler.
→ Sonuç: Ağ arızaları başlamadan proaktif bakım tetiklenir. - Finans/Bankacılık (Dolandırıcılık Analitiği)
→ 80 risk göstergesi: Olay başına ortalama 18’i tetiklenir. LMFO 7 indikatörlü risk paterni çıkarır.
→ Sonuç: İşlem akışlarında eşleşme oranına göre risk puanı anlık güncellenir. - Enerji/Akıllı Şebeke Yönetimi
→ 75 parametre: Arıza durumunda ortalama 22’si kritikleşir. LMFO 10 kritik örüntü belirler.
→ Sonuç: Bölgesel arıza başlamadan önce müdahale yapılır. - Demiryolu Trafik ve Sinyalizasyon
→ 70 sinyal: Bir trafik olayında ortalama 15’i anormallik gösterir. LMFO 9 sinyallik örüntü çıkarır.
→ Sonuç: Erken uyarılarla rota veya hız optimizasyonu sağlanır.
Bu örnekler, LMFO’nun sektör bağımsız, esnek ve ölçeklenebilir yapısıyla farklı alanlarda stratejik değer üretebildiğini göstermektedir.
6. Benchmark Ortamı ve Veri Seti
Gerçek dünyada LMFO’nun dayanıklılığını ve genelleme kapasitesini sınamak için Türkiye’de kamuya açık “On Numara” veri seti seçilmiştir. Bu veri seti, son derece düşük sinyal/gürültü oranı, sınırlı gözlem verisi ve aşırı geniş arama uzayıyla zorlu senaryoları güçlü bir şekilde temsil eder.
6.1. Problem
80 farklı öğeden oluşan sistemde her olayda yalnızca 22 öğe aktif hâle gelir. Bu aktif öğelerin kombinasyonları olaydan olaya değişir; dolayısıyla tek bir “kritik imza” yoktur. Bu durum yüksek ölçekte belirsizlik yaratır.
6.2. Zorluklar
- → Ölçek sorunu: Potansiyel öğe kombinasyonlarının sayısı astronomik düzeydedir — ≈2×10¹⁹.
- → Veri sorunu: Kullanılabilir veri 1.200 olay kaydıyla sınırlıdır; dolayısıyla arama uzayının %99,99’dan fazlası gözlemlenememiştir.
- → Gürültü sorunu: İstatistiksel olarak zayıf fakat bağlam içinde anlamlı sinyaller yüksek belirsizlik içinde kolayca kaybolur.
6.3. Gerçek Dünya Karşılığı
Bu yapı, sınırlı gözlem ve düşük sinyal/gürültü koşullarında, henüz tüm göstergeler ortaya çıkmadan, kritik olay imzalarının gösterge örüntüler üzerinden tespit edilmesini gerektiren senaryolarla örtüşür.
6.4. Gösterge Örüntü Çözümü
Gösterge örüntü yaklaşımı, her olayda aktif olan 22 öğeden örneğin 10’lu örüntülerin çıkarılmasını ifade eder. Bu yöntem yukarıdaki zorlukların aşılması için algoritmaya üç temel avantaj sunar:
- → Ölçeklenebilirlik: Devasa arama uzayını küçülterek algoritmanın yönetilebilir ve odaklanmış bir çözüm alanında çalışmasını sağlar (bkz. a, b ve c maddeleri).
- → Odaklı görünürlük: Kısıtlı gözlem verisini anlamlı bir çözüm uzayına dönüştürerek veri sorununu büyük ölçüde hafifletir (bkz. d, e ve f maddeleri).
- → Sinyal koruma: İstatistiksel olarak zayıf fakat bağlam içinde anlamlı sinyallerin, ölçeklenebilir ve odaklı yapı içinde korunmasına yardımcı olur.
6.5. Teknik Açıklama
- a. Ham arama uzayı: 80 öğeden 22 aktif öğenin seçimi: C(80;22) ≈ 2,7 x 10¹⁹.
- b. Ölçeklenen arama uzayı: 80 öğeden 10 aktif öğenin seçimi: C(80;10) ≈ 1,6 x 10¹².
- c. Ölçek kazancı: Arama uzayı yaklaşık 16 milyon kat küçülür: C(80;22)/C(80;10) ≈ 1,6 × 10⁷.
- d. Çözüm uzayı: Tek olayda görünürlük, aktif 22 öğeden 10 öğenin seçimi: C(22;10) = 646.646.
- e. Ölçeklenen çözüm uzayı: 1.200 olayda görünürlük: 646.646 x 1.200 ≈ 7,8×10⁸.
- f. Veri kazancı: Gözlenebilirlik yaklaşık 10 trilyon kat artar: (e/b)/(1.200/a) ≈ 1,1 × 10¹³.

7. Performans Ölçüm Yöntemi
LMFO, makine öğrenmesi modelleri gibi parametre optimizasyonuna dayanmaz; tek başına anlamsız görünen sinyallerin oluşturduğu gösterge örüntüleri doğrudan bağlam içinde optimize eder. Bu nedenle algoritmanın başarısı, sinyaller yerine örüntülerin performansı üzerinden değerlendirilir.
Analiz Sürecinin Adımları
- → Doğrulama seti: Eğitim dışında kalan veriler, ilk performans sinyallerini verir.
- → Test seti: Bağımsız veri ile genellenebilirlik değerlendirilir.
- → Kademeli performans ölçümü: Farklı sinyal yoğunlukları üzerinden performans ölçülür; tutarlılık ve dayanıklılık değerlendirilir.
- → Karşılaştırmalı değerlendirme: Doğrulama ve test sonuçları bütüncül biçimde değerlendirilir.
Performans ölçümünde izlenen adımlar ve değerlendirme kriterleri aşağıdaki görselde özetlenmiştir.

Bu adımlar, LMFO’nun zayıf sinyalleri bağlam içinde tespit edebilme kapasitesini nesnel olarak sınar ve algoritmanın tamamen yeni veri setlerinde, farklı zorluk seviyelerine göre güvenilir ve tekrarlanabilir sonuçlar üretme yeteneğini ortaya koyar.
Performans ölçütleri
- → Patern Tanıma Skoru (PTS): Sinyal yoğunluklarına göre normalize edilmiş doğruluk ölçümü.
- → Beklenen Patern Skoru (BPS): Örüntülerin, 1’e eşit olan standart bir ölçekle değerlendirilmesi.
- → İstatistiksel anlamlılık: p < 0,05, üst kuyruklu z-testi.
Yorumlama
- PTS > 1 → Örüntüler, beklenen skorlardan daha başarılı.
- PTS < 1 → Örüntüler, beklenen skorlardan daha başarısız.
Örnek:
- 8/10 kategorisi için PTS = 1,72 → Örüntüler, beklenen skorlardan %72 daha başarılı.
- 9/10 kategorisi için PTS = 0,95 → Örüntüler, beklenen skorlardan %5 daha başarısız.
Bu çerçeve, LMFO’nun yüksek gürültülü ortamlarda bağlamsal çıkarım gücünü nesnel biçimde ölçmek için geliştirilmiştir.
7.1. Teknik Açıklama
7.1.1. Patern Tanıma Skoru (PTS)
Örüntülerin gerçekleşen başarıları, farklı sinyal yoğunlukları arasında doğrudan kıyas yapılabilmesi için normalize edilmiştir. Böylece nadir sinyallerin (ör. 9/10, 10/10) etkisi artırılırken, nispeten sık görülen sinyallerin (ör. 6/10, 7/10) etkisi azaltılır.
PTS = (Gerçekleşen Başarılı Örüntü Sayısı / Sinyal Yoğunluğu) / (Toplam Örüntü Sayısı x Gözlem Sayısı)
→ Sonuç: Başarı ölçümü sinyal-gürültü perspektifinden daha dengeli hale gelir.
7.1.2. Beklenen Patern Skoru (BPS)
Her kategori için örüntülerin beklenen başarıları aynı yöntemle normalize edilerek temel ölçüt oluşturulur.
BPS = (Beklenen Başarılı Örüntü Sayısı / Sinyal Yoğunluğu) / (Toplam Örüntü Sayısı x Gözlem Sayısı)
BPS ifadesinde yer alan “Beklenen Başarılı Örüntü Sayısı” şuna eşittir:
Beklenen Başarılı Örüntü Sayısı = Sinyal Yoğunluğu × Toplam Örüntü Sayısı × Gözlem Sayısı
Bu eşitlik BPS ifadesinde yerine konduğunda sonuç her zaman 1’e eşit olur.
→ Sonuç: Çıkarılan örüntülerin başarısı, beklenen başarılara göre 1’e eşit olan standart bir ölçek üzerinden ölçülebilir.
Teknik Not: Çalışmada toplam 1.369 olay kaydı kullanılmıştır: eğitim = 1.200, doğrulama = 121, test = 48.
8. Yüksek Gürültülü Gerçek Dünya Veri Setlerinde Performans Analizi
LMFO, sıfırdan ya da önceden belirlenmiş küçük başlangıç çözümleri (ör. 3’lü veya 4’lü çekirdekler) ile başlatılabilir. Bu çekirdekler, bağlam analizini ilk katmandan itibaren devreye sokarak örüntü kalitesini ve işlem hızını artırır. Uygulamada algoritmaya çok sayıda çekirdek verilir. Bunlar katmanlar boyunca analiz edilir ve yalnızca en az bir bağlama sahip olanlar gösterge örüntülere dönüştürülür.
4’lü çekirdek → K1 → 7’li örüntüler → K2 → 9’lu örüntüler → K3 → 10’lu gösterge örüntüler
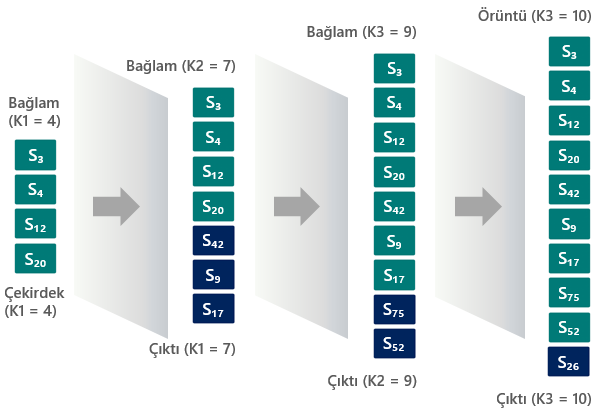
Algoritmanın bağlama duyarlı sezgisel çıkarım gücünü kapsamlı şekilde sınamak için iki tür çekirdek çözüm kullanılmıştır:
- → Optimize çekirdekler: Algoritmanın daha önce çıkardığı 4’lü örüntüler (214 adet).
- → Rastgele çekirdekler: Tamamen rastgele seçilmiş 4’lü setler (216 adet).
Bu çekirdek grubunun her ikisi de algoritmaya başlangıç çözümü olarak verilmiştir.
Amaç
- → Algoritmanın yüksek gürültü koşullarında örüntü tanıma performansını gözlemlemek.
- → Tek başına zayıf sinyalleri bağlam içinde güçlü örüntülere dönüştürme kapasitesini sınamak.
- → Rastgele çekirdeklerden anlamlı örüntüler çıkarabilme yeteneğini test etmek.
- → Farklı başlangıç koşullarında algoritmanın tutarlılığını görmek.
Aşağıdaki tablo, örüntü yoğunluğu arttıkça sinyal sıklığının hızla azaldığını ve bu durumun problemin doğasını son derece güç bir hale getirdiğini göstermektedir. Bu, yüksek eşleşme seviyelerine çıkıldığında (ör. 9/10, 10/10) başarıyı korumanın neden olağanüstü zor olduğunu gösterir.
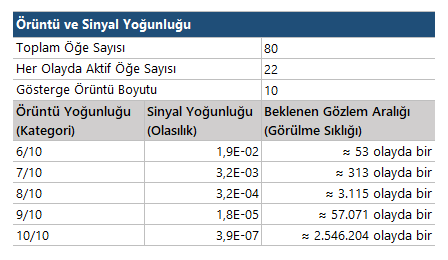
Çalışmada kullanılan gerçek dünya veri seti, yüksek gürültü ve sınırlı gözlem koşullarında örüntü tanıma sürecinin zorluğunu açıkça ortaya koymaktadır. Bu zorluk, LMFO’nun amaçlanan “genellenebilirlik, tutarlılık ve dayanıklılık performansını” sınamak için güçlü bir benchmark ortamı oluşturmuştur.
Sonuçlar, önceden belirlenmiş 5 farklı hiperparametre optimizasyonuyla elde edilmiştir. Her iki çekirdek grubu bu konfigürasyonlarla eğitim verisi üzerinde çalıştırılmış, doğrulama ve test setlerinde bağımsız olarak sınanmıştır. Sonuçların ortalaması alınarak performans değerlendirilmiştir.
8.1. Doğrulama Setinde Örüntü Tanıma Performansı
Bu bölümde sunulan sonuçlar, optimize ve rastgele çekirdeklerle eğitim setinden çıkarılan örüntülerin doğrulama setinde sınanmasına dayanmaktadır.
8.1.1. Doğrulama Seti — Optimize Çekirdekler
Önceki bölümlerde tanımlanan LMFO’nun katmanlı ve bağlama duyarlı çıkarım mekanizmasının etkileri, doğrulama setinde açıkça ortaya çıkmaktadır.
Aşağıdaki tabloda:
- Gerçekleşen Değer → LMFO’nun çıkardığı örüntülerin doğrulama setindeki aktif öğelerle eşleşme sayısıdır.
- Beklenen Değer → Olasılık teorisine göre aynı koşullarda beklenen ortalama değerdir.
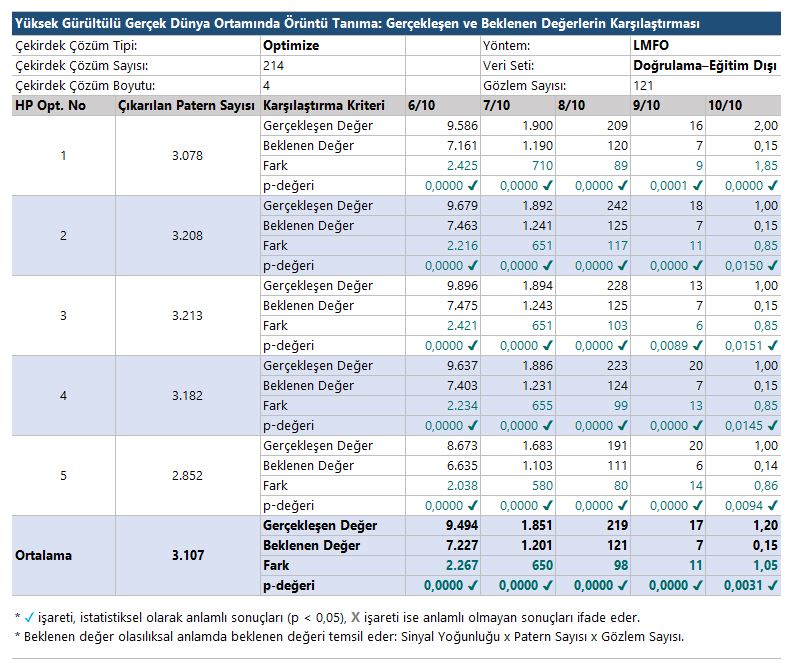
Tabloya göre LMFO, optimize çekirdeklerle tüm sinyal yoğunluklarında (6/10–10/10) beklenen değerin üzerinde anlamlı sonuçlar üretmiştir (p < 0,05).
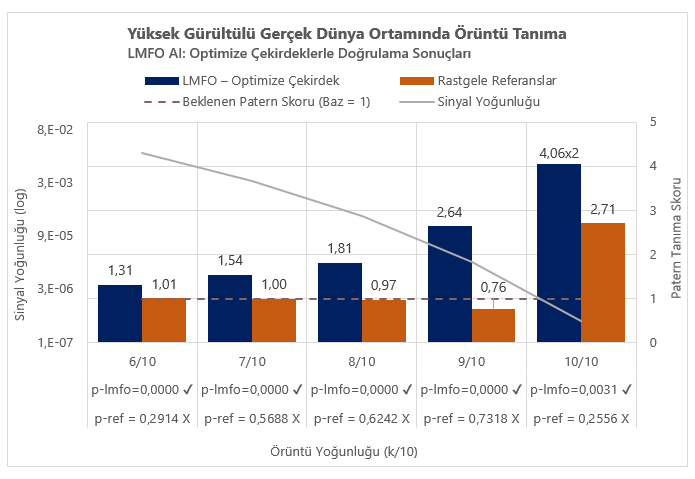
LMFO, tüm sinyal yoğunluklarında baz değer (BPS) üzerinde sonuç vermiştir:
- Yüksek sinyal yoğunluğu (6/10–7/10) → PTS: %31–54 daha yüksek
- Orta sinyal yoğunluğu (8/10) → PTS: %81 daha yüksek
- Düşük sinyal yoğunluğu (9/10–10/10) → PTS: 2,64 kat ve 8,12 kat (4,06×2) daha yüksek
Öne Çıkan Noktalar
Optimize çekirdeklerle elde edilen sonuçlar, LMFO’nun bağlamsal çıkarım gücünün yüksek gürültü ortamında çalıştığını göstermektedir. Tekil öğeler (örneğin veri setindeki özellikler) bağımsız olarak analiz edildiğinde genellikle “istatistiksel bir sinyal” taşımazken, algoritma bu öğeleri bağlam içinde analiz ederek anlamlı örüntüler ortaya çıkarmaktadır. Özellikle düşük sinyal yoğunluğunda çıkarılan örüntüler, baz değere (1) göre 8 kat daha yüksek skor üretmiştir. Bu bulgu, LMFO’nun“zayıf sinyali bağlam içinde yeniden yapılandırma” mekanizmasına işaret etmektedir.
Not: Grafikte sinyal yoğunluğu logaritmik ölçekte gösterilmiştir. 10/10 kategorisinde rastgele oluşturulan referans çözümlerin performansı baz değerden sapma göstermiştir, ancak bu fark istatistiksel olarak anlamlı değildir (p = 0,2556).
8.1.2. Doğrulama Seti — Rastgele Çekirdekler
Doğrulama setindeki sonuçlar, LMFO’nun veri odaklı önceliklendirme ve adaptif arama stratejilerinin etkisini ortaya koymaktadır. Bu stratejiler sayesinde verimsiz çekirdekler hızla elenmiş, sinyal potansiyeli taşıyanlar katmanlar boyunca derinleştirilmiş ve rastgele çekirdeklerden yüksek gürültü altında anlamlı örüntüler ortaya çıkarılabilmiştir.

Tabloya göre LMFO, rastgele çekirdeklerle 6/10–9/10 aralığındaki tüm sinyal yoğunluklarında beklenen değerin üzerinde anlamlı sonuçlar vermiştir (p < 0,05).

LMFO’nun rastgele çekirdeklerle performansı:
- Yüksek sinyal yoğunluğu (6/10–7/10) → PTS: %5–8 daha yüksek
- Orta sinyal yoğunluğu (8/10) → PTS: %19 daha yüksek
- Düşük sinyal yoğunluğu (9/10) → PTS: %86 daha yüksek
Öne Çıkan Noktalar
Rastgele başlangıçlara rağmen LMFO, 6/10–9/10 aralığında referanstan anlamlı biçimde ayrışmıştır. Özellikle 9/10 gibi zayıf sinyal yoğunluklarında gözlenen yüksek başarı (%86), algoritmanın “ilgili olanı hızla ayırt etme” ve “yeniden yönlenme” yeteneklerini göstermektedir. Bu sonuç, LMFO’nun yüksek gürültü ve düşük sinyal yoğunluğunda dayanıklılığını teyit etmektedir.
Not: En düşük sinyal yoğunluğundaki (10/10) fark istatistiksel olarak anlamlı bulunmamıştır (p = 0,4325).
8.2. Test Setinde Genelleme Performansı
Bu bölüm, test setinde LMFO’nun optimize ve rastgele çekirdek çözümlerle gösterdiği genelleme performansını ortaya koyar.
8.2.1. Test Seti — Optimize Çekirdekler
LMFO’nun optimize çekirdeklerle doğrulama setinde elde ettiği sonuçların bağımsız veride de korunup korunmadığı değerlendirilmiştir.
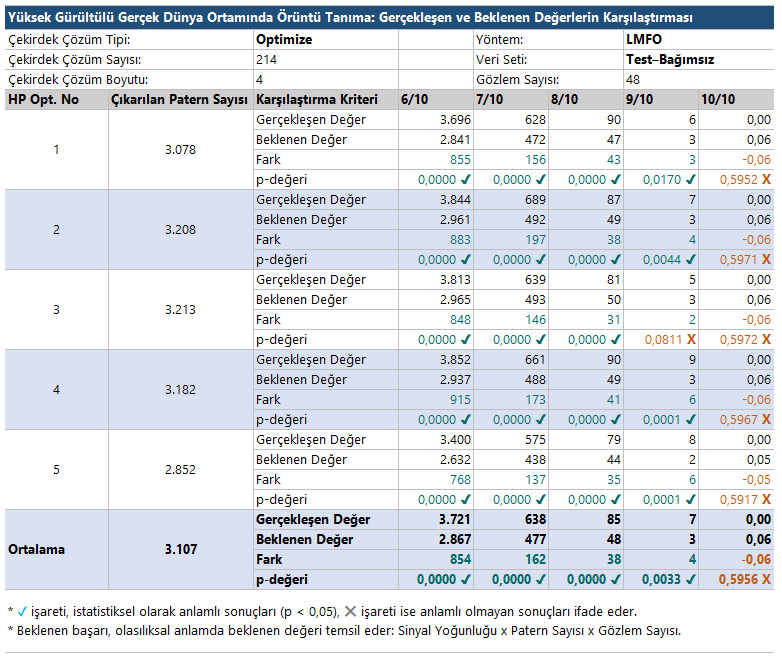
Tabloya göre LMFO, optimize çekirdeklerle 6/10–9/10 aralığındaki tüm sinyal yoğunluklarında beklenen değerin üzerinde anlamlı sonuçlar vermiştir (p < 0,05). Bu eğilim, doğrulama setinde gözlenen bulgularla da paraleldir. Böylece farklı veri setlerinde tutarlı bir performans ortaya çıkmıştır.
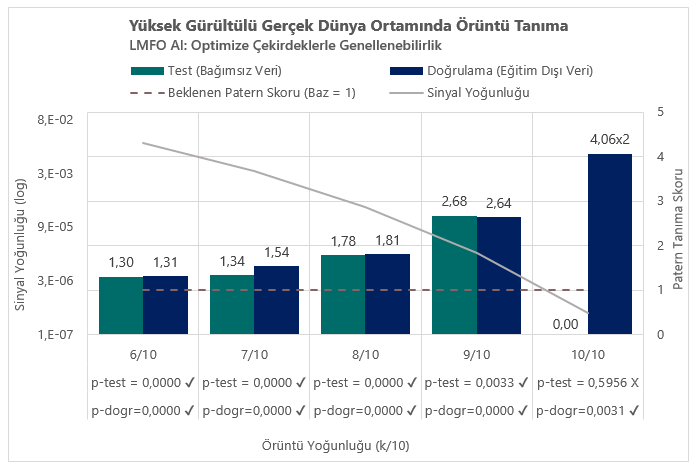
LMFO’nun optimize çekirdeklerle test setinde performansı:
- Yüksek sinyal yoğunluğu (6/10–7/10) → PTS: %30–34 daha yüksek
- Orta sinyal yoğunluğu (8/10) → PTS: %78 daha yüksek
- Düşük sinyal yoğunluğu (9/10) → PTS: 2,68 kat daha yüksek
Öne Çıkan Noktalar
Test seti sonuçları, LMFO’nun sezgisel çıkarım gücünün yalnızca eğitim/doğrulama aşamalarına özgü olmadığını göstermektedir. 6/10–9/10 aralığındaki tüm sinyal yoğunluklarında doğrulama setinde gözlenen eğilim, bağımsız veri üzerinde de korunmuştur. Bu tutarlılık, LMFO’nun bağlama duyarlı çıkarım mekanizmasının genellenebilirliğini teyit etmektedir.
Not: En zayıf sinyal yoğunluğunda (10/10) anlamlı bir fark gözlenmemiştir (p = 0,5956). Bu sonuç, test setinin sınırlı boyutundan kaynaklanmış olabilir.
8.2.2. Test Seti — Rastgele Çekirdekler
Bu bölümde, LMFO’nun rastgele çekirdeklerle doğrulama setinde gözlenen performansının bağımsız veri üzerinde de sürüp sürmediği değerlendirilmiştir.
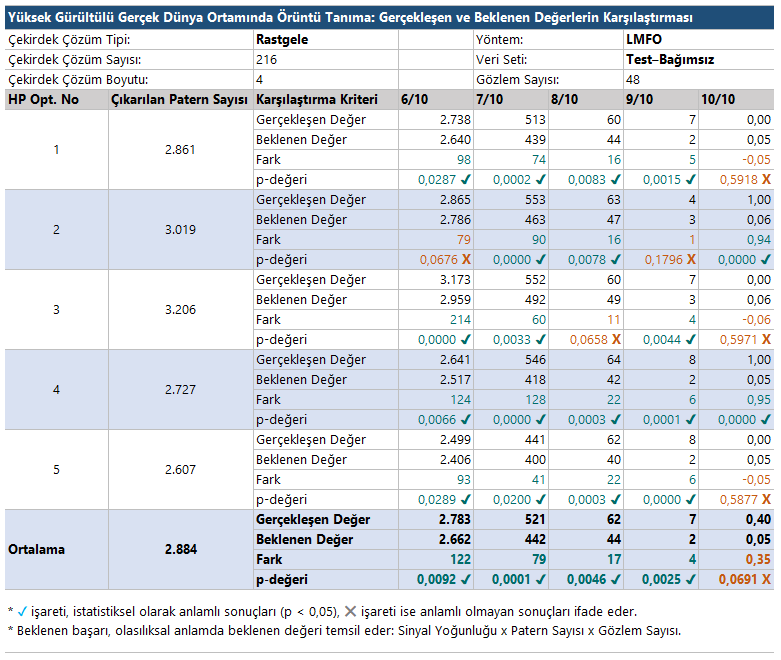
Tabloya göre LMFO, rastgele çekirdeklerle dahi 6/10–9/10 aralığındaki tüm sinyal yoğunluklarında beklenen değerin üzerinde anlamlı sonuçlar üretmiştir (p < 0,05). En zayıf sinyal yoğunluğuna sahip 10/10 seviyesinde ise p = 0,0691 ile %95 güven seviyesinde anlamlılık sağlanamamış, ancak %90 güven seviyesinde anlamlı başarı elde edilmiştir.
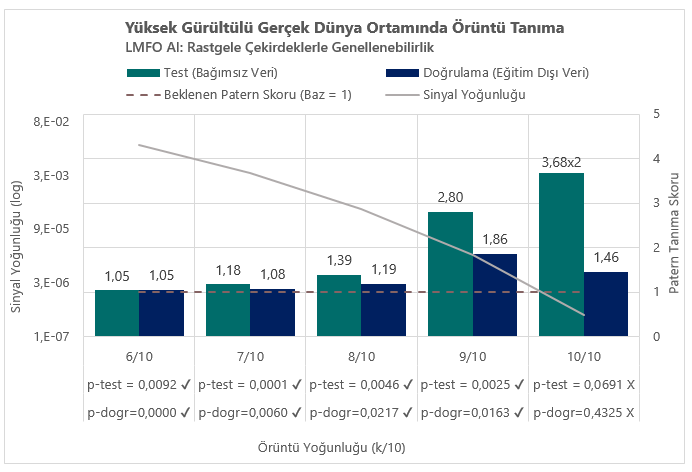
LMFO’nun rastgele çekirdeklerle test setinde performansı:
- Yüksek sinyal yoğunluğu (6/10–7/10) → PTS: %5–18 daha yüksek
- Orta sinyal yoğunluğu (8/10) → PTS: %39 daha yüksek
- Düşük sinyal yoğunluğu (9/10) → PTS: 2,80 kat daha yüksek
- En zayıf sinyal yoğunluğu (10/10) → PTS: 7,36 kat (3,68×2) daha yüksek. Sonuç, %95 güven seviyesinde anlamlı değil, ancak %90 seviyesinde anlamlıdır.
Öne Çıkan Noktalar
LMFO, hiçbir ön bilgi içermeyen rastgele çekirdeklerden eğitim aşamasında çıkardığı örüntülerin doğrulama setindeki anlamlılığını, test setinde de korumuştur. Bu örüntülerin anlamlılığının yalnızca farklı veri setlerinde değil, aynı zamanda farklı çekirdek türlerinde de korunması, LMFO’nun zorlu koşullarda güvenilir ve genellenebilir sonuçlar üretebildiğini göstermektedir.
8.3. Genellenebilirlik, Dayanıklılık ve Tutarlılık
Aşağıdaki tablo, optimize ve rastgele çekirdeklerle doğrulama ve test setlerinde elde edilen örüntü skorlarını ve anlamlılık düzeylerini göstermektedir.
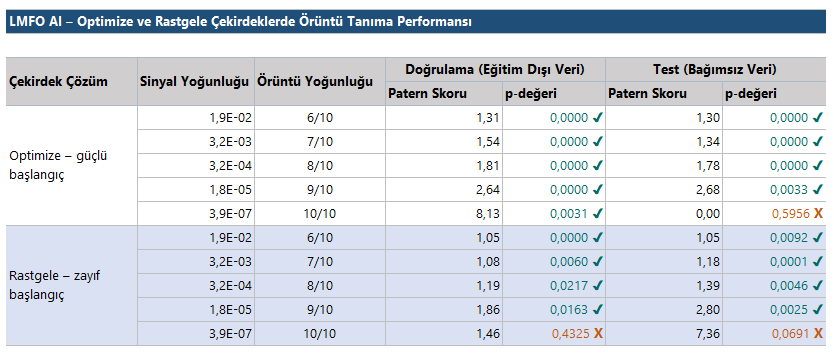
Tabloya göre optimize çekirdekler daha yüksek skorlara ulaşmış, rastgele çekirdekler ise daha zayıf bağlamsal koşullara rağmen anlamlı sonuçlar üretmiştir. Ancak optimize çekirdekler olmadan, özellikle yüksek ve orta sinyal yoğunluklarında baz değer 1’e göre belirgin skor farkları görülmemiştir.

LMFO’nun doğrulama ve test setlerinde farklı sinyal yoğunluklarına göre örüntü tanıma performansı:
Yüksek ve orta sinyal yoğunlukları (6/10–8/10)
- Optimize çekirdekler: Doğrulama ve test skorları neredeyse aynıdır (1,30–1,81 aralığında).
- Rastgele çekirdekler: Skorlar daha düşük (1,05–1,39), ancak genellenebilirlik korunmuştur.
Düşük sinyal yoğunluğu (9/10–10/10)
- Optimize çekirdekler: 9/10’da güçlü ve tutarlı skorlar (2,64 → 2,68); 10/10’da doğrulama güçlü (8,12), fakat test setinde anlamlı sonuç yoktur.
- Rastgele çekirdekler: 9/10’da tutarlı ve anlamlı skorlar (1,86 → 2,80). 10/10’da doğrulama %95 güven seviyesinde anlamlı değil (1,46), ancak test seti 7,36 skorla %90 seviyesinde anlamlı çıkmıştır.
Öne Çıkan Noktalar
LMFO, yüksek gürültü altında optimize (güçlü) ve rastgele (zayıf) çekirdeklerle anlamlı örüntüler çıkarabilmiştir. Doğrulama ve test setleri arasındaki tutarlılık, algoritmanın zorlu koşullarda güvenilir ve genellenebilir sonuçlar üretebildiğini ortaya koymaktadır. Bunun yanı sıra, yalnızca farklı başlangıç koşullarında değil, aynı zamanda farklı sinyal yoğunluklarında da tutarlılığın korunması, LMFO’nun dayanıklılığını güçlü bir şekilde teyit etmektedir.
9. Sonuç
LMFO, istatistiksel olarak zayıf ama bağlamsal olarak güçlü sinyallerden örüntü çıkarır; sınırlı veri ve yüksek gürültü koşullarında güvenilir karar desteği sağlar. Bu yaklaşım, belirsizliğin yoğun olduğu veri ortamlarında dahi tutarlı ve genellenebilir sonuçlar üretme kapasitesiyle değerini gösterir.
Gerçek dünyada bu; endüstriyel kestirimci bakımda arızaları önceden işaretleyen, finans sektöründe riskli işlemleri sınıflandıran, siber güvenlikte kritik log imzalarını belirleyen veya telekom ağlarında olası kesintileri önceden tespit eden çözümler anlamına gelir.
Katmanlı yapısı, adaptif arama stratejileri ve bağlama duyarlı çıkarım gücü sayesinde LMFO, özellikle geleneksel yöntemlerin yetersiz kaldığı sınırlı veri ve düşük sinyal/gürültü koşullarında fark yaratır. Doğrulama ve test setlerinde elde edilen bulgular, LMFO’nun tek bir senaryoya özgü geçici başarılar üretmediğini; farklı veri setleri, başlangıç koşulları ve zorluk seviyelerinde de tutarlı ve genellenebilir performans sağladığını göstermektedir. Dolayısıyla LMFO, yüksek gürültü altında dahi güvenilir bir yapay zeka çözümü olarak öne çıkar.
Sonuç olarak, LMFO doğrudan endüstriyel senaryolara uygulanabilir, yapay sezgi tabanlı bir karar destek sistemidir. Bu yönüyle, sınırlı veri ve yüksek gürültü ortamında anlamlı örüntüleri ortaya çıkaran, dayanıklı ve somut iş değeri üreten yenilikçi algoritmalardan biridir.
LMFO’nun açık kaynak uygulamasına GitHub üzerinden ulaşabilirsiniz.
İshak Kutlu