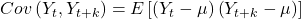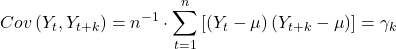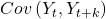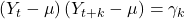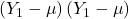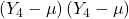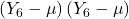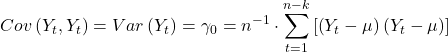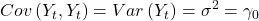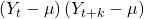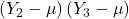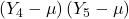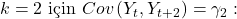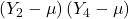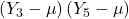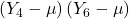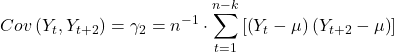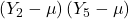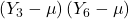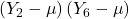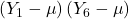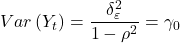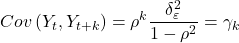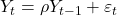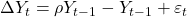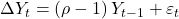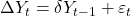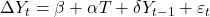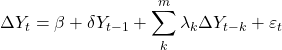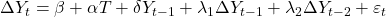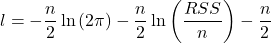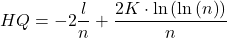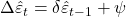
Zaman Serileri İçin Durağanlık Testleri

Z


Durağanlığın Tespit Edilmesi

Zaman serilerinde durağanlığın ve/veya birim kökün tespit edilmesi ile durağan olmayan serilerinin durağan duruma getirilmesine ilişkin kullanılan temel yöntemler aşağıda ele alınmıştır.

1.  Otokovaryans, Varyans ve Otokorelasyon Katsayısı

Otokovaryans, bir değişkenin kendinden önceki gecikmeli değişkeni ile olan doğrusal ilişkinin yönünü ve gücünü temsil eder. Bununla birlikte bu makalede Y’nin kovaryansı ile otokovaryansı aynı anlamda kullanılmaktadır. Varyans ise bir değişkenin kendi ortalaması etrafında yaptığı salınımların karesi olarak ifade edilebilir. Aşağıda \displaystyle {Y_t} için ortalama, varyans ve kovaryans (otokovaryans) gösterilmiştir.
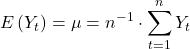
\displaystyle E\left( {{Y_t}} \right) = \mu  = {n^{ - 1}} \cdot \sum\limits_{t = 1}^n {{Y_t}}

\displaystyle Var\left( {{Y_t}} \right) = E{\left( {{Y_t} - \mu } \right)^2} = {\sigma ^2} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^n {{{\left( {{Y_t} - \mu } \right)}^2}}  = {\gamma _0}

\displaystyle Cov\left( {{Y_t},{Y_{t + k}}} \right) = E\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)} \right]

\displaystyle Cov\left( {{Y_t},{Y_{t + k}}} \right) = {n^{ - 1}} \cdot \sum\limits_{t = 1}^n {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)} \right]}  = {\gamma _k}

Yukarıdaki ifadelerde n gözlem sayısını, t gözlem sırasını (dönemini), \displaystyle \mu  Y’nin ortalamasını, \displaystyle {\sigma ^2} Y’nin varyansını, k gecikme uzunluğunu ve \displaystyle {\gamma _k} ise Y’nin k gecikme ile kovaryansını (yani Y’nin otokovaryansını) temsil eder.

Aşağıdaki tabloda n=6 ve maksimum gecikme uzunluğu k=5 olduğu varsayılmak suretiyle \displaystyle {Y_t}’nin kovaryansları gösterilmiştir.

\displaystyle {k_{}}\displaystyle Cov\left( {{Y_t},{Y_{t + k}}} \right)\displaystyle {\gamma _k}
0\displaystyle Cov\left( {{Y_t},{Y_{t + 0}}} \right)\displaystyle {\gamma _0}
1\displaystyle Cov\left( {{Y_t},{Y_{t + 1}}} \right)\displaystyle {\gamma _1}
2\displaystyle Cov\left( {{Y_t},{Y_{t + 2}}} \right)\displaystyle {\gamma _2}
3\displaystyle Cov\left( {{Y_t},{Y_{t + 3}}} \right)\displaystyle {\gamma _3}
4\displaystyle Cov\left( {{Y_t},{Y_{t + 4}}} \right)\displaystyle {\gamma _4}
5\displaystyle Cov\left( {{Y_t},{Y_{t + 5}}} \right)\displaystyle {\gamma _5}

Yukarıdaki tabloda \displaystyle {\gamma _0}, \displaystyle {Y_t}’nin (0 dönem gecikmeli kovaryansını) varyansını; \displaystyle {\gamma _1}, \displaystyle {\gamma _2}, \displaystyle {\gamma _3}, \displaystyle {\gamma _4}, \displaystyle {\gamma _5} ise sırasıyla \displaystyle {Y_t}’nin 1, 2, 3, 4 ve 5 dönem gecikmeli kovaryanslarını ifade etmektedir.

Aşağıdaki tablolarda gözlem sayısı n=6 ve maksimum gecikme uzunluğu k=5 olduğu varsayımı altında, her alternatif k için \displaystyle {Y_t}’nin kovaryanslarının hesaplanması gösterilmektedir.
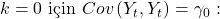
\displaystyle k = 0{\text{ i\c{c}in }}Cov\left( {{Y_t},{Y_t}} \right) = {\gamma _0}:

\displaystyle {t_{}}\displaystyle {Y_t}\displaystyle {Y_{t + k}}\displaystyle \left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right) = {\gamma _k}
1\displaystyle {Y_1}\displaystyle {Y_{1 + 0}} = {Y_1}\displaystyle \left( {{Y_1} - \mu } \right)\left( {{Y_1} - \mu } \right)
2\displaystyle {Y_2}\displaystyle {Y_{2 + 0}} = {Y_2}\displaystyle \left( {{Y_2} - \mu } \right)\left( {{Y_2} - \mu } \right)
3\displaystyle {Y_3}\displaystyle {Y_{3 + 0}} = {Y_3}\displaystyle \left( {{Y_3} - \mu } \right)\left( {{Y_3} - \mu } \right)
4\displaystyle {Y_4}\displaystyle {Y_{4 + 0}} = {Y_4}\displaystyle \left( {{Y_4} - \mu } \right)\left( {{Y_4} - \mu } \right)
5\displaystyle {Y_5}\displaystyle {Y_{5 + 0}} = {Y_5}\displaystyle \left( {{Y_5} - \mu } \right)\left( {{Y_5} - \mu } \right)
6\displaystyle {Y_6}\displaystyle {Y_{6 + 0}} = {Y_6}\displaystyle \left( {{Y_6} - \mu } \right)\left( {{Y_6} - \mu } \right)
\displaystyle Cov\left( {{Y_t},{Y_t}} \right) = Var\left( {{Y_t}} \right) = {\gamma _0} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^{n - k} {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_t} - \mu } \right)} \right]}

Yukarıdaki tabloya dikkat edilecek olursa k=0 için \displaystyle {Y_t}’nin kovaryansı varyansına eşittir; \displaystyle Cov\left( {{Y_t},{Y_t}} \right) = Var\left( {{Y_t}} \right) = {\sigma ^2} = {\gamma _0}.

\displaystyle k = 1{\text{ i\c{c}in }}Cov\left( {{Y_t},{Y_{t + 1}}} \right) = {\gamma _1}:

\displaystyle {t_{}}\displaystyle {Y_t}\displaystyle {Y_{t + k}}\displaystyle \left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)
1\displaystyle {Y_1}\displaystyle {Y_{1 + 1}} = {Y_2}\displaystyle \left( {{Y_1} - \mu } \right)\left( {{Y_2} - \mu } \right)
2\displaystyle {Y_2}\displaystyle {Y_{2 + 1}} = {Y_3}\displaystyle \left( {{Y_2} - \mu } \right)\left( {{Y_3} - \mu } \right)
3\displaystyle {Y_3}\displaystyle {Y_{3 + 1}} = {Y_4}\displaystyle \left( {{Y_3} - \mu } \right)\left( {{Y_4} - \mu } \right)
4\displaystyle {Y_4}\displaystyle {Y_{4 + 1}} = {Y_5}\displaystyle \left( {{Y_4} - \mu } \right)\left( {{Y_5} - \mu } \right)
5\displaystyle {Y_5}\displaystyle {Y_{5 + 1}} = {Y_6}\displaystyle \left( {{Y_5} - \mu } \right)\left( {{Y_6} - \mu } \right)
\displaystyle Cov\left( {{Y_t},{Y_{t + 1}}} \right) = {\gamma _1} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^{n - k} {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + 1}} - \mu } \right)} \right]}

\displaystyle k = 2{\text{ i\c{c}in }}Cov\left( {{Y_t},{Y_{t + 2}}} \right) = {\gamma _2}:

\displaystyle {t_{}}\displaystyle {Y_t}\displaystyle {Y_{t + k}}\displaystyle \left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)
1\displaystyle {Y_1}\displaystyle {Y_{1 + 2}} = {Y_3}\displaystyle \left( {{Y_1} - \mu } \right)\left( {{Y_3} - \mu } \right)
2\displaystyle {Y_2}\displaystyle {Y_{2 + 2}} = {Y_4}\displaystyle \left( {{Y_2} - \mu } \right)\left( {{Y_4} - \mu } \right)
3\displaystyle {Y_3}\displaystyle {Y_{3 + 2}} = {Y_5}\displaystyle \left( {{Y_3} - \mu } \right)\left( {{Y_5} - \mu } \right)
4\displaystyle {Y_4}\displaystyle {Y_{4 + 2}} = {Y_6}\displaystyle \left( {{Y_4} - \mu } \right)\left( {{Y_6} - \mu } \right)
\displaystyle Cov\left( {{Y_t},{Y_{t + 2}}} \right) = {\gamma _2} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^{n - k} {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + 2}} - \mu } \right)} \right]}

\displaystyle k = 3{\text{ i\c{c}in }}Cov\left( {{Y_t},{Y_{t + 3}}} \right) = {\gamma _3}:

\displaystyle {t_{}}\displaystyle {Y_t}\displaystyle {Y_{t + k}}\displaystyle \left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)
1\displaystyle {Y_1}\displaystyle {Y_{1 + 3}} = {Y_4}\displaystyle \left( {{Y_1} - \mu } \right)\left( {{Y_4} - \mu } \right)
2\displaystyle {Y_2}\displaystyle {Y_{2 + 3}} = {Y_5}\displaystyle \left( {{Y_2} - \mu } \right)\left( {{Y_5} - \mu } \right)
3\displaystyle {Y_3}\displaystyle {Y_{3 + 3}} = {Y_6}\displaystyle \left( {{Y_3} - \mu } \right)\left( {{Y_6} - \mu } \right)
\displaystyle Cov\left( {{Y_t},{Y_{t + 3}}} \right) = {\gamma _3} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^{n - k} {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + 3}} - \mu } \right)} \right]}

\displaystyle k = 4{\text{ i\c{c}in }}Cov\left( {{Y_t},{Y_{t + 4}}} \right) = {\gamma _4}:

\displaystyle {t_{}}\displaystyle {Y_t}\displaystyle {Y_{t + k}}\displaystyle \left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)
1\displaystyle {Y_1}\displaystyle {Y_{1 + 4}} = {Y_5}\displaystyle \left( {{Y_1} - \mu } \right)\left( {{Y_5} - \mu } \right)
2\displaystyle {Y_2}\displaystyle {Y_{2 + 4}} = {Y_6}\displaystyle \left( {{Y_2} - \mu } \right)\left( {{Y_6} - \mu } \right)
\displaystyle Cov\left( {{Y_t},{Y_{t + 4}}} \right) = {\gamma _4} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^{n - k} {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + 4}} - \mu } \right)} \right]}

\displaystyle k = 5{\text{ i\c{c}in }}Cov\left( {{Y_t},{Y_{t + 5}}} \right) = {\gamma _5}:

\displaystyle {t_{}}\displaystyle {Y_t}\displaystyle {Y_{t + k}}\displaystyle \left( {{Y_t} - \mu } \right)\left( {{Y_{t + k}} - \mu } \right)
1\displaystyle {Y_1}\displaystyle {Y_{1 + 5}} = {Y_6}\displaystyle \left( {{Y_1} - \mu } \right)\left( {{Y_6} - \mu } \right)
\displaystyle Cov\left( {{Y_t},{Y_{t + 5}}} \right) = {\gamma _5} = {n^{ - 1}} \cdot \sum\limits_{t = 1}^{n - k} {\left[ {\left( {{Y_t} - \mu } \right)\left( {{Y_{t + 5}} - \mu } \right)} \right]}

\displaystyle {Y_t}’nin k dönem gecikmeli kovaryansının varyansına bölümü olarak ifade edilen otokorelasyon katsayısı \displaystyle {\rho _k}aşağıdaki gibi hesaplanır.

\displaystyle Var\left( {{Y_t}} \right) = \frac{{\delta _\varepsilon ^2}}{{1 - {\rho ^2}}} = {\gamma _0}

\displaystyle Cov\left( {{Y_t},{Y_{t + k}}} \right) = {\rho ^k}\frac{{\delta _\varepsilon ^2}}{{1 - {\rho ^2}}} = {\gamma _k}

\displaystyle {\rho _k} = \frac{{{\gamma _k}}}{{{\gamma _0}}}

\displaystyle {\rho _k} = \frac{{\left( {{\rho ^k}\cancel{{\frac{{\delta _\varepsilon ^2}}{{1 - {\rho ^2}}}}}} \right)}}{{\left( {\cancel{{\frac{{\delta _\varepsilon ^2}}{{1 - {\rho ^2}}}}}} \right)}}

\displaystyle {\rho _k} = {\rho ^k}

Otokorelasyon katsayısı \displaystyle {\rho _k}, \displaystyle {Y_t} ile \displaystyle {Y_{t + k}} arasındaki doğrusal ilişkinin yönünü ve gücünü temsil eder. Otokorelasyon katsayısı  \displaystyle {\rho _k} genellikle -1 ile 1 arasında değere sahip olabilir.

\displaystyle {k_{}}\displaystyle {{{\gamma _k}} \mathord{\left/ {\vphantom {{{\gamma _k}} {{\gamma _0}}}} \right. \kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _k} = {\rho ^k}
0\displaystyle {{{\gamma _0}} \mathord{\left/ {\vphantom {{{\gamma _0}} {{\gamma _0}}}} \right. \kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _0} = {\rho ^0} = 1
1\displaystyle {{{\gamma _1}} \mathord{\left/ {\vphantom {{{\gamma _1}} {{\gamma _0}}}} \right. \kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _1} = {\rho ^1}
2\displaystyle {{{\gamma _2}} \mathord{\left/ {\vphantom {{{\gamma _2}} {{\gamma _0}}}} \right. \kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _2} = {\rho ^2}
3\displaystyle {{{\gamma _3}} \mathord{\left/ {\vphantom {{{\gamma _3}} {{\gamma _0}}}} \right. \kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _3} = {\rho ^3}
4\displaystyle {{{\gamma _4}} \mathord{\left/ {\vphantom {{{\gamma _4}} {{\gamma _0}}}} \right. \kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _4} = {\rho ^4}
5\displaystyle {{{\gamma _5}} \mathord{\left/ {\vphantom {{{\gamma _5}} {{\gamma _0}}}} \right.\kern-\nulldelimiterspace} {{\gamma _0}}}\displaystyle {\rho _5} = {\rho ^5}

Uygulamada \displaystyle {Y_t}’nin birim kökü yok ve \displaystyle 0 < \rho  < 1 iken gecikme uzunluğu k arttıkça \displaystyle {\rho _k}değeri 0 etrafında salınımlar yapacaktır. \displaystyle {Y_t}’nin birim kökü var (\displaystyle \rho  = 1) iken gecikme uzunluğu k artmasına rağmen \displaystyle {\rho _k}değerinin 0’a yaklaşması yavaş olacaktır.

\displaystyle {\rho _k} = {\rho ^k}

Söz konusu durum aşağıdaki tabloda temsili değerler itibariyle iki farklı seri için gösterilmiştir.

\displaystyle {k_{}}\displaystyle {\rho _k}\displaystyle {\rho ^k}\displaystyle \rho  \ne 1\displaystyle \rho  = 1
1\displaystyle {\rho _1}\displaystyle {\rho ^1}0,2000,971
2\displaystyle {\rho _2}\displaystyle {\rho ^2}-0,5500,948
3\displaystyle {\rho _3}\displaystyle {\rho ^3}-0,2700,930
4\displaystyle {\rho _4}\displaystyle {\rho ^4}0,1050,902
5\displaystyle {\rho _5}\displaystyle {\rho ^5}0,0160,866

Yukarıdaki tabloda birim kökün olmadığı durumu temsil eden \displaystyle \rho  \ne 1 sütununda, \displaystyle {\rho _k} değerleri 0’ın etrafında salınımlar yaparak 0’a yaklaşmaktadır. Birim kökün olduğu durumu temsil eden \displaystyle \rho  = 1 sütununda ise \displaystyle {\rho _k} değerleri 1’e yakın bir seyir izlemekte olup k artmasına rağmen \displaystyle {\rho _k} değerleri çok yavaş azalmaktadır.

m maksimum gecikme sayısı ve n gözlem sayısı olmak üzere maksimum gecikme sayısı için Schwert’in önerdiği aşağıdaki yöntem kullanılabilir.
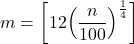
\displaystyle m = \left[ {12{{\left( {\frac{n}{{100}}} \right)}^{\frac{1}{4}}}} \right]

2.  Q İstatistiği

Box ve Pierce tarafından öne sürülen Q istatistiği tüm \displaystyle {\rho _k} değerlerinin aynı anda 0’a eşit olup olmadığını test eder.
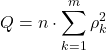
\displaystyle Q = n \cdot \sum\limits_{k = 1}^m {\rho _k^2}

\displaystyle {\rho _k}otokorelasyon katsayısını, k gecikme uzunluğunu, n gözlem sayısını ve m maksimum gecikme uzunluğunu temsil etmektedir. Q istatistiği geniş örneklemlerde m serbestlik derecesi ile ki-kare (\displaystyle {\chi ^2}) dağılımına uyar.

Ljung ve Box ise Q istatistiğini küçük örneklemlerde de m serbestlik derecesi ile ki-kare (\displaystyle {\chi ^2}) dağılımına uyacak şekilde geliştirmişlerdir.
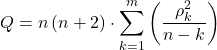
\displaystyle Q = n\left( {n + 2} \right) \cdot \sum\limits_{k = 1}^m {\left( {\frac{{\rho _k^2}}{{n - k}}} \right)}

EViews gibi istatistiksel paket programlarında Q istatistiği olarak Ljung ve Box tarafından geliştirilen denklem kullanılmaktadır.

Q istatistiği ile otokorelasyon katsayılarını temsil eden \displaystyle {\rho _k}’ların 0’a eşitliğini test etmek için hipotez testi aşağıdaki gibi kurulur.
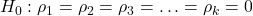
\displaystyle {H_0}:{\rho _1} = {\rho _2} = {\rho _3} =  \ldots  = {\rho _k} = 0

\displaystyle {H_1}:{\rho _1};{\rho _2};{\rho _3}; \ldots ;{\rho _k} \ne 0

Boş hipotezi temsil eden \displaystyle {H_0} tüm \displaystyle {\rho _k} değerlerinin 0’ eşit olduğunu, alternatif hipotezi temsil eden \displaystyle {H_1} ise \displaystyle {\rho _k} değerlerinden en az birinin 0’dan farklı olduğunu ifade eder.

\displaystyle Q > \chi _{\alpha ,{\text{ }}m}^2 ise boş hipotez reddedilir.

\displaystyle Q < \chi _{\alpha ,{\text{ }}m}^2 boş hipotez kabul edilir.

Q istatistiği, \displaystyle \alpha  anlamlılık düzeyinde ve m serbestlik derecesindeki ki-kare (\displaystyle {\chi ^2}) tablo değerinden büyükse boş hipotez reddedilir. Boş hipotezin reddi \displaystyle {\rho _k}’ların tümünün birden 0’a eşit olmadığı, en az bir \displaystyle {\rho _k} değerinin 0’dan farklı olduğu anlamına gelir.

Q istatistiği, \displaystyle \alpha  anlamlılık düzeyinde ve m serbestlik derecesindeki ki-kare (\displaystyle {\chi ^2}) tablo değerinden küçükse boş hipotez kabul edilir. Boş hipotezin kabulü \displaystyle {\rho _k}’ların tümünün birden 0’a eşit olduğu anlamına gelir.

Q istatistiği serinin birim kökü olup olmadığını değil, \displaystyle {\rho _k}’ların doğrudan doğruya 0’a eşit olup olmadığını, yani güçlü durağanlığı test eder. Q istatistiğine göre boş hipotez reddedilse bile \displaystyle {\rho _k} zayıf durağanlık için yeterli sayılabilecek -1 ile 1 arasında 0’a yakın bir değere sahip olabilir.

3.  Dickey-Fuller ve Genişletilmiş Dickey-Fuller Birim Kök Testleri

Dickey-Fuller (DF) birim kök testi, durağanlık sınamalarında en yaygın kullanılan testlerdendir. Birim kök testinin ana çerçevesi sabit içermeyen rassal yürüyüş modeli üzerinden açıklanacaktır.

\displaystyle {Y_t} = \rho {Y_{t - 1}} + {\varepsilon _t},         \displaystyle  - 1 \leqslant \rho  \leqslant 1

Daha önce de belirtildiği gibi \displaystyle \rho  = 1 iken serinin durağan olmadığı, yani birim kökü olduğu anlamına gelir.

Hata terimi \displaystyle {\varepsilon _t}‘nin problemsiz (white noise), yani değişen varyans, otokorelasyon gibi sorunları barındırmayan hata terimi olduğu varsayılmaktadır.

Yukarıdaki modelin her iki tarafından da \displaystyle {Y_{t - 1}} ifadesi çıkarılır.

\displaystyle {Y_t} - {Y_{t - 1}} = \rho {Y_{t - 1}} - {Y_{t - 1}} + {\varepsilon _t}

\displaystyle {Y_t} - {Y_{t - 1}} ifadesi \displaystyle {Y_t}’nin birinci farkı olarak adlandırılır ve aşağıdaki gibi ifade edilir.

\displaystyle \Delta {Y_t} = \rho {Y_{t - 1}} - {Y_{t - 1}} + {\varepsilon _t}

\displaystyle {Y_t}’nin birinci farkı \displaystyle \rho  = 1 iken genellikle seriyi birim kökten kurtararak durağan yapar.

\displaystyle \Delta {Y_t} = {Y_{t - 1}} - {Y_{t - 1}} + {\varepsilon _t}

\displaystyle \Delta {Y_t} = {\varepsilon _t}

Bir önceki denklemden devam edilecek olursa, \displaystyle {Y_{t - 1}} ifadeleri ortak paranteze alınabilir.

\displaystyle \Delta {Y_t} = \left( {\rho  - 1} \right){Y_{t - 1}} + {\varepsilon _t}

\displaystyle \rho  - 1’in \displaystyle \delta  gibi bir ifadeye eşit olduğu varsayılacak olursa modelin son hali aşağıdaki gibi olacaktır.

\displaystyle \Delta {Y_t} = \delta {Y_{t - 1}} + {\varepsilon _t}

Olası birim köklerden kurtarılan yukarıdaki model EKK (OLS) ile tahmin edilip \displaystyle \delta  katsayısı için t istatistiği hesaplanır. \displaystyle {Y_t}’nin birim kökü yok iken tahmin edilen \displaystyle \hat \delta  katsayısı t dağılımına uyar.  Ancak \displaystyle {Y_t}’nin birim kökü var iken tahmin edilen \displaystyle \hat \delta  katsayısı geniş örneklemde bile t dağılımına uymaz. Serinin birim kökünün olup olmadığı bilinmediği için kritik değer olarak t istatistiği yerine tau     (\displaystyle \tau  ) istatistiği kullanılır.

Yukarıdaki gerekçeler nedeniyle \displaystyle \rho  ’nun 1’e eşitliği \displaystyle \delta  ’nın 0’a eşitliği üzerinden sınanacak olup hipotez testi aşağıdaki gibi kurulur.
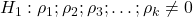
\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezi temsil eden \displaystyle {H_0} \displaystyle \delta  ’nın 0’ a, yani \displaystyle \rho  ’nun 1’e eşit olduğunu; alternatif hipotezi temsil eden \displaystyle {H_1} ise \displaystyle \delta  ’nın 0’ a, yani \displaystyle \rho  ’nun 1’e eşit olmadığını ifade eder.

\displaystyle t > {\tau _{n,\alpha }} ise boş hipotez reddedilir.

\displaystyle t < {\tau _{n,\alpha }} boş hipotez kabul edilir.

n gözlem sayısını, t hesaplanan t istatistiğini, \displaystyle {\tau _{n,\alpha }} ise n serbestlik derecesi ve\displaystyle \alpha  anlamlılık düzeyinde tau tablo değerini temsil etmektedir.

Boş hipotezin kabulü \displaystyle \delta  = 0 olduğunu işaret eder. Dolayısıyla \displaystyle \delta  = 1 - \rho  olduğundan serinin birim kökünün bulunduğu (\displaystyle \rho  = 1) anlamına gelir.

Boş hipotezin reddi \displaystyle \delta  \ne 0 olduğunu işaret eder. Dolayısıyla \displaystyle \delta  = 1 - \rho  olduğundan serinin birim kökünün bulunmadığı   (\displaystyle \rho  \ne 1) anlamına gelir.

Aşağıdaki üç model için Dickey-Fuller testi ile birim kökün varlığı araştırılır.

\displaystyle \Delta {Y_t} = \delta {Y_{t - 1}} + {\varepsilon _t}

\displaystyle \Delta {Y_t} = \beta  + \delta {Y_{t - 1}} + {\varepsilon _t}

\displaystyle \Delta {Y_t} = \beta  + \alpha T + \delta {Y_{t - 1}} + {\varepsilon _t}

Ancak Dickey-Fuller testi ile birim kökü araştırabilmek için hata terimleri \displaystyle {\varepsilon _t}’ler problemsiz hata (white noise) özelliğinde olmalıdır. Bu yüzden hata terimlerinin olası otokorelasyon sorununu yok etmek amacıyla yukarıdaki üç modele de \displaystyle {Y_t}’nin birinci farklarının gecikmeleri eklenir.
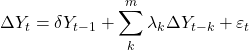
\displaystyle \Delta {Y_t} = \delta {Y_{t - 1}} + \sum\limits_k^m {{\lambda _k}\Delta {Y_{t - k}}}  + {\varepsilon _t}

\displaystyle \Delta {Y_t} = \beta  + \delta {Y_{t - 1}} + \sum\limits_k^m {{\lambda _k}\Delta {Y_{t - k}}}  + {\varepsilon _t}

\displaystyle \Delta {Y_t} = \beta  + \alpha T + \delta {Y_{t - 1}} + \sum\limits_k^m {{\lambda _k}\Delta {Y_{t - k}}}  + {\varepsilon _t}

m maksimum gecikme uzunluğunu ve k gecikme uzunluğunu temsil etmektedir. Söz gelimi m=2 iken ilk model aşağıdaki gibi olacaktır.

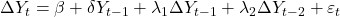
\displaystyle \Delta {Y_t} = \delta {Y_{t - 1}} + {\lambda _1}\Delta {Y_{t - 1}} + {\lambda _2}\Delta {Y_{t - 2}} + {\varepsilon _t}

\displaystyle \Delta {Y_t} = \beta  + \delta {Y_{t - 1}} + {\lambda _1}\Delta {Y_{t - 1}} + {\lambda _2}\Delta {Y_{t - 2}} + {\varepsilon _t}

\displaystyle \Delta {Y_t} = \beta  + \alpha T + \delta {Y_{t - 1}} + {\lambda _1}\Delta {Y_{t - 1}} + {\lambda _2}\Delta {Y_{t - 2}} + {\varepsilon _t}

m gecikme uzunluğu ampirik olarak belirlenir. Söz gelimi m=2 iken hata terimlerinde otokorelasyon sorunu devam ediyorsa m=3 iken otokorelasyon sorununun giderilip giderilmediği araştırılır. Süreç hata terimleri için otokorelasyon sorunu giderilinceye kadar devam ettirilir.

\displaystyle {Y_t}’nin birinci farklarının gecikmelerinin eklendiği modellerde Dickey-Fuller testi ile birim kökün aranması “genişletilmiş Dickey-Fuller testi” (the augmented Dickey-Fuller test, ADF) olarak bilinir.

Dickey-Fuller test prosedürü aşağıdaki aşamalardan oluşur.

Aşama-1:

Aşağıdaki sabit ve trend içeren rassal yürüyüş modeli EKK ile tahmin edilir ve \displaystyle \delta  katsayısının 0’a eşitliği DF kritik tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.

\displaystyle \Delta {Y_t} = \hat \beta  + \hat \alpha T + \hat \delta {Y_{t - 1}} + \sum\limits_k^m {{{\hat \lambda }_k}\Delta {Y_{t - k}}}  + {\hat \varepsilon _t}

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda serinin birim kökünün olmadığı söylenir ve prosedür sonlandırılır. Boş hipotezin kabul edilmesi durumunda ise Aşama-2’ye geçilir.

Aşama-2:

Aşama-1’de EKK ile tahmin edilen modelin \displaystyle \alpha  ve \displaystyle \delta  katsayılarının birlikte 0’a eşitliği DF kritik tablo değerinin F istatistiği ile karşılaştırılması suretiyle test edilir.
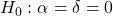
\displaystyle {H_0}:\alpha  = \delta  = 0

\displaystyle {H_1}:\alpha ;\delta  \ne 0

Boş hipotezin reddedilmesi durumunda Aşama-3’e, kabul edilmesi durumunda Aşama-4’e geçilir.

Aşama-3:

Aşama-1’de EKK ile tahmin edilen modelin \displaystyle \delta  katsayısının 0’a eşitliği t tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda serinin birim kökünün olmadığı söylenir ve prosedür sonlandırılır. Boş hipotezin kabul edilmesi durumunda ise serinin birim kökünün olduğu söylenir ve prosedür sonlandırılır.

Aşama-4:

Aşama-1’de yer alan modelden trend çıkarılır ve elde edilen sabit içeren rassal yürüyüş modeli EKK ile tahmin edilip \displaystyle \delta  katsayısının 0’a eşitliği DF kritik tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.
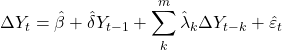
\displaystyle \Delta {Y_t} = \hat \beta  + \hat \delta {Y_{t - 1}} + \sum\limits_k^m {{{\hat \lambda }_k}\Delta {Y_{t - k}}}  + {\hat \varepsilon _t}

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda serinin birim kökünün olmadığı söylenir ve prosedür sonlandırılır. Boş hipotezin kabul edilmesi durumunda ise Aşama-5’e geçilir.

Aşama-5:

Aşama-4’te EKK ile tahmin edilen modelin \displaystyle \beta  ve \displaystyle \delta  katsayılarının birlikte 0’a eşitliği DF kritik tablo değerinin F istatistiği ile karşılaştırılması suretiyle test edilir.
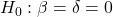
\displaystyle {H_0}:\beta  = \delta  = 0

\displaystyle {H_1}:\beta ;\delta  \ne 0

Boş hipotezin reddedilmesi durumunda Aşama-6’ya, kabul edilmesi durumunda Aşama-7’ye geçilir.

Aşama-6:

Aşama-4’te EKK ile tahmin edilen modelin \displaystyle \delta  katsayısının 0’a eşitliği t tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda serinin birim kökünün olmadığı söylenir ve prosedür sonlandırılır. Boş hipotezin kabul edilmesi durumunda ise serinin birim kökünün olduğu söylenir ve prosedür sonlandırılır.

Aşama-7:

Aşama-4’te yer alan modelden sabit çıkarılır ve elde edilen sabit içermeyen rassal yürüyüş modeli EKK ile tahmin edilip \displaystyle \delta  katsayısının 0’a eşitliği DF kritik tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.

\displaystyle \Delta {Y_t} = \hat \delta {Y_{t - 1}} + \sum\limits_k^m {{{\hat \lambda }_k}\Delta {Y_{t - k}}}  + {\hat \varepsilon _t}

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda serinin birim kökünün olmadığı söylenir ve prosedür sonlandırılır. Boş hipotezin kabul edilmesi durumunda ise serinin birim kökünün olduğu söylenir ve prosedür sonlandırılır.

Yukarıdaki yöntemden farklı olarak, DF veya ADF testi için gecikmelerin eklendiği ya da eklenmediği modellerden hangisinin test istatistiğinde kullanılacağı Akaike (AIC, Akaike Information Criterion), Scwarz (SIC, Scwarz Information Criterion) ya da Hannan-Quinn (HQ, Hannan-Quinn Information Criterion) bilgi kriterlerinden herhangi biri yardımıyla da belirlenebilir.

n gözlem sayısını, \displaystyle \pi  pi sayısını, ln doğal logaritmayı, RSS hata kareleri toplamını ve l logaritmik maksimum olabilirlik fonksiyonunu (the log-likelihood function) temsil etmek üzere l aşağıdaki gibi hesaplanır.
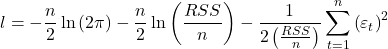
\displaystyle l =  - \frac{n}{2}\ln \left( {2\pi } \right) - \frac{n}{2}\ln \left( {\frac{{RSS}}{n}} \right) - \frac{1}{{2\left( {\frac{{RSS}}{n}} \right)}}\sum\limits_{t = 1}^n {{{\left( {{\varepsilon _t}} \right)}^2}}

\displaystyle l =  - \frac{n}{2}\ln \left( {2\pi } \right) - \frac{n}{2}\ln \left( {\frac{{RSS}}{n}} \right) - \frac{1}{{2\left( {\frac{{RSS}}{n}} \right)}}RSS

\displaystyle l =  - \frac{n}{2}\ln \left( {2\pi } \right) - \frac{n}{2}\ln \left( {\frac{{RSS}}{n}} \right) - \frac{n}{2}

\displaystyle l = \left( { - \frac{n}{2}} \right)\left( {\ln \left( {2\pi } \right) + \ln \left( {\frac{{RSS}}{n}} \right) + 1} \right)

K modelde bulunan parametre sayısını temsil etmek üzere AIC, SIC ve HQ l yardımıyla aşağıdaki gibi hesaplanır.
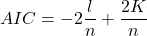
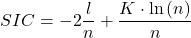
\displaystyle AIC =  - 2\frac{l}{n} + \frac{{2K}}{n}

\displaystyle SIC =  - 2\frac{l}{n} + \frac{{K \cdot \ln \left( n \right)}}{n}

\displaystyle HQ =  - 2\frac{l}{n} + \frac{{2K \cdot \ln \left( {\ln \left( n \right)} \right)}}{n}

Her alternatif model için hesaplanan AIC değerlerinden en küçük AIC değerine sahip model seçilir. SIC ve HQ için model seçme aşaması AIC’de olduğu gibidir. AIC büyük örneklemde etkin iken SIC küçük örneklemde daha güvenilir sonuçlar verir.

Yukarıdaki testler sonucunda serinin durağan olduğu kabul edilirse serinin 0. dereceden I(0) (Integrated(0)) durağan olduğu söylenir.

4.  Eşbütünleşme

Eğer \displaystyle {Y_t} serisi durağan değilse, diğer bir ifadeyle 0. dereceden I(0) durağan değilse \displaystyle {Y_t}’yi açıklayan esas modelin açıklayıcı değişkeni (ya da değişkenleri) (\displaystyle {X_t}) de aynı dereceden durağan olmayabilir. \displaystyle {Y_t} ile birlikte \displaystyle {X_t}’nin de aynı dereceden durağan olmaması aralarında “eşbütünleşme” (cointegration) olduğu anlamına gelir.

\displaystyle {Y_t} = {\beta _0} + {\beta _1}{X_t} + {\varepsilon _t}

\displaystyle {Y_t} açıklanan, \displaystyle {X_t} açıklayıcı, \displaystyle {\beta _0} sabit, \displaystyle {\beta _1} eğim katsayısı ve \displaystyle {\varepsilon _t} problemsiz (white noise) hata terimi olmak üzere yukarıdaki gibi bir esas model olsun. Modelde \displaystyle {\varepsilon _t} hata terimleri yalnız bırakılır.

\displaystyle {\varepsilon _t} = {Y_t} - {\beta _0} - {\beta _1}{X_t}

Basitçe ifade etmek gerekirse hata terimleri \displaystyle {\varepsilon _t} 0. dereceden durağan ise \displaystyle {Y_t} ve \displaystyle {X_t} serileri arasında eş bütünleşme olduğu söylenir. Eş bütünleşmenin varlığı, serilerin bireysel olarak 0. dereceden durağan olmadıkları halde birlikte deterministik bir trend içerdikleri anlamına gelir ve esas modelin düzmece olmadığını ifade eder.

Hata terimleri \displaystyle {\varepsilon _t} gözlemlenebilen bir seri olmadığından esas modelin EKK ile tahmini ile nicel değerleri elde edilebilir.

\displaystyle {Y_t} = {\hat \beta _0} + {\hat \beta _1}{X_t} + {\hat \varepsilon _t}

Tahmin edilen \displaystyle {\hat \varepsilon _t} hata terimleri için DF birim kök sınaması yapılacak yardımcı model, sabit içermeyen rassal yürüyüş modeline benzer şekilde aşağıdaki gibi elde edilecektir.
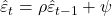
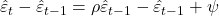
\displaystyle {\hat \varepsilon _t} = \rho {\hat \varepsilon _{t - 1}} + \psi

\displaystyle {\hat \varepsilon _t} - {\hat \varepsilon _{t - 1}} = \rho {\hat \varepsilon _{t - 1}} - {\hat \varepsilon _{t - 1}} + \psi

\displaystyle \Delta {\hat \varepsilon _t} = \left( {\rho  - 1} \right){\hat \varepsilon _{t - 1}} + \psi

\displaystyle \Delta {\hat \varepsilon _t} = \delta {\hat \varepsilon _{t - 1}} + \psi

\displaystyle \psi  ifadesi yardımcı modelin hata terimini ifade eder. Yukarıdaki yardımcı model EKK ile tahmin edilir ve \displaystyle \delta  katsayısının 0’a eşitliği DF kritik tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.
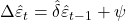
\displaystyle \Delta {\hat \varepsilon _t} = \hat \delta {\hat \varepsilon _{t - 1}} + \psi

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda esas modelin hata terimlerini temsil eden \displaystyle {\varepsilon _t}’lerin birim kökünün olmadığı, diğer bir ifadeyle \displaystyle {Y_t} ve \displaystyle {X_t} serileri arasında eş bütünleşme olduğu söylenir. Boş hipotezin kabul edilmesi durumunda ise esas modelin hata terimlerini temsil eden \displaystyle {\varepsilon _t}’lerin birim kökünün olduğu, diğer bir ifadeyle \displaystyle {Y_t} ve \displaystyle {X_t} serileri arasında eş bütünleşme olmadığı söylenir.

Yukarıdaki işlemlerin sonunda \displaystyle {Y_t} serisinin durağan olmadığı ve \displaystyle {Y_t} ile \displaystyle {X_t} serilerinin aralarında eş bütünleşme olmadığı sonucuna varılırsa aşağıdaki gibi \displaystyle {Y_t}’nin farkları alınarak \displaystyle {Y_t} serisinin durağanlık derecesi bulunur.

Durağan olmayan serinin sadece sabit içermeyen rassal yürüyüş modeli için ikinci farkları alınarak tekrar durağanlık testi yapılır.

\displaystyle \Delta {Y_t} = \delta {Y_{t - 1}} + {\varepsilon _t}

\displaystyle {\Delta ^2}{Y_t} = \delta \Delta {Y_{t - 1}} + {\varepsilon _t}

\displaystyle {\Delta ^2}{Y_t} = \Delta {Y_t} - \Delta {Y_{t - 1}} ve \displaystyle \Delta {Y_t} = {Y_t} - {Y_{t - 1}} olmak üzere serinin 2. ve 1. farklarını temsil eder. Modele gecikme eklemeye gerek yoktur. Yukarıdaki sabit içermeyen rassal yürüyüş modeli EKK ile tahmin edilir ve \displaystyle \delta  katsayısının 0’a eşitliği DF kritik tablo değerinin t istatistiği ile karşılaştırılması suretiyle test edilir.

\displaystyle {\Delta ^2}{Y_t} = \hat \delta \Delta {Y_{t - 1}} + {\hat \varepsilon _t}

\displaystyle {H_0}:\delta  = 0

\displaystyle {H_1}:\delta  \ne 0

Boş hipotezin reddedilmesi durumunda serinin 1. farklarının birim kökünün olmadığı, diğer bir ifadeyle \displaystyle {Y_t} serisinin 1. dereceden I(1) durağan olduğu söylenir. Boş hipotezin kabul edilmesi durumunda ise serinin 1. farklarının da birim kökünün olduğu söylenir. Böylece serinin üçüncü farkları alınarak 2. dereceden durağanlığı yukarıdaki gibi test edilir. Durağanlık elde edilinceye kadar süreç benzer şekilde devam ettirilir.


İshak Kutlu, Ekonometri Notları

Yorum Yap

İshak Kutlu

Veri & Otomasyon Uzmanı

Kurumsal iş akışlarını düzenleyen veri odaklı otomasyon sistemleri ve makine öğrenmesi tabanlı çözümler geliştirir. Gerçek operasyonel süreçler için ölçeklenebilir ve izlenebilir yapılar tasarlar.

YouTube   YouTube   YouTube   YouTube