Bu makalede çok değişkenli (multiple) doğrusal regresyon modeli yardımıyla python ile makine öğenmesi algoritması üzerinde durulacaktır. Basitleştirici varsayım olarak kurulan modelin/verilerin klasik doğrusal regresyon modelinin tüm varsayımlarını sağladığı kabul edilmiştir. Makalede çok değişkenli doğrusal regresyon modelinin bilimsel temelleri matris cebiri kullanılarak kısaca tanıtılacaktır. Sonrasında çok değişkenli temsili bir model üzerinden python ile makine öğrenmesi uygulaması yapılacaktır.
Not 1: Bu makaledeki uygulamalar Python 3.9 sürümünde, Anaconda Navigator üzerinden Spyder IDE’si kullanılarak yapılmıştır.
Not 2: Bu makalede kullanılan modellerin matematiksel ispatları üzerinde durulmayacaktır. Modellerin daha detaylı matematiksel ispatları için EKONOMETRİ bölümünü ziyaret edebilirsiniz.
1. Giriş ve Örnek Veri Seti
Yıllık deneyime ve yaşa göre ödenen ücretlerden oluşan aşağıdaki gibi bir veri setimiz olsun. Veri setimizde test setine ilişkin süreç bir önceki makalede belirtilen yöntemlerle aynı olduğu için test setine yer verilmedi.
| Eğitim Seti | ||
| Deneyim | Ücret | Yaş |
| 1.1 | 39343.00 | 25 |
| 1.3 | 46205.00 | 27 |
| 2.0 | 43525.00 | 23 |
| 2.2 | 39891.00 | 25 |
| 2.9 | 56642.00 | 32 |
| 3.0 | 60150.00 | 38 |
| 3.2 | 54445.00 | 27 |
| 3.2 | 64445.00 | 41 |
| 3.9 | 63218.00 | 37 |
| 4.0 | 55794.00 | 35 |
| 4.0 | 56957.00 | 38 |
| 4.1 | 57081.00 | 45 |
| 4.5 | 61111.00 | 28 |
| 4.9 | 67938.00 | 36 |
| 5.3 | 83088.00 | 39 |
| 5.9 | 81363.00 | 45 |
| 6.0 | 93940.00 | 43 |
| 6.8 | 91738.00 | 46 |
| 7.1 | 98273.00 | 50 |
| 8.2 | 113812.00 | 43 |
| 8.7 | 109431.00 | 38 |
| 9.0 | 105582.00 | 47 |
| 9.5 | 116969.00 | 43 |
| 9.6 | 112635.00 | 52 |
| 10.5 | 121872.00 | 49 |
Modelimizi yukarıdaki eğitim seti ile eğiteceğiz. Takip eden bölümlerde makine öğrenmesinde yararlanılacak olan çoklu doğrusal regresyonun matris cebiri ile kuramsal yönü ele alınacaktır. Son bölümde ise kuramsal çerçevede ele alınan konular, yukarıdaki veri seti kullanılarak python ile makine öğrenmesi algoritmasına dönüştürülecektir.
2. Matris Yöntemiyle Parametrelerin Elde Edilmesi
Yıllık deneyimin ve yaşın ücretler üzerindeki etkisini araştırmak istediğimizi, yani modelimizi yukarıdaki eğitim seti ile eğiteceğimizi varsayalım. Eğitimde kullanacağımız modelimiz şu şekilde olacaktır.
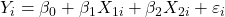
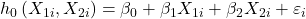
Yukarıdaki modelde  açıklanan/bağımlı değişken,
 ve
 açıklayıcı/bağımsız değişkenlri ve
 ifadesi ise hata terimleridir. Y, X ve
 ifadelerinde yer alan “i” harfleri bir önceki makalede de belirtildiği üzere gözlem sırasını temsil etmektedir. Ancak ikiden daha fazla k-1 adet açıklayıcı değişkenin olduğu bir modelde toplam sembolü gibi metotlarla işlem yapmak mümkün olmaz. Bu durumda da matris cebiri kullanılır. Aşağıdaki gibi k-1 adet açıklayıcı değişkenden (sabit terim ile birlikte k adet parametreden oluşan) bir genel doğrusal model olsun.
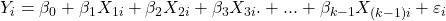
Yukarıdaki modelde “i” gözlem sırasını, k modelde bulunan parametre sayısını ve “n” gözlem sayısını temsil etmektedir. Modelde bir sabit olduğu ve sabit de  ile ifade edildiği ve modelde k adet parametre olduğu varsayıldığı için son parametre
 yerine
 ile ifade edilmiştir. Modelde bulunan sabit yerine
 ile ifade edilseydi, modelde k adet parametre olduğu varsayıldığı için son parametre yerine ile ifade edilirdi. Yukarıdaki modelin matris formunda ifade edilebilmesi için model 1’den “n” gözlem sayısına kadar genişletilir.
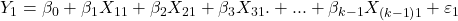
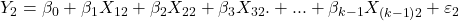
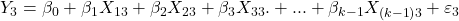

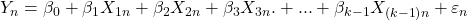
Yukarıdaki denklem sistemi aşağıdaki şekilde matris formunda ifade edilir.
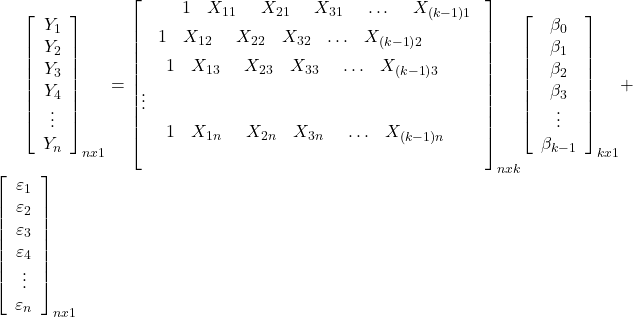
 ,
 ,
 ve ifadeleri birer matrisi temsil etmek üzere, yukarıdaki denklem sistemi aşağıdaki şekilde ifade edilir.

Yukarıdaki modelde hata terimlerini temsil eden matrisi yalnız bırakılır.

Matris cebirinde eşitliğin her iki tarafının da karesinin alınması için ( matrisinin nx1 boyutlarında bir sütun vektörü olduğu varsayımı altında), her iki taraf da soldan kendi transpozu (devriği, trasnpose) ile çarpılır.
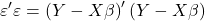
Yukarıdaki denklem sistemi, transpozunun alınması sonrası aşağıdaki şekilde düzenlenir.

Eşitliğin sağında yer alan ifade açılır.
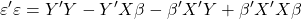
Yukarıdaki denklem sisteminde  ifadesi ile
 ifadesi birbirine eşittir. Bu iki ifadenin toplamı
 olarak ifade edilebileceği gibi
 olarak da ifade edilebilir.
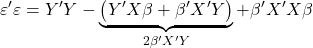

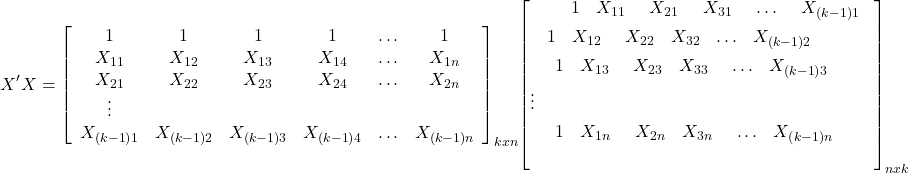
Yukarıdaki denklem sisteminde yer alan  ifadesi içindeki
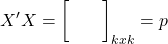
 ifadesinin sonucu, kxk boyutlarında bir kare matris olduğu için bir determinanta sahiptir. Ayrıca X değişkenlerinin gözlemlenebilen sayısal değerleri olduğundan ifadesi p gibi bir sabite eşit olacaktır.
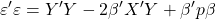
Yukarıdaki denklem sistemi aşağıdaki gibi tekrar düzenlenir.
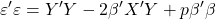
Yukarıdaki denklem sisteminde hata terimlerinin karelerinin toplamı elde edilmişti. Hata terimlerinin karelerinin toplamını minimize etmek için parametrelerine göre ayrı ayrı kısmi türev alınarak 0’a (sıfıra) eşitlenir.

Yukarıdaki denklem sistemi aşağıdaki şekilde düzenlenir.


 olduğundan yukarıdaki denklem sistemde yerine yazılır.
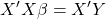
parametrelerinin tahmin edicisi sütun vektörünü elde etmek amacıyla, matrisinin yalnız bırakılması gerekir. Bu amaçla yukarıdaki denklem sisteminin her iki tarafı da soldan, ifadesinin tersini temsil eden  ifadesi ile çarpılır.

Bir matrisi, kendi tersi ile çarpmak birim matrisi verdiğinden ve birim matrisin determinantı da 1 olduğundan, 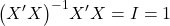 yoluyla sütun vektörü yalnız bırakılmış olur.

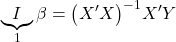
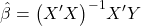
Yukarıdaki parametre tahmin edicisini temsil eden  sütun vektörü satır vektörü olarak aşağıdaki şekilde de elde edilebilir.
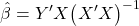
3. Python ile Makine Öğrenmesi: Çoklu Doğrusal Regresyon
Aşağıdaki kodlarda bir satırın solunda yer “#” işareti o satırın derleyici tarafından okunmadığını ifade eder. Benzer şekilde ‘’’ ile ‘’’ işaretleri arasında yer alan satır veya satırlar da derleyici tarafından okunmaz. Bu işaretler yardımıyla kodların için açıklama/yorum eklenebilmektedir veya bir kod satırı veya bloğunun kolaylıkla kapatılıp açılması mümkün olmaktadır.
Aşağıdaki python algoritmasında verilerin xlsx uzantılı bir Excel dosyadan okunması, verilerin dönüştürülmesi, verilere ols/ekk uygulanması (verilerin regresyon tahminin yapılması), R2 ve düzeltilmiş (adjusted) R2 istatistiğinin hesaplanması ve parametrelerin elde edilmesi yer almaktadır. İlave olarak sayısal değerlerin arraylerin içinden çıkarılması ve eğitim seti dışında rassal 2 farklı veri ile modele basit bir tahmin yaptırılmıştır.
# -*- coding: utf-8 -*-
"""
Created on Sat Jun 18 17:09:56 2022

@author: ishakkutlu
"""

#%%
import pandas as pd
from sklearn.linear_model import LinearRegression

#"C:\\" şeklinde çift yan çizgiye DİKKAT ediniz lütfen! Csv dosyamızın bulunduğu dizini tanımlıyoruz.
myTrainingFile = "C:\\Users\...\Salary_Data_Multiple_Reg.xlsx"
myLabelx1 ="YearsExperience"
myLabelx2 ="Age"
myLabely ="Salary"
# Sadece yukarıdaki değişkenleri uyarlamanız yeterli olacaktır.
# Veri setinizi eğitmek için kodlarda başka herhangi bir değişiklik yapmanıza gerek yoktur.
# Modelin Y=b0+b1X1+b2X2+e olduğu varsayılmıştır.

df = pd.read_excel(myTrainingFile) # Excel'den pythona veri aktarımı
#df = pd.read_csv(myTrainingFile, sep = ",") # Eğer csv dosyasından veri aktarılacaksa, bu satır kullanılır.

X = df[[myLabelx1, myLabelx2]]
y = df[myLabely]

# %%
#Predict
multiple_reg = LinearRegression(fit_intercept=True) # Modelde sabit terim olacak. Y=b0+b1X1+b2X2+e
#multiple_reg = LinearRegression(fit_intercept=False) # Modelde sabit terim olmayacak. Y=b1X1+b2X2+e
multiple_reg.fit(X.values, y)
#multiple_reg.fit(X, y) # Bu satırla fit edildiğinde aşağıdaki TahminTest sürecinde verilerin başlığının olmasını bekliyor ve uyarı (hata değil) veriyor.

b0 = multiple_reg.intercept_
print("b0: ", b0 )
print("b1,b2: ", "\n", multiple_reg.coef_) # parametrelerin arrayin içinde
print("b1,b2: ", "\n", multiple_reg.coef_[0], "\n", multiple_reg.coef_[1]) # parametrelerin arrayin içinden çıkarıldı ve alt satıra yazdırıldı.

# predict
TahminTest = multiple_reg.predict([[10,35],[5,35]])
print("Array şeklindeki sonuç: ", TahminTest)
print ("10 yıllık deneyime sahip 35 yaşındaki kişinin ücreti: ", TahminTest[0]) #ilk sıradaki değer arrayin içinden çıkarıldı
print ("5 yıllık deneyime sahip 35 yaşındaki kişinin ücreti: ", TahminTest[1]) #İkinci sıradaki değer arrayin içinden çıkarıldı


# %%
# R^2
r2 = multiple_reg.score(X.values, y) #Eğer isimlendirme ilgili bir uyarı verirse değişkenin sağına, yandaki gibi ".values" ifadesini ekleyiniz.
print('R^2 score: ',r2)
# Adjusted R-squared
adj_r2 = 1 - (1-r2)*(len(y)-1)/(len(y)-(X.shape[1]+1)) # adjR2 hesaplanmasında sabit terimin dahil edildiği yöntem kullanıldı. Yani toplam 3 parametre olmalı.
print('Adjusted R^2 score: ',adj_r2)
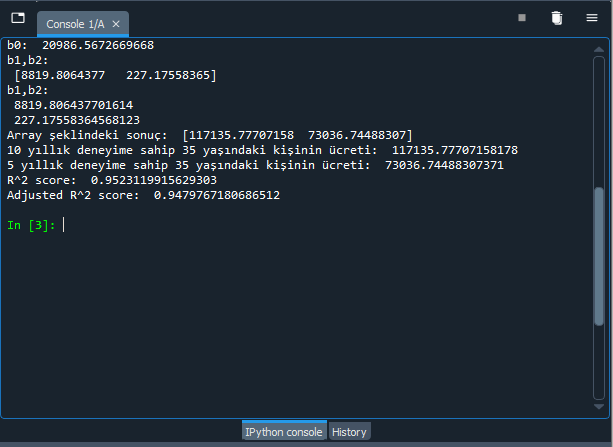
Makalenin girişinde sunulan veri setine göre yukarıdaki algoritmanın sonuçları şu şekilde olmalıdır.