Bu makalede basit doğrusal regresyon modeli yardımıyla python ile makine öğenmesi algoritması üzerinde durulacaktır. Basitleştirici varsayım olarak kurulan modelin/verilerin klasik doğrusal regresyon modelinin tüm varsayımlarını sağladığı kabul edilmiştir. Makalede basit doğrusal regresyon modelinin bilimsel temelleri kısaca tanıtılacaktır. Sonrasında basit bir model üzerinden python ile makine öğrenmesi uygulaması yapılacaktır.
Not 1: Bu makaledeki uygulamalar Python 3.9 sürümünde, Anaconda Navigator üzerinden Spyder IDE’si kullanılarak yapılmıştır.
Not 2: Bu makalede kullanılan modellerin matematiksel ispatları üzerinde durulmayacaktır. Modellerin daha detaylı matematiksel ispatları için EKONOMETRİ bölümünü ziyaret edebilirsiniz.
1. Giriş ve Örnek Veri Seti
Yıllık deneyime göre ödenen ücretlerden oluşan aşağıdaki gibi bir veri setimiz olsun. Veri setimizi eğitim seti ve test seti olarak aşağıdaki gibi iki bölüme ayırıyoruz.
| Eğitim Seti | |
| Deneyim | Ücret |
| 1.1 | 39343.00 |
| 1.3 | 46205.00 |
| 2.0 | 43525.00 |
| 2.2 | 39891.00 |
| 2.9 | 56642.00 |
| 3.0 | 60150.00 |
| 3.2 | 54445.00 |
| 3.2 | 64445.00 |
| 3.9 | 63218.00 |
| 4.0 | 55794.00 |
| 4.0 | 56957.00 |
| 4.1 | 57081.00 |
| 4.5 | 61111.00 |
| 4.9 | 67938.00 |
| 5.3 | 83088.00 |
| 5.9 | 81363.00 |
| 6.0 | 93940.00 |
| 6.8 | 91738.00 |
| 7.1 | 98273.00 |
| 8.2 | 113812.00 |
| 8.7 | 109431.00 |
| 9.0 | 105582.00 |
| 9.5 | 116969.00 |
| 9.6 | 112635.00 |
| 10.5 | 121872.00 |
Modelimizi yukarıdaki eğitim seti ile eğitip aşağıdaki test seti ile de ne kadar başarılı olduğunu test edeceğiz.
| Test Seti | |
| Deneyim | Ücret |
| 1.5 | 37731.00 |
| 3.7 | 57189.00 |
| 5.1 | 66029.00 |
| 7.9 | 101302.00 |
| 10.3 | 122391.00 |
Takip eden bölümlerde makine öğrenmesinde yararlanılacak olan basit doğrusal regresyonun (yukarıdaki veri seti esas alınarak) kuramsal yönü ele alınacaktır. Son bölümde ise kuramsal çerçevede ele alınan konular, python ile makine öğrenmesi algoritmasına dönüştürülecektir.
2. Parametrelerin Elde Edilmesi
Yıllık deneyimin ücretler üzerindeki etkisini araştırmak istediğimizi, yani modelimizi yukarıdaki eğitim seti ile eğiteceğimizi varsayalım. Eğitimde kullanacağımız modelimiz şu şekilde olacaktır.
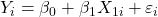
Makine öğrenmesi literatüründe  ifadesinin yerine aşağıdaki ifadeyle de karşılaşılabilir. Bu sadece bir notasyon farklılığıdır. Kurulan modelin başlangıçta bir hipotez olduğu vurgulanmış olur. Aşağıda modelin neden hipotez olduğu açıklanacaktır.

Yukarıdaki modelde açıklanan/bağımlı değişken,  açıklayıcı/bağımsız değişken ve
 ifadesi ise hata terimleridir. Y, X ve
 ifadelerinde yer alan “i” harfleri gözlem sırasını temsil etmektedir. Hata terimlerinin doğrudan gözlemlenebilen değerleri olmamakla birlikte (birazdan açıklanacak olan) tahmin edilen değerleri kullanılır.
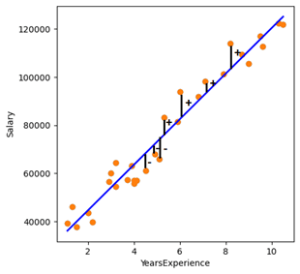
değişkeni yıllık deneyim belirli bir değeri aldığında mümkün olan en az hata/fark ile değişkeni olan ücretin değerini tahmin etmek istiyoruz. Python ile scatter şeklinde aşağıdaki gibi görselleştirdiğimiz veri setini incelediğimizde, amacımızın aşağıdaki veri setine en iyi uyumu gösteren (onu en iyi “fit” edilebilen) bir doğruyu elde etmek olduğunu söyleyebiliriz.
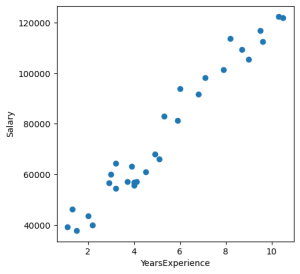
Veri setine en iyi uyumu gösteren (en iyi “fit” edilebilen) bir doğruyu elde etmenin diğer bir ifadesi ise ifadelerinin gerçek değerleri ile fit edilen doğru üzerindeki noktalar arasındaki her bir farkın minimum olmasıdır.
ifadelerinin gerçek değerleri ile fit edilen doğru üzerindeki noktalar arasındaki her bir farkın minimum olması, hata teriminin varyansının minimum olması gerektiğini ifade eder. Gözlem değerlerinin her birinin kusursuz bir şekilde doğru üzerinde yer aldığını ve 5 adet hayali gözlemimiz olduğunu varsayalım. Hata terimlerinin ortalamasının (veya toplamının) daima sıfıra eşit olduğu bilgisi de göz önünde bulundurulursa, hayali serimizin hata terimlerinin varyansı veya kareleri toplamı da (her bir gözlem değerinin doğru üzerinde mükemmel bir şekilde yer aldığı gerçek dışı varsayımımız gereği) sıfır olur. Aşağıdaki varyans denkleminde hayali serimizin hata değerlerini yerini yazarsak, varyansı da 0 olacaktır.
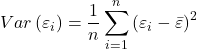

Not: Hata teriminin varyansı elde edilirken kullanılan tahmin ediciye göre paydası, gözlem sayısı n veya n’den farklı bir değer olabilir. Burada basitçe paydanın n’e eşit olduğu kabul edilmiştir.
Ancak gerçekte verilerin doğru üzerinde sıfır hata ile mükemmel bir şekilde konumlanması söz konusu olmaz. Yukarıdaki şekilde gösterildiği gibi gerçek değerler ile doğru üzerinde gerçek değerlerin karşılık geldiği tahmin değerleri arasında pozitif veya negatif farklar vardır. Amaç bu farkların her birinin minimize edilmesidir. Hata değerlerinin toplamı ise daima sıfıra eşit veya ona çok yakındır. Farkların her birinin minimize edilmesi ise hata terimninin varyansının minimize edilmesini ifade eder. O halde hata terimlerinin ortalaması (veya toplamı) daima sıfır olduğundan, hata terimlerinin kareleri toplamı doğrudan varyansının bir ölçüsü olacaktır.
Yukarıdaki modelde hata terimi yalnız bırakılır.

Eşitliğin her iki tarafının da karesi alınarak toplam sembolü ile ifade edilir.


Temel amaç, modelin hata terimlerinin kareleri toplamını minimize etmek yoluyla  katsayılarını tahmin etmek olduğu için yukarıdaki denklem,
 ve
 parametrelerinin bir fonksiyonu olarak ifade edilebilir. Henüz hata terimlerinin değerlerini bilmediğimize/elde etmediğimize dikkat edin. Bu yüzden değerlerini kullanarak parametreler için denklemi çözemeyiz.

Gradyan Azalma (Gradient Descent):
Not: Aşağıdaki işlemler bir gradient descent sürecidir. Makine öğrenmesinde sıklıkla kullanılan bir kavramdır. Sonraki makalelerde gradient descent süreci ayrıca ele alınacaktır. Şimdilik aşağıdaki sürecin bir gradient descent olduğuna ilişkin bir farkındalık yeterlidir.
Yukarıdaki denklemin üç boyutlu görünümü aşağıdaki şekilde gösterildiği gibidir. Şekilde yer alan “cost” ifadesi hata terimini, yani modelin hata maliyetini (hata teriminin varyansını) temsil etmektedir. Her ve değerine karşılık gelen bir hata varyansı vardır. Amaç “cost”u yani hata teriminin varyansını minimum yapan ve parametrelerini elde etmektir.
Örneğin A noktası parametresinin rassal bir değerini temsil ettiğini varsayarsak, hata teriminin varyansını minimum yapan global minimum (B) noktasına karşılık gelen değerini arıyoruz. Şekilde tek bir lokal mimimum olduğu için lokal mimimum (B noktası) aynı zamanda da global minimumdur. Aynı açıklamalar parametresi için de geçerlidir.
Makalenin başlangıcında bahsedilen modelin bağımlı değişkeni ifadesi yerine,  ifadesinin kullanıldığı form aşağıdaki gibiydi.

Örneğin parametresine A noktasındaki bir değeri verdiğimizi düşünelim. Sonrasında parametresine A noktasının hemen altında daha küçük bir değer verdiğimizi düşünelim ve başlangıçtaki hata değeri ile ilk adımdaki hata değerini karşılaştıralım. Eğer ilk adımdaki hata değeri başlangıçtaki (A noktasındaki) hata değerinden küçükse, ikinci adımda parametresine daha küçük bir değer verdiğimizi düşünelim. Benzer şekilde ikinci adımdaki hata değeri ilk adımdaki hata değerinden küçükse, üçüncü adımda parametresine daha küçük bir değer verdiğimizi düşünelim. n. adımdaki hata değeri (n-1). adımdaki hata değerinden büyükse, (n-1). adımda verilen parametresinin değerinin hata değerini mimimum yaptığı anlamına gelecektir. Bu sebeple makine öğrenmesi literatüründe, sürecin bir deneme-yanılma (öğrenme) hipotezi süreci olduğunun vurgulanması amacıyla, bağımlı değişken ifadesi yerine ifadesi de kullanılabilmektedir. Ancak söz konusu sürecin matematiksel karşılığı, denklemin ve parametrelerine göre kısmi türevlerinin alınarak sıfıra eşitlenmesidir. Bu işlem yukarıdaki modelde hata terimlerinin karelerini toplamının (diğer bir ifadeyle varyansının) minimize edildiği (yukarıdaki şekillerde yer alan minimum noktalara ulaşıldığı) anlamına gelmektedir.
parametresinin tahmin edicisini elde etmek için yukarıdaki ifadenin parametresine göre kısmi türevi alınır.
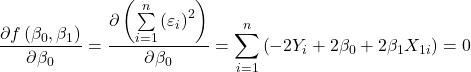

Sonuçlar aşağıdadır.
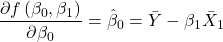

Bir değişkenin üzerinde yer alan düz çizgi o değişkenin aritmetik ortalamasını temsil eder. Örneğin  ifadesi, değişkeninin aritmetik ortalamasıdır;
 . Yukarıdaki sonuçlar, ve parametrelerinin tahmin edilen değerlerini ifade ettiği için
 (beta0 hat) ve
 (beta1 hat) notasyonları ile gösterilmiştir. Bir notasyonun üzerindeki hat (şapka) işareti o ifadenin tahmin değeri olduğunu temsil eder.
Başlangıçtaki modelimiz şu şekildeydi.
Modelin tahmin edilmiş gösterimi ile tahmin edilen modelden elde edilen sonuçlar kısaca şu şekildedir.
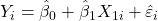


Yukarıdaki ifade (makalenin başlangıcında da bahsedildiği gibi) gözlemlenemeyen hata terimlerinin tahmin edilen değerlerini ifade etmektedir.

Yukarıdaki ifadede , yani deneyim, belirli bir değeri aldığında ücreti  olarak tahmin edecektir.
3. Determinasyon Katsayısı
Modelin genel olarak ne kadar başarılı bir model olduğu, diğer bir ifadeyle modelin genel performansı  (R kare, R square) olarak da bilinen determinasyon katsayısı (the coefficient of determination) ile ölçülür. Determinasyon katsayısı aşağıdaki kavramlardan hareketle elde edilir.
TSS: Toplam kareler toplamı (Total Sum of Squares)
ESS: Açıklanan kareler toplamı (Explained Sum of Squares)
RSS: Açıklanamayan (hataların) kareler toplamı (Residual Sum of Squares)


TSS, tanım gereği ESS ve RSS’nin toplamıdır.

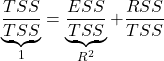

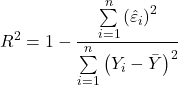
İstatistiğinin Özellikleri:
- Eğer modelde sabit terim (modelimizde
 ile temsil edilen parametre) varsa
 değeri 0 ile 1 aralığında bir değer alır. Eğer modelde sabit terim yoksa değeri 0’dan küçük veya 1’den büyük değerler alabilir.
- değerinin 1’e yakın olması modelin performansının iyi olduğunu, 0’a yakın olması ise modelin performansının kötü olduğunu ifade eder.
- Modelin eğitiminde kullanılan veri sayısı (n) arttıkça değeri artabilir.
- Modele yeni bağımsız/açıklayıcı değişkenler (yani yeni X’ler) ilave edilirse, değeri artabilir veya sabit kalabilir; ama kesinlikle azalmaz. İlave edilen değişkenlerin t-istatistiği 1’den büyükse değeri artar; 1’e eşitse değeri sabit kalır. Bu sebeple istatistiği kullanılarak iki model arasında tercih yapılmak istenildiğinde, her iki modeldeki değişken sayısının aynı olmasına dikkat edilmelidir.
- istatistiğinin düşük çıkması, modelde tanımlama hatası yapılmış olabileceğine işaret eder. Tanımlama hatası modelde yer alması gereken değişkenlerin dışarıda bırakılmasından veya modelin matematiksel formunun yanlış seçilmesinden kaynaklanabilir.
- Zaman serilerinde, açıklayıcı değişkenlerin (X’lerin) ortak trende sahip olması sebebiyle, yatay kesit verilerine göre istatistiği daha yüksek çıkar. Literatürde istatistiğinin zaman serileri için 0,90’dan, yatay kesit verilerinde ise 0,50’den büyük olması tercih edilir.
- Genel doğrusal modelin varsayımları, özellkle de hata terimlerinin varyansının sabit ve kovaryansının sıfır olması gerektiği yönündeki varsayımları sağlanmadığında, istatistiği sapmalı olur ve istatistiğine göre değerlendirme yapmak doğru olmaz. Diğer bir ifadeyle modelde değişen varyans ve/veya otokorelasyon sorunu varsa istatistiği güvenilir sonuçlar vermez.
Literatürde istatistiği yerine, yukarıdaki sorunların bir kısmını telafi edebilen ve  notasyonu ile ifade edilen düzeltilmiş (adjusted) istastiği kullanılır.
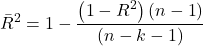
n eğitimde kullanılan veri sayısını (gözlem sayısını), k ise sabit terim hariç modelde bulunan parametre sayısını ifade eder. Düzeltilmiş (adjusted) istastiğinin hesaplanmasında modelde bulunan sabit terim dahil edilmek istenirse, yukarıdaki denklem aşağıdaki şekilde ifade edilir.

Düzeltilmiş ( ) İstatistiğinin Özellikleri:
- Düzeltilmiş istatistiği genellikle istatistiğinden küçüktür.
- Modelde sabit terim (modelimizde ile temsil edilen parametre) varsa, düzeltilmiş istatistiği de 0’dan küçük çıkabilir.
- Modele yeni bağımsız/açıklayıcı değişkenler (yani yeni X’ler) ilave edilirse, düzeltilmiş değeri artabilir, azalabilir veya sabit kalabilir. İlave edilen değişkenlerin t-istatistiği 1’den büyükse düzeltilmiş değeri artar; 1’den küçükse düzeltilmiş azalır ve 1’e eşitse düzeltilmiş değeri sabit kalır.
- İki model arasında kıyaslama yapılacaksa düzeltilmiş istatistiği kullanılır. Ancak düzeltilmiş istatistiği kullanılarak iki model arasında tercih yapılmak istenildiğinde, her iki modeldeki değişken sayısının aynı olmasına dikkat edilmelidir.
- Genel doğrusal modelin varsayımları, özellkle de hata terimlerinin varyansının sabit ve kovaryansının sıfır olması gerektiği yönündeki varsayımları sağlanmadığında, düzeltilmiş istatistiği de sapmalı olur ve düzeltilmiş istatistiğine göre değerlendirme yapmak doğru olmaz. Diğer bir ifadeyle modelde değişen varyans ve/veya otokorelasyon sorunu varsa düzeltilmiş istatistiği de güvenilir sonuçlar vermez.
4. Python ile Makine Öğrenmesi: Basit Doğrusal Regresyon
Aşağıdaki kodlarda bir satırın solunda yer “#” işareti o satırın derleyici tarafından okunmadığını ifade eder. Benzer şekilde ‘’’ ile ‘’’ işaretleri arasında yer alan satır veya satırlar da derleyici tarafından okunmaz. Bu işaretler yardımıyla kodların için açıklama/yorum eklenebilmektedir veya bir kod satırı veya bloğunun kolaylıkla kapatılıp açılması mümkün olmaktadır.
Aşağıdaki python algoritmasında verilerin csv uzantılı bir dosyadan okunması, verilerin dönüştürülmesi ve scatter grafiğinin çizilmesi, verilere ols/ekk uygulanması (verilerin regresyon tahminin yapılması), parametrelerin elde edilmesi ve regresyon doğrusunun çizilmesi süreçleri yer almaktadır. İlave olarak array’lerden değerin scaler olarak çıkarılması ve ondalık hanelerin yuvarlanmasına ilişkin birkaç küçük noktaya da değinilmiştir. Algoritmanın son kısmında ise 15 yıllık deneyime sahip kişinin ücreti tahmin edilmiştir.
# -*- coding: utf-8 -*-
"""
Created on Sat Jun 18 17:09:56 2022

@author: ishakkutlu
"""

#%%
# import library
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# "C:\\" şeklinde çift yan çizgiye DİKKAT ediniz lütfen! Csv dosyamızın bulunduğu dizini tanımlıyoruz.
myTrainingFile = "C:\\Users\...\Salary_Data_Training.csv"
myLabelx ="YearsExperience"
myLabely ="Salary"

# import data (dataya df adını verdik.)
df = pd.read_csv(myTrainingFile, sep = ",") # csv dosyasının seperatorünü belirtiyoruz. Varsayılan olarak "," olur.
#csv dosyasında seperator olarak ";" kullanılıyorsa "," işaretini ";" işareti ile değiştiriniz.

# convert data (regresyon ve grafikler için datayı kolaylıkla işlenebilir olan array formatına dönüştürüyoruz.)
x = np.array(df.loc[:,myLabelx]).reshape(-1,1)
y = np.array(df.loc[:,myLabely]).reshape(-1,1)

# plot data (veriler için scatter grafiğini çiziyoruz.)
plt.scatter(x=x,y=y)
plt.xlabel(myLabelx)
plt.ylabel(myLabely)
plt.show()

#%%
# sklearn library
from sklearn.linear_model import LinearRegression

# linear regression model
reg = LinearRegression(fit_intercept=True) # ols/ekk işlemcisini reg değişkenine ata.

reg.fit(x,y) #denkleme ols/ekk uygula

#%% prediction
b0 = reg.intercept_
print("b0: ",b0)   # doğrunun y eksenini kestiği nokta; intercept/sabit terim.
b1 = reg.coef_
print("b1: ",b1)   # eğim, X_1'in parametresi

#salary_tahmin = bo + b1*X_1
salary_tahmin = b0 + b1*15 # 15 yıllık deneyime sahip birisinin ücretinin ne kadar olacağını tahmin et.
print("15 yıllık deneyime sahip kişinin ücreti: ", salary_tahmin) # Birinci yöntem: 15 yıllık deneyime sahip birisinin ücretinin tahmini
print("15 yıllık deneyime sahip kişinin ücreti: ", reg.predict([[15]])) # İkinci yöntem: 15 yıllık deneyime sahip birisinin ücretinin tahmini

#İki boyutlu arraydan değerin scaler olarak dışarı çıkarılması. İki adet köşeli parantezin olması arrayın iki boyutlu olduğunu ifade eder.
print("15 yıllık deneyime sahip kişinin ücreti: ", salary_tahmin[0,0])
print("15 yıllık deneyime sahip kişinin ücreti: ", reg.predict([[15]])[0,0])
# Değerleri yuvarla
print("15 yıllık deneyime sahip kişinin ücreti: ", round(salary_tahmin[0,0], 2))
print("15 yıllık deneyime sahip kişinin ücreti: ", round(reg.predict([[15]])[0,0], 1))

# visualize line (train edilen X verileri ile regresyon doğrusunun çizimi)
plt.scatter(x,y)
y_tahmin = reg.predict(x)  # salary tahmini.
plt.plot(x, y_tahmin,color = "red")
plt.show()
Makalenin girişinde sunulan veri setine göre yukarıdaki algoritmanın sonuçları şu şekilde olmalıdır.
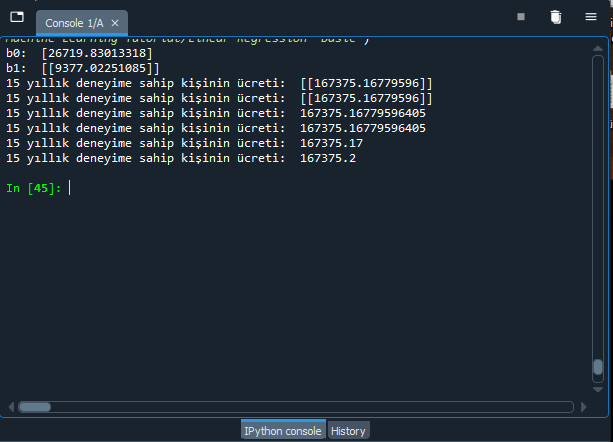
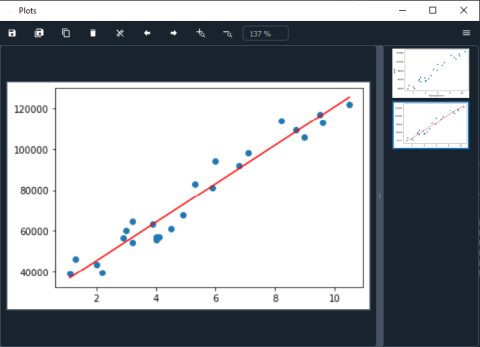
Aşağıdaki python algoritmasında ise yukarıdaki süreçlere ilave olarak determinasyon katsayısı olarak da bilinen R2 ve düzeltilmiş R2 istatistikleri hesaplanmıştır.
# -*- coding: utf-8 -*-
"""
Created on Sat Jun 18 17:09:56 2022

@author: ishakkutlu
"""

#%%
# import library
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# "C:\\" şeklinde çift yan çizgiye DİKKAT ediniz lütfen! Csv dosyamızın bulunduğu dizini tanımlıyoruz.
myTrainingFile = "C:\\Users\...\Salary_Data_Training.csv"
myLabelx ="YearsExperience"
myLabely ="Salary"

# import data (dataya df adını verdik.)
df = pd.read_csv(myTrainingFile, sep = ",") # csv dosyasının seperatorünü belirtiyoruz. Varsayılan olarak "," olur.
#csv dosyasında seperator olarak ";" kullanılıyorsa "," işaretini ";" işareti ile değiştiriniz.

# convert data (regresyon ve grafikler için datayı kolaylıkla işlenebilir olan array formatına dönüştürüyoruz.)
x = np.array(df.loc[:,myLabelx]).reshape(-1,1)
y = np.array(df.loc[:,myLabely]).reshape(-1,1)

# plot data (veriler için scatter grafiğini çiziyoruz.)
plt.scatter(x=x,y=y)
plt.xlabel(myLabelx)
plt.ylabel(myLabely)
plt.show()

#%%
# sklearn library
from sklearn.linear_model import LinearRegression

# linear regression model
reg = LinearRegression(fit_intercept=True) # ols/ekk işlemcisini reg değişkenine ata.

reg.fit(x,y) #denkleme ols/ekk uygula

y_tahmin = reg.predict(x)  # salary tahmini.

#%%
from sklearn.metrics import r2_score

# Birinci yol; from sklearn.linear_model import LinearRegression kütüphanesi ile
# R^2
r2=reg.score(x, y)
print("R^2 score: ",r2)
# Adjusted R-squared
adj_r2 = 1 - (1-r2)*(len(y)-1)/(len(y)-(x.shape[1]+1)) # sabit terim dahil edildi.
print("Adjusted R^2 score: ",adj_r2)

# İkinci yol; from sklearn.metrics import r2_score kütüphanesi ile
# R^2
print("R^2 score: ", r2_score(y,y_tahmin))
#display adjusted R-squared
adj_r2 = 1 - (1-r2_score(y,y_tahmin))*(len(y)-1)/(len(y)-x.shape[1]) # sabit terim dahil edilmedi.
print("Adjusted R^2 score: ", adj_r2)

# visualize line (train edilen X verileri ile regresyon doğrusunun çizimi)
plt.scatter(x,y)
plt.plot(x, y_tahmin,color = "red")
plt.show()
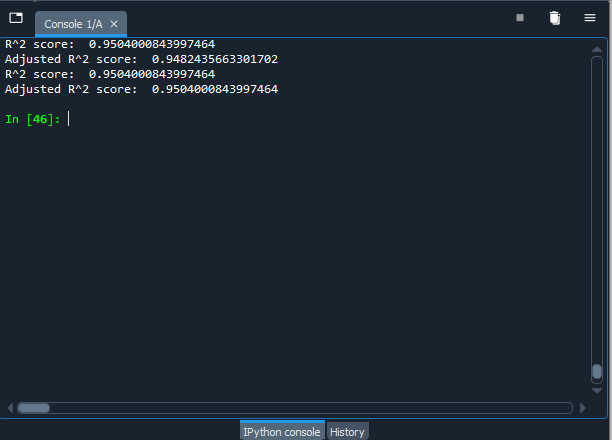
Sonuç aşağıdaki ekran görüntüsünde temsil edilmiştir.
Yukarıdaki süreçlere ilave olarak aşağıdaki algoritmada eğitim seti ile test setinin ayrıştırılmasına, sonuçların analiz edilmesine ve yukarıdaki algoritmalarda yer verilmeyen görselleştirmeye ve veri dönüştürmeye ilişkin birkaç küçük detayı bulabilirsiniz. Ayrıca aşağıdaki algoritmada regresyon tahminleri ile r2 istatistikleri bir arada sunulmuştur.
# -*- coding: utf-8 -*-
"""
Created on Sat Jun 18 17:09:56 2022

@author: ishakkutlu
"""

#%%
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

#"C:\\" şeklinde çift yan çizgiye DİKKAT ediniz lütfen! Csv dosyamızın bulunduğu dizini tanımlıyoruz.
myTrainingFile = "C:\\Users\...\Salary_Data_Training.csv"
myTestFile = "C:\\Users\izem\Desktop\Machine Learning Tutorial\Linear Regression -Basic\Salary_Data_Test.csv"
myLabelx ="YearsExperience"
myLabely ="Salary"
# Sadece yukarıdaki değişkenleri uyarlamanız yeterli olacaktır.
# Veri setinizi eğitmek için kodlarda başka herhangi bir değişiklik yapmanıza gerek yoktur.
# Modelin Y=b0+b1X1+e olduğu ve verilerin, seperatorü "," olan bir csv dosyasından çekileceği varsayılmıştır.

myTrainingData = pd.read_csv(myTrainingFile)
myTestData= pd.read_csv(myTestFile)

#print(plt.style.available) # Grafik türlerini konsola yazdır.
plt.style.use('default') # Default bir grafik türü kullanıldı.
#plt.style.use('seaborn-notebook') # Dilerseniz bunu veya print edilen isimlerden herhangi birini seçebilirsiniz.

x = np.array(myTrainingData.loc[:,myLabelx]).reshape(-1,1)
y = np.array(myTrainingData.loc[:,myLabely]).reshape(-1,1)
xTest = np.array(myTestData.loc[:,myLabelx]).reshape(-1,1)
yTest = np.array(myTestData.loc[:,myLabely]).reshape(-1,1)
# Scatter
plt.figure(figsize=[5,5]) # Grafiğin dikey ve yatay boyutunu verir.
'''
plt.scatter(x=x,y=y, color='red', alpha=0.5)
plt.xlabel(myLabelx)
plt.ylabel(myLabely)
plt.show()
'''
# Veri setinin scatter garafiğini ayrıca istiyorsanız, yukarıdaki ''' işaretlerini siliniz.

#%%
# LinearRegression
from sklearn.linear_model import LinearRegression
reg = LinearRegression(fit_intercept=True)

# Fit
reg.fit(x,y)

# Predict space
predict_space=x
# Predict
predicted = reg.predict(predict_space)
#print(predict_space)
#print(predicted)

b0 = reg.intercept_
b0 = b0[0] # Değeri 1 boyutlu arraydan çıkar.
#print("b0_: ",b0)   # y eksenini kestigi nokta intercept/sabit terim
b1 = reg.coef_
b1 = b1[0,0] # Değeri 2 boyutlu arraydan çıkar.
#print("b1: ",b1)   # slope/eğim

#b0 ve b1 değerlerini "denklem" isimli metin içinde kullanmak için stringe çevir
b0_str = str(b0)
b1_str = str(b1)
denklem="(Y_hat)_i= " + b0_str + " + " + b1_str + "(X_1)_i"
print(denklem)

# R^2
r2_score=reg.score(x, y)
print('R^2 score: ',r2_score)
# Adjusted R-squared
adj_r2 = 1 - (1-r2_score)*(len(y)-1)/(len(y)-(x.shape[1]+1))
print('Adjusted R^2 score: ',adj_r2)

# Plot regression line and scatter
plt.plot(predict_space, predicted, color='blue', linewidth=2)
plt.scatter(x=x,y=y, color='red', alpha=0.5, edgecolors='none') #alpha noktaların saydamlık derecesini verir. 1 değeri tam opak, 0 değeri tam saydamdır. edgecolors='none' noktaların etrafında kenarlık olmayacağını ifade eder.
plt.xlabel(myLabelx)
plt.ylabel(myLabely)
plt.show()

#%%
# Predict space for test
predict_test=xTest
# Predict
predicted_test = reg.predict(predict_test)
# Gerçek ile tahmin Y değerleri
print(str(yTest) +"\n" + str(predicted_test))

print("Tahmin edilen test setinin gerçek Y değerlerinden sapmaları:")
Fark=yTest-predicted_test
#İki boyutlu Fark arrayının değerlerini arraydan dışarı çıkar.
for i in range(len(xTest)):
  print (Fark[i,0])

# Plot regression line and scatter
plt.figure(figsize=[5,5]) # Grafiğin dikey ve yatay boyutunu verir.
plt.plot(predict_test, predicted_test, color='blue', linewidth=2)
plt.scatter(x=xTest,y=yTest, color='green', alpha=0.5, edgecolors='none') #alpha noktaların saydamlık derecesini verir. 1 değeri tam opak, 0 değeri tam saydamdır. edgecolors='none' noktaların etrafında kenarlık olmayacağını ifade eder.
plt.xlabel(myLabelx)
plt.ylabel(myLabely)
plt.show()
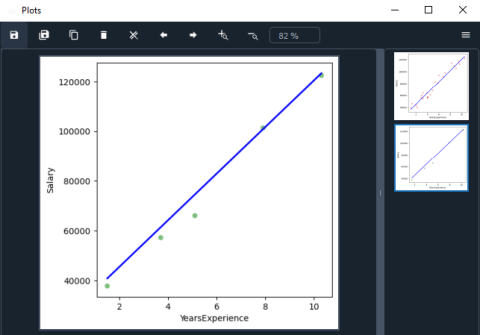
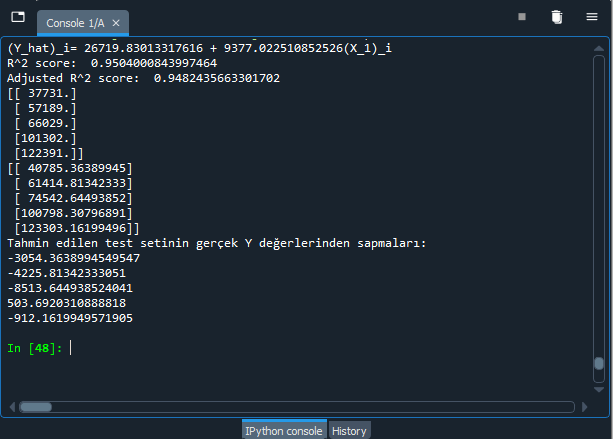
Sonuca ilişkin ekran görüntüleri aşağıdadır.
Aşağıdaki ekran görüntüsü test setinin dağılımını temsil etmektedir.